---
title: "Julkinen raha ei valehtele, osa 1: Keskiarvohankintaa ei ole olemassa"
description: "Suomen julkiset hankinnat jakaumana: miksi 'keskimääräinen hankinta' johtaa harhaan, kuinka paksu häntä on ja paljonko ensi vuonna kilpailutetaan."
author: "Kristian Vepsäläinen"
date: 2026-11-06
categories: [Hilma, julkiset hankinnat, bayes, ennustaminen, jakaumat]
lang: fi
format:
  html:
    code-fold: true
    code-summary: "Näytä koodi"
    toc: true
    toc-depth: 3
execute:
  warning: false
  message: false
  freeze: auto   # GitHub Actions käyttää paikallisesti renderöityjä tuloksia (_freeze/)
---

```{r}
#| label: setup

suppressPackageStartupMessages({
  library(tidyverse)
  library(here)
  library(qs2)
  library(brms)
  library(ggdist)
  library(patchwork)
  library(scales)
})

select <- dplyr::select
filter <- dplyr::filter

set.seed(2026)
options(mc.cores = 4)

hilma_dir  <- here("data", "hilma")
models_dir <- here("data", "hilma", "models")
dir.create(models_dir, showWarnings = FALSE, recursive = TRUE)

# Data haetaan etukäteen skriptillä R/hilma/hilma-data-prep.R. Isot taulut on
# pilkottu alle 45 Mt osiin (read_split yhdistää ne), jotta ne mahtuvat
# GitHubiin ja renderöinti toimii GitHub Actionsissa.
source(here("R", "hilma", "hilma-io.R"))

idx    <- read_split(hilma_dir, "hilma_index")
awards <- read_split(hilma_dir, "hilma_awards")
hicp   <- read_split(hilma_dir, "eurostat_hicp_fi")
gov    <- read_split(hilma_dir, "eurostat_gov_fi")

stopifnot(
  all(c("id", "source", "noticeId", "datePublished", "mainType", "estimatedValue",
        "procurementTypeCode") %in% names(idx)),
  all(c("notice_id", "lot_id", "tender_value", "lot_est_value", "issue_date",
        "result_code") %in% names(awards))
)

# --- Muotoiluapurit ------------------------------------------------------
.f <- function(x, d) formatC(x, format = "f", digits = d, big.mark = " ", decimal.mark = ",")
eur <- function(x, digits = 1) {
  case_when(
    abs(x) >= 1e9 ~ paste0(.f(x / 1e9, digits), " mrd. €"),
    abs(x) >= 1e6 ~ paste0(.f(x / 1e6, digits), " milj. €"),
    abs(x) >= 1e4 ~ paste0(.f(x / 1e3, 0), " 000 €"),
    TRUE          ~ paste0(.f(x, 0), " €")
  )
}
pct <- function(x, digits = 1) paste0(.f(100 * x, digits), " %")
num <- function(x) .f(x, 0)
fi_p <- function(p) if (p < 0.001) "< 0,001" else format(signif(p, 2), decimal.mark = ",")
stopifnot(eur(1234567) == "1,2 milj. €", eur(150000) == "150 000 €",
          eur(5400) == "5 400 €", pct(0.123) == "12,3 %")

lab_eur <- function(x) eur(x, 0)

theme_set(
  theme_minimal(base_size = 13) +
    theme(plot.title = element_text(face = "bold"),
          plot.title.position = "plot",
          panel.grid.minor = element_blank(),
          legend.position = "bottom")
)
col_nat <- c("Tavarat" = "#457b9d", "Palvelut" = "#2a9d8f",
             "Rakennusurakat" = "#f4a261", "Muu / tuntematon" = "grey60")

# Hankintalaji suomeksi (rajapinnan koodit voivat olla engl. tai suom.)
nature_fi <- function(x) {
  x <- str_to_lower(coalesce(x, ""))
  case_when(
    str_detect(x, "suppl|tavara")          ~ "Tavarat",
    str_detect(x, "serv|palvel")           ~ "Palvelut",
    str_detect(x, "work|urak|rakenn")      ~ "Rakennusurakat",
    TRUE                                   ~ "Muu / tuntematon"
  )
}
```

```{r}
#| label: data-prep

if (!"isPlan" %in% names(idx)) idx$isPlan <- FALSE

this_year  <- as.integer(format(Sys.Date(), "%Y"))
last_full  <- this_year - 1L

# Reaalieurot: kaikki summat viimeisimmän vuosikeskiarvon hintoihin
hicp_full <- tibble(year = min(hicp$year):this_year) |>
  left_join(hicp, by = "year") |>
  fill(hicp, .direction = "down")
hicp_base <- hicp_full$hicp[hicp_full$year == max(hicp$year)]
stopifnot(length(hicp_base) == 1, !any(is.na(hicp_full$hicp)))

cn_all <- idx |>
  filter(mainType == "ContractNotices", !coalesce(isPlan, FALSE)) |>
  mutate(year   = as.integer(format(datePublished, "%Y")),
         nature = nature_fi(procurementTypeCode))

# Sama hankinta voi saada useita hankintailmoituksia (esim. uudelleenjulkaisu).
# Jos indeksissä on menettelyn tunniste, pidetään ensimmäinen ilmoitus.
if ("procedureId" %in% names(cn_all)) {
  n_before <- nrow(cn_all)
  cn_all <- bind_rows(
    cn_all |> filter(is.na(procedureId) | procedureId %in% c("", "0")),
    cn_all |> filter(!is.na(procedureId), !procedureId %in% c("", "0")) |>
      arrange(datePublished) |>
      # menettelynumerot voivat toistua OLD- ja EF-lähteiden välillä
      distinct(source, procedureId, .keep_all = TRUE)
  )
  n_dupes <- n_before - nrow(cn_all)
} else {
  n_dupes <- 0
}

cn_all <- cn_all |>
  left_join(hicp_full, by = "year") |>
  mutate(value_real = estimatedValue * hicp_base / hicp,
         has_value  = !is.na(estimatedValue) & estimatedValue > 0,
         plausible  = has_value & estimatedValue >= 100 & estimatedValue <= 5e9)

# Yksilöivä avain on `id` (OLD-/EF-numerot menevät päällekkäin noticeId:ssä)
stopifnot(!anyDuplicated(cn_all$id),
          all(cn_all$year >= 2000 & cn_all$year <= this_year))

# Analyysiaineisto: täydet vuodet, uskottava arvo
cn <- cn_all |> filter(plausible, year <= last_full)
first_year <- min(cn$year)
stopifnot(nrow(cn) > 1000)
```

## Lyhyesti

- Suomessa julkaistaan vuosittain tuhansia hankintailmoituksia. Kun niiden arvot laitetaan riviin, **tyypillinen hankinta on pieni, mutta muutama jättihankinta vie suuren osan kaikista euroista.**
- Siksi lukua "keskimääräinen hankinta" ei pitäisi käyttää päätöksenteossa. Se kuvaa hankintaa, jota ei käytännössä ole olemassa.
- Rakensin kaksi bayesilaista mallia: yksi kuvaa *tavallisen* hankinnan kokoa tuoteryhmittäin ja toinen *jättihankintojen hännän* paksuutta. Niiden pohjalta ennustan, paljonko Suomessa kilpailutetaan vuonna `r last_full + 2`, ja tarkistan ennustustavan toimivuuden menneellä vuodella.
- Vertaan myös, kuinka paljon voittanut tarjous poikkesi hankintayksikön omasta arviosta, ja mitä se tarkoittaa budjettivarauksille.

## Miksi tämä aihe?

Julkiset hankinnat ovat yksi suurimmista rahavirroista, joihin veronmaksaja voi suoraan kurkistaa. Jokainen kunta, hyvinvointialue, virasto ja valtionyhtiö julkaisee kansalliset kynnysarvot ylittävät hankintansa **Hilma**-palvelussa (hankintailmoitukset.fi). Hilman ylläpitäjä Hansel avaa ilmoitukset maksuttomana avoimena datana, jota saa käyttää myös kaupallisesti.

Julkisessa keskustelussa hankinnoista puhutaan lähes aina yhdellä luvulla: "hankintoja tehdään vuosittain noin 35 miljardilla eurolla" tai "keskimääräinen hankinta on N euroa". Tämän sarjan perusajatus on, että **maailma on jakauma**. Yksi luku kertoo hyvin vähän, jos ei tiedä, miten luvut jakautuvat sen ympärille.

Tässä ensimmäisessä osassa vastaan kolmeen kysymykseen:

1. Miltä Suomen julkisten hankintojen kokojakauma näyttää?
2. Miksi keskiarvo johtaa harhaan, ja kuinka pahasti?
3. Voiko ensi vuoden hankintavolyymin ennustaa, ja kuinka epävarma ennuste on?

## Aineisto ja sen laatu

Aineisto on haettu Hilman avoimesta rajapinnasta. Mukana on kaksi tasoa:

- **Hakuindeksi.** Siinä on jokaisen Hilmassa julkaistun ilmoituksen perustiedot vuodesta `r first_year` lähtien: julkaisupäivä, hankintayksikkö, tuoteluokka (CPV-koodi), hankintalaji ja **hankintayksikön oma arvio hankinnan arvosta**.
- **Täydet eForms-ilmoitukset.** eForms on EU:n yhteinen sähköinen ilmoitusmuoto, joka otettiin Suomessa käyttöön vuonna 2023. Näistä ilmoituksista saadaan myös **voittaneen tarjouksen arvo**, tarjousten määrä ja voittajan tiedot.

::: {.callout-tip title="Sanasto"}
- **Hankintailmoitus**: ilmoitus, jolla julkinen ostaja (*hankintayksikkö*) pyytää yrityksiltä tarjouksia.
- **Jälki-ilmoitus**: ilmoitus siitä, kuka kilpailutuksen voitti ja millä hinnalla.
- **Arvioitu arvo**: hankintayksikön oma etukäteisarvio siitä, paljonko koko sopimus maksaa koko sopimuskaudelta optioineen. Se ei ole vuosittainen kulu.
- **Reaalieuro**: summa, josta hintojen nousu on poistettu. Kaikki tämän kirjoituksen eurot on muutettu vuoden `r max(hicp$year)` rahaksi Eurostatin kuluttajahintaindeksillä (HICP), jotta eri vuosia voi verrata keskenään.
:::

Ennen analyysia tarkistin, mitä aineistossa on ja mitä siitä puuttuu. Tämä vaihe kertoo usein jo itsessään jotain olennaista.

```{r}
#| label: quality

q_year <- cn_all |>
  filter(year <= last_full) |>
  group_by(year) |>
  summarise(n = n(),
            share_value     = mean(has_value),
            share_plausible = mean(plausible),
            .groups = "drop")

n_tiny  <- sum(cn_all$has_value & cn_all$estimatedValue < 100 & cn_all$year <= last_full)
n_huge  <- sum(cn_all$has_value & cn_all$estimatedValue > 5e9 & cn_all$year <= last_full)
share_missing_all <- 1 - mean(cn_all$has_value[cn_all$year <= last_full])

# Pyöreät luvut: osuus arvoista, jotka ovat tasan 10 000 tai 100 000 euron monikertoja
round_shares <- cn |>
  summarise(r10k  = mean(estimatedValue %% 1e4 == 0),
            r100k = mean(estimatedValue %% 1e5 == 0),
            r1m   = mean(estimatedValue %% 1e6 == 0))
```

```{r}
#| label: fig-quality
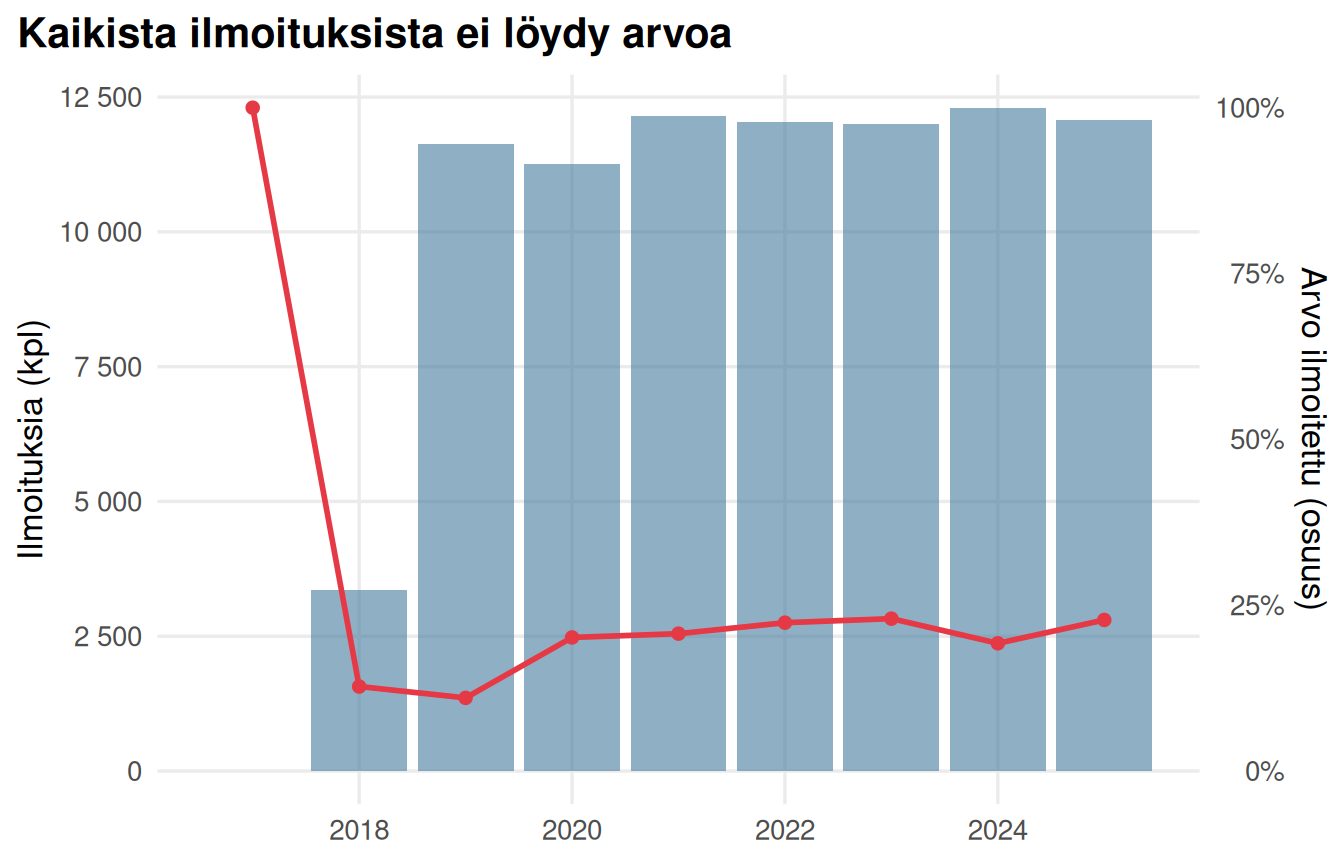
#| fig-cap: "Hankintailmoitusten määrä vuosittain (pylväät) ja niiden ilmoitusten osuus, joissa on käyttökelpoinen arvio hankinnan arvosta (viiva)."
#| fig-height: 4.5

scale_k <- max(q_year$n)
ggplot(q_year, aes(year)) +
  geom_col(aes(y = n), fill = "#457b9d", alpha = 0.6) +
  geom_line(aes(y = share_plausible * scale_k), colour = "#e63946", linewidth = 1) +
  geom_point(aes(y = share_plausible * scale_k), colour = "#e63946") +
  scale_y_continuous("Ilmoituksia (kpl)", labels = label_number(big.mark = " "),
                     sec.axis = sec_axis(~ . / scale_k, name = "Arvo ilmoitettu (osuus)",
                                         labels = label_percent())) +
  labs(x = NULL, title = "Kaikista ilmoituksista ei löydy arvoa")
```

**Kuvan lukuohje.** Siniset pylväät kertovat, montako hankintailmoitusta kunakin vuonna julkaistiin; asteikko on vasemmalla. Punainen viiva kertoo, kuinka suuressa osassa ilmoituksista on käyttökelpoinen arvio hankinnan hinnasta; asteikko on oikealla prosentteina. Mitä korkeammalla viiva on, sitä paremmin tiedämme, mihin rahaa ollaan käyttämässä.

Havaintoja aineiston laadusta:

- Koko jaksolla **`r pct(share_missing_all)` hankintailmoituksista ei kerro arvoa ollenkaan**. Arvon ilmoittaminen ei ole kaikissa ilmoitustyypeissä pakollista. Tämä tarkoittaa, että kaikki alla olevat summat ovat **alarajoja**.
- `r num(n_tiny)` ilmoituksessa arvo on alle 100 euroa, esimerkiksi 1 euro. Nämä ovat käytännössä paikkamerkkejä, eivät oikeita arvioita. `r num(n_huge)` ilmoituksessa arvo ylittää 5 miljardia euroa, mikä viittaa lähes varmasti näppäilyvirheeseen. Molemmat ryhmät on jätetty pois analyysista.
- Arvioiden pyöreys on silmiinpistävää: **`r pct(round_shares$r10k)` arvioista on tasan 10 000 euron monikerta** ja `r pct(round_shares$r100k)` tasan 100 000 euron monikerta. Jos arviot olisi laskettu tarkasti, tasalukuja olisi murto-osa tästä. Arvioitu arvo on siis usein **karkea haarukka, ei laskelma**, ja se on hyvä muistaa aina, kun arvioita käytetään budjetoinnissa.
`r if (n_dupes > 0) paste0("- Saman hankintamenettelyn ilmoituksista pidettiin vain ensimmäinen, jolloin aineistosta poistui ", num(n_dupes), " päällekkäistä ilmoitusta.") else ""`

## Mistä keskiarvo valehtelee

```{r}
#| label: dist-stats

recent <- cn |> filter(year >= last_full - 2)       # viimeiset kolme täyttä vuotta
v <- recent$value_real

stats <- tibble(
  n       = length(v),
  mean    = mean(v),
  median  = median(v),
  q10     = quantile(v, 0.10),
  q90     = quantile(v, 0.90),
  q99     = quantile(v, 0.99),
  total   = sum(v),
  top1    = sum(sort(v, decreasing = TRUE)[seq_len(ceiling(0.01 * length(v)))]) / sum(v),
  top10   = sum(sort(v, decreasing = TRUE)[seq_len(ceiling(0.10 * length(v)))]) / sum(v),
  bottom50 = sum(sort(v)[seq_len(floor(0.5 * length(v)))]) / sum(v),
  share_below_mean = mean(v < mean(v))
)
stopifnot(stats$median < stats$mean)   # oikealle vino, kuten odotettu
```

Tarkastelen kolmea viimeisintä täyttä vuotta (`r last_full - 2`–`r last_full`). Niiltä on `r num(stats$n)` hankintailmoitusta, joissa on käyttökelpoinen arvio.

| Tunnusluku | Arvo |
|---|---|
| Keskiarvo | `r eur(stats$mean)` |
| Mediaani (puolet hankinnoista on tätä pienempiä) | `r eur(stats$median)` |
| Pienin kymmenesosa jää alle | `r eur(stats$q10)` |
| Suurin kymmenesosa ylittää | `r eur(stats$q90)` |
| Suurin prosentti ylittää | `r eur(stats$q99)` |
| Keskiarvoa pienempien hankintojen osuus | `r pct(stats$share_below_mean)` |
| Suurimman 1 %:n osuus kaikista euroista | `r pct(stats$top1)` |
| Suurimman 10 %:n osuus kaikista euroista | `r pct(stats$top10)` |
| Pienemmän puolikkaan osuus kaikista euroista | `r pct(stats$bottom50)` |

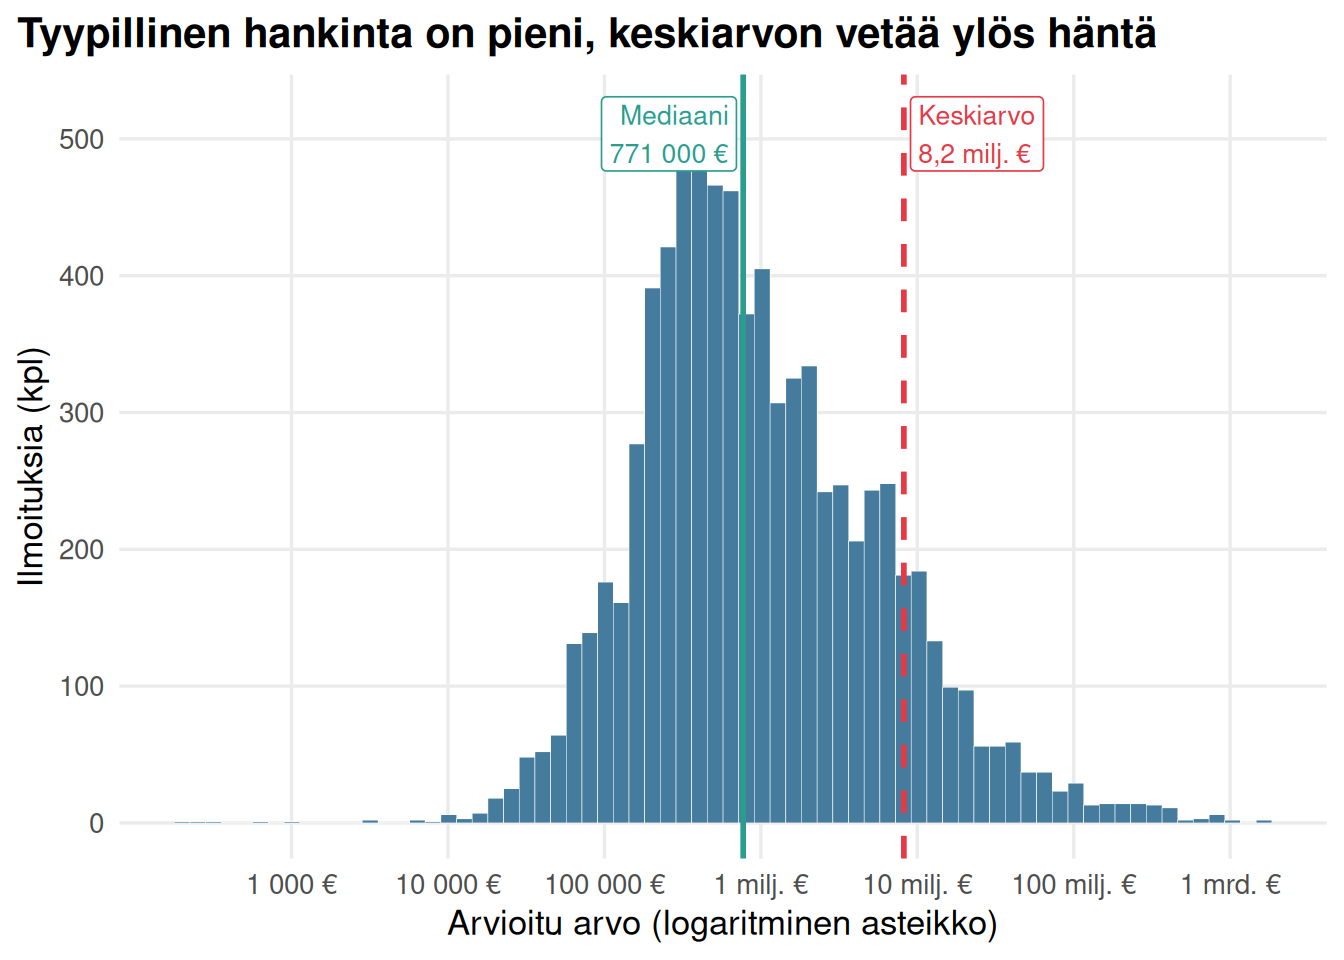
Taulukko kertoo koko tarinan pähkinänkuoressa. **Keskiarvo on noin `r round(stats$mean / stats$median)`-kertainen mediaaniin verrattuna, ja `r pct(stats$share_below_mean, 0)` hankinnoista jää keskiarvon alle.** Jos joku sanoo, että "tyypillinen hankinta on `r eur(stats$mean, 0)`", hän kuvaa hankintaa, jota suurempia on vain noin joka `r round(1 / (1 - stats$share_below_mean))`. ilmoitus.

Syy on se, että suurin prosentti hankinnoista kattaa `r pct(stats$top1, 0)` kaikista euroista, kun taas pienempi puolikas, siis valtaosa kunnista ja virastoista tavallisena arkipäivänä, kattaa vain `r pct(stats$bottom50)`.

```{r}
#| label: fig-hist
#| fig-cap: "Hankintailmoitusten arvioitujen arvojen jakauma kolmelta viimeisimmältä täydeltä vuodelta logaritmisella asteikolla."
#| fig-height: 5

ggplot(recent, aes(value_real)) +
  geom_histogram(bins = 70, fill = "#457b9d", colour = "white", linewidth = 0.1) +
  geom_vline(xintercept = stats$median, colour = "#2a9d8f", linewidth = 1) +
  geom_vline(xintercept = stats$mean, colour = "#e63946", linewidth = 1, linetype = 2) +
  annotate("label", x = stats$median, y = Inf, vjust = 1.3, hjust = 1.05,
           label = paste0("Mediaani\n", eur(stats$median)), colour = "#2a9d8f", size = 3.5) +
  annotate("label", x = stats$mean, y = Inf, vjust = 1.3, hjust = -0.05,
           label = paste0("Keskiarvo\n", eur(stats$mean)), colour = "#e63946", size = 3.5) +
  scale_x_log10(labels = lab_eur, breaks = 10^(3:9)) +
  scale_y_continuous(labels = label_number(big.mark = " ")) +
  labs(x = "Arvioitu arvo (logaritminen asteikko)", y = "Ilmoituksia (kpl)",
       title = "Tyypillinen hankinta on pieni, keskiarvon vetää ylös häntä")
```

**Kuvan lukuohje.** Vaaka-akseli on *logaritminen*. Jokainen merkitty askel oikealle on **kymmenkertainen** summa: tuhat, kymmenentuhatta, satatuhatta ja niin edelleen. Ilman tätä temppua lähes kaikki pylväät olisivat yhtenä kasana vasemmassa reunassa, koska suurimmat hankinnat ovat satoja kertoja tavallisia suurempia. Pylvään korkeus kertoo, montako ilmoitusta osui kyseiseen kokoluokkaan. Vihreä viiva on mediaani eli "keskimmäinen" hankinta, punainen katkoviiva keskiarvo. Keskiarvo on reilusti mediaanin oikealla puolella, koska muutama jättihankinta vetää sitä mukanaan.

```{r}
#| label: fig-lorenz
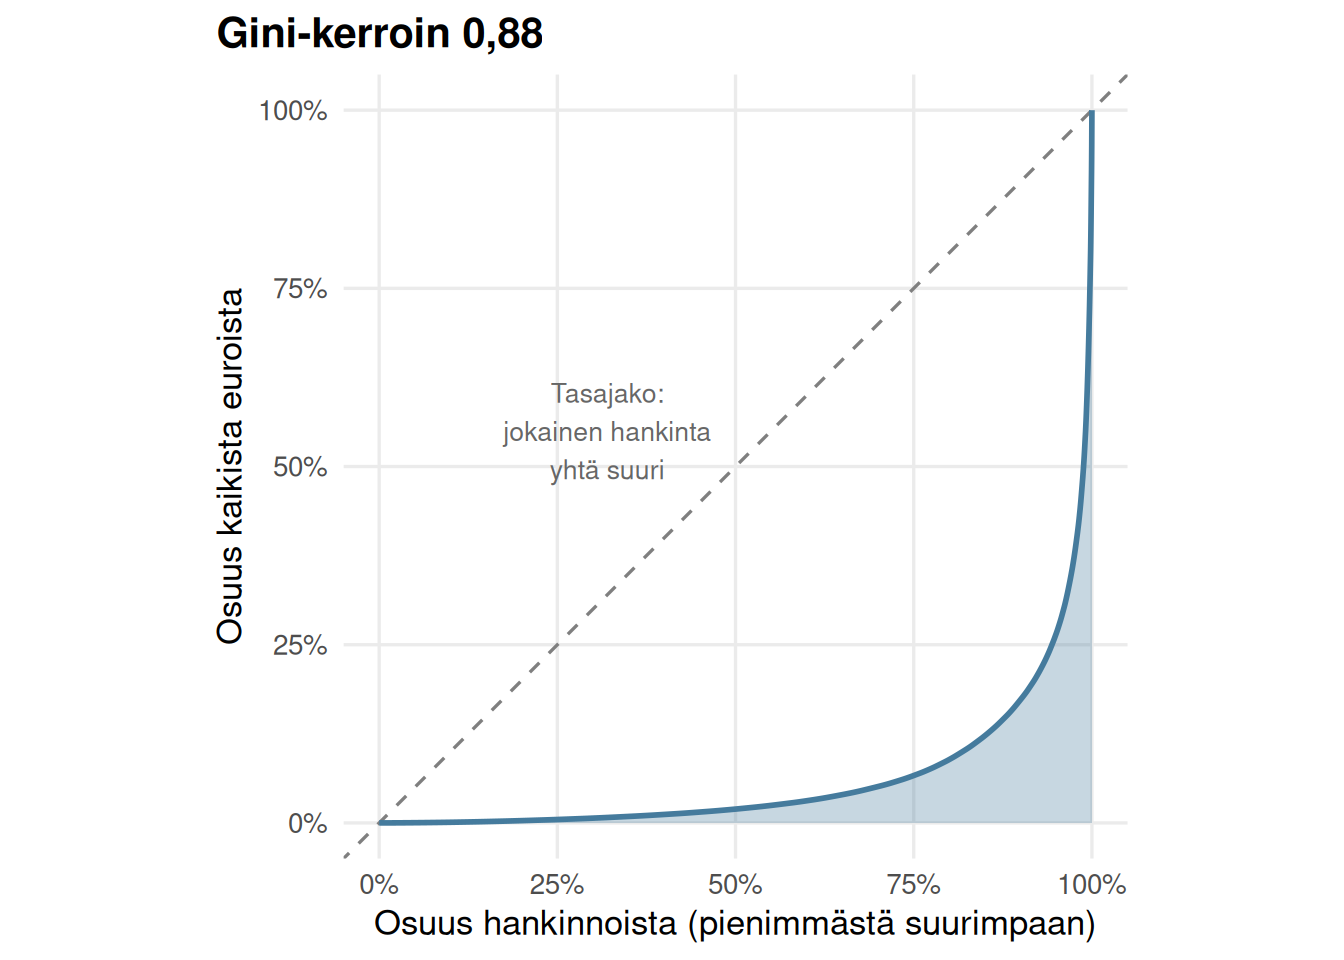
#| fig-cap: "Lorenz-käyrä: kuinka suuri osa euroista kertyy pienimmistä hankinnoista, kun hankinnat järjestetään pienimmästä suurimpaan."
#| fig-height: 5

lor <- recent |>
  arrange(value_real) |>
  mutate(cum_n = row_number() / n(), cum_eur = cumsum(value_real) / sum(value_real))
gini <- 1 - 2 * mean(lor$cum_eur) + 1 / nrow(lor)

ggplot(lor, aes(cum_n, cum_eur)) +
  geom_abline(linetype = 2, colour = "grey50") +
  geom_area(fill = "#457b9d", alpha = 0.3) +
  geom_line(colour = "#457b9d", linewidth = 1) +
  annotate("text", x = 0.32, y = 0.55, label = "Tasajako:\njokainen hankinta\nyhtä suuri",
           colour = "grey40", size = 3.5) +
  scale_x_continuous(labels = label_percent()) +
  scale_y_continuous(labels = label_percent()) +
  coord_equal() +
  labs(x = "Osuus hankinnoista (pienimmästä suurimpaan)",
       y = "Osuus kaikista euroista",
       title = paste0("Gini-kerroin ", format(round(gini, 2), decimal.mark = ",")))
```

**Kuvan lukuohje.** Kuvitellaan, että kaikki hankinnat asetetaan jonoon pienimmästä suurimpaan. Vaaka-akseli kertoo, kuinka pitkälle jonossa ollaan edetty, ja pystyakseli, kuinka suuri osa kaikista euroista on siihen mennessä kertynyt. Jos kaikki hankinnat olisivat yhtä suuria, käyrä kulkisi katkoviivaa pitkin. Mitä syvemmälle käyrä painuu, sitä epätasaisemmin eurot jakautuvat. **Gini-kerroin** tiivistää tämän yhteen lukuun: 0 tarkoittaa täysin tasaista ja 1 sitä, että yksi hankinta vie kaiken. Suomen hankintojen Gini on `r format(round(gini, 2), decimal.mark = ",")`. Vertailun vuoksi suomalaisten tuloerojen Gini on noin 0,27.

::: {.callout-note title="Faktalaatikko: Yrityskoot ja hankintakoot noudattavat samaa lakia"}
Taloustieteilijä Robert Axtell osoitti *Science*-lehdessä (2001), että Yhdysvaltain kaikkien yritysten kokojakauma noudattaa niin sanottua **Zipfin lakia**. Se on paksuhäntäinen jakauma, jossa jättiyrityksiä on paljon enemmän kuin "normaali" kellokäyrä antaisi odottaa. Julkiset hankinnat ovat kauppaa näiden yritysten kanssa, joten on luontevaa, että hankintojen koot muistuttavat yritysten kokoja.

**Vastaskenaario: entä jos hankinnat olisivat kellokäyrällä?** Alla lasken, mitä Suomen hankinnoista seuraisi, jos ne noudattaisivat kahta yleisesti oletettua jakaumaa, joilla on täsmälleen sama keskiarvo tai mediaani kuin todellisuudessa.
:::

```{r}
#| label: cf-normal-world

mu_v <- mean(v); sd_v <- sd(v)
p_negative_normal <- pnorm(0, mu_v, sd_v)

# Lognormaali: sama mediaani ja log-hajonta kuin todellisuudessa
ml <- mean(log(v)); sl <- sd(log(v))
top1_share <- function(x) { x <- sort(x, decreasing = TRUE); sum(x[seq_len(ceiling(0.01 * length(x)))]) / sum(x) }
sim_top1_ln <- replicate(200, top1_share(rlnorm(length(v), ml, sl)))
sim_top1_norm <- replicate(200, { x <- rnorm(length(v), mu_v, sd_v); x <- x[x > 0]; top1_share(x) })

cf_world <- tibble(
  Maailma = c("Todellisuus (Hilma)", "Lognormaali (sama mediaani ja log-hajonta)",
              "Normaalijakauma (sama keskiarvo ja hajonta)"),
  `Suurimman 1 %:n osuus euroista` = c(pct(stats$top1),
                                       paste0(pct(median(sim_top1_ln)), " (", pct(quantile(sim_top1_ln, .05)), "–", pct(quantile(sim_top1_ln, .95)), ")"),
                                       paste0(pct(median(sim_top1_norm)), " (", pct(quantile(sim_top1_norm, .05)), "–", pct(quantile(sim_top1_norm, .95)), ")")),
  `Negatiivisten hankintojen osuus` = c("0 %", "0 %", pct(p_negative_normal))
)
knitr::kable(cf_world)
```

Vastaskenaario paljastaa kaksi asiaa. Jos hankintoja kuvattaisiin tavallisella kellokäyrällä keskiarvon ja keskihajonnan avulla, **`r pct(p_negative_normal, 0)` hankinnoista pitäisi olla negatiivisen suuruisia**. Se on mahdotonta, ja juuri siksi "keskiarvo plus–miinus hajonta" on näille luvuille väärä työkalu. Lognormaali jakauma, jossa luvun *logaritmi* on kellokäyrällä, pääsee todellisuutta lähemmäs. `r if (stats$top1 > quantile(sim_top1_ln, .95)) "Silti todellinen häntä on vielä sitäkin paksumpi: suurimman prosentin osuus euroista on todellisuudessa suurempi kuin yksikään lognormaalisimulaatio tuotti. Siksi häntä tarvitsee oman mallinsa." else "Lognormaali kuvaa tämän tunnusluvun osalta todellisuutta kohtuullisesti, mutta hännän tarkempi tarkastelu on silti tarpeen."`

## Kuinka paksu häntä on? Bayesilainen häntämalli

"Paksu häntä" tarkoittaa, että poikkeuksellisen suuret hankinnat eivät ole niin harvinaisia kuin tavanomainen intuitio odottaisi. Tilastotieteessä tällaista häntää kuvataan usein **Pareto-jakaumalla**. Sen tärkein luku on **hännän paksuutta kuvaava kerroin α (alfa)**:

- Mitä *pienempi* α on, sitä paksumpi häntä ja sitä useammin tulee jättiläisiä.
- **Jos α on alle 2**, keskihajonta on teoriassa ääretön. Käytännössä se tarkoittaa, että aineiston hajonta riippuu siitä, osuiko otokseen sattumalta jättiläinen vai ei.
- **Jos α on alle 1**, myös keskiarvo on epävakaa: yksi uusi hankinta voi muuttaa sitä merkittävästi.

**Miksi bayesilainen menetelmä?** Haluan tietää, *kuinka varmoja* voimme olla α:n arvosta, emme pelkästään parasta arvausta. Bayesilainen menetelmä tuottaa juuri tämän: **todennäköisyysjakauman** α:n mahdollisille arvoille. Siitä voi lukea suoraan esimerkiksi todennäköisyyden sille, että α on alle 2. Pareto-mallille laskenta on poikkeuksellisen läpinäkyvää, koska tulos saadaan suljetussa muodossa ilman simulointia. Lähtöoletukseksi (*priori*) valitsin väljän gamma-jakauman, jonka keskiarvo on 1. Se on niin laaja, että aineisto määrää tuloksen käytännössä kokonaan.

Häntä pitää myös rajata: mistä kohtaa "suuret" hankinnat alkavat? Tähän ei ole yhtä oikeaa vastausta, joten tein laskelman viidellä eri rajalla. Jos tulos pysyy samana rajasta riippumatta, siihen voi luottaa enemmän.

```{r}
#| label: pareto

pareto_post <- function(x, q, a0 = 1, b0 = 1) {
  u  <- unname(quantile(x, q))
  xt <- x[x > u]
  tibble(q = q, u = u, n_tail = length(xt),
         shape = a0 + length(xt), rate = b0 + sum(log(xt / u)))
}

qs_grid <- c(0.80, 0.85, 0.90, 0.95, 0.975)

tail_tbl <- recent |>
  filter(nature != "Muu / tuntematon") |>
  bind_rows(recent |> mutate(nature = "Kaikki")) |>
  group_by(nature) |>
  group_modify(\(d, k) map_dfr(qs_grid, \(q) pareto_post(d$value_real, q))) |>
  ungroup() |>
  mutate(alpha_med = qgamma(0.5, shape, rate),
         alpha_lo  = qgamma(0.05, shape, rate),
         alpha_hi  = qgamma(0.95, shape, rate),
         p_lt2     = pgamma(2, shape, rate),
         p_lt1     = pgamma(1, shape, rate))

stopifnot(all(tail_tbl$n_tail >= 20), all(tail_tbl$alpha_med > 0))
main_tail <- tail_tbl |> filter(nature == "Kaikki", q == 0.90)
```

```{r}
#| label: fig-alpha
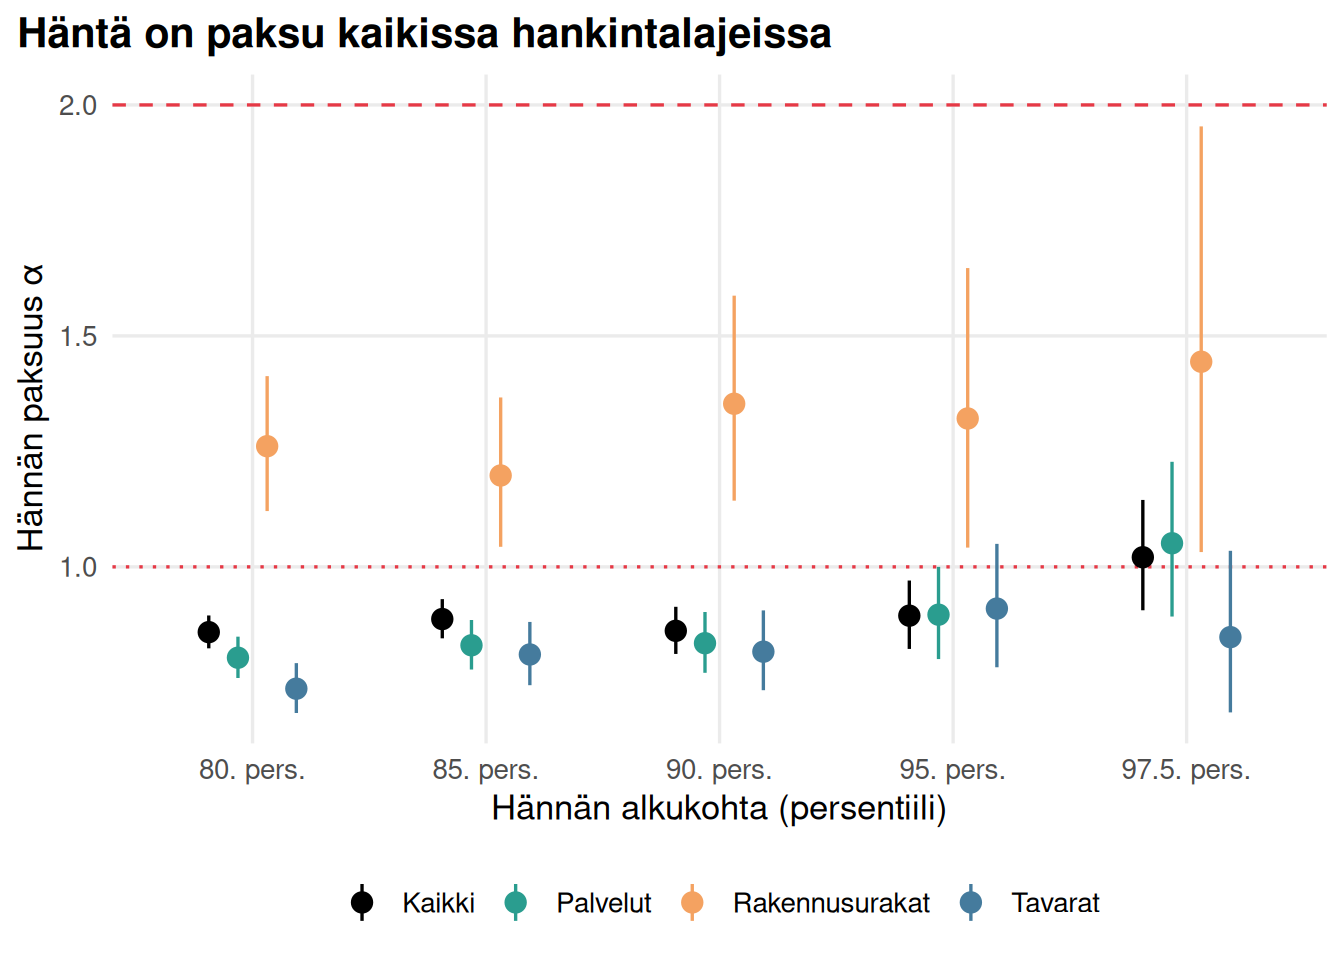
#| fig-cap: "Hännän paksuuskertoimen α posteriorijakauma (90 %:n väli) hankintalajeittain viidellä eri hännän rajalla. Punainen katkoviiva α = 2 on raja, jonka alapuolella hajonta on teoriassa ääretön."
#| fig-height: 5

ggplot(tail_tbl, aes(x = factor(paste0(q * 100, ". pers.")), y = alpha_med, colour = nature)) +
  geom_hline(yintercept = 2, linetype = 2, colour = "#e63946") +
  geom_hline(yintercept = 1, linetype = 3, colour = "#e63946") +
  geom_pointrange(aes(ymin = alpha_lo, ymax = alpha_hi),
                  position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = c(col_nat, "Kaikki" = "black"), name = NULL) +
  labs(x = "Hännän alkukohta (persentiili)", y = "Hännän paksuus α",
       title = "Häntä on paksu kaikissa hankintalajeissa")
```

**Kuvan lukuohje.** Jokainen pystyviiva on yhden laskelman tulos. Piste on todennäköisin α:n arvo, ja viiva kattaa välin, jolla α on 90 prosentin todennäköisyydellä. Vaaka-akselilla on hännän alkukohta: "90 %" tarkoittaa, että häntään luetaan suurin kymmenesosa hankinnoista. Punainen katkoviiva on α = 2 ja pisteviiva α = 1. Kun pisteet ovat lähellä näitä viivoja tai niiden alapuolella, häntä on *erittäin* paksu.

Kun häntään luetaan suurin kymmenesosa kaikista hankinnoista, α on todennäköisimmin **`r format(round(main_tail$alpha_med, 2), decimal.mark = ",")`** (90 %:n väli `r format(round(main_tail$alpha_lo, 2), decimal.mark = ",")`–`r format(round(main_tail$alpha_hi, 2), decimal.mark = ",")`). Todennäköisyys sille, että α on alle 2, on `r pct(main_tail$p_lt2, 0)`, ja sille, että se on alle 1, `r pct(main_tail$p_lt1, 0)`.

Käytännössä tämä tarkoittaa, että **hankintojen keskihajonta on käyttökelvoton luku**. Se heiluu sen mukaan, osuuko vuodelle sattumalta jokin jättihankinta. Rehellisesti on myös sanottava, että tulos riippuu jonkin verran siitä, mistä kohtaa häntä katsotaan alkavaksi. Tämä on tyypillistä aidoille paksuhäntäisille aineistoille, ja siksi raportoin kaikki viisi rajaa enkä valikoi niistä mieluisinta.

```{r}
#| label: tail-compare

# Onko rakennusurakoiden häntä paksumpi kuin palvelujen? (90 %:n raja)
draw_alpha <- function(nat, n = 20000) {
  r <- tail_tbl |> filter(nature == nat, q == 0.90)
  rgamma(n, r$shape, r$rate)
}
p_works_heavier_serv  <- mean(draw_alpha("Rakennusurakat") < draw_alpha("Palvelut"))
p_works_heavier_suppl <- mean(draw_alpha("Rakennusurakat") < draw_alpha("Tavarat"))
p_serv_heavier_suppl  <- mean(draw_alpha("Palvelut") < draw_alpha("Tavarat"))
```

Bayesilainen malli antaa myös vastauksen vertailukysymyksiin todennäköisyyksinä. Kun hännän rajana on 90. persentiili, todennäköisyys sille, että rakennusurakoiden häntä on paksumpi kuin palvelujen, on `r pct(p_works_heavier_serv, 0)`. Vastaava todennäköisyys rakennusurakoille tavaroihin verrattuna on `r pct(p_works_heavier_suppl, 0)`, ja palveluille tavaroihin verrattuna `r pct(p_serv_heavier_suppl, 0)`.

## Eroavatko hankintalajit toisistaan tilastollisesti?

Hankintayksiköt ostavat kolmenlaista: **tavaroita** (esimerkiksi lääkkeitä, ajoneuvoja ja tietokoneita), **palveluja** (esimerkiksi siivousta, IT-palveluja ja kuljetuksia) ja **rakennusurakoita**. Onko näiden ryhmien hankintakoko aidosti erilainen, vai voisivatko havaitut erot olla sattumaa?

**Testin valinta ja perustelu.** Tavanomainen keskiarvojen vertailu (t-testi tai varianssianalyysi) olettaa, että luvut ovat suunnilleen kellokäyrällä ja että ryhmien hajonnat ovat samankaltaiset. Kumpikaan oletus ei päde, kuten edellä nähtiin. Siksi käytin **Kruskalin–Wallisin testiä**. Se ei vertaa euromääriä suoraan, vaan hankintojen *järjestystä*: jos laitamme kaikki hankinnat kokojärjestykseen, sijoittuvatko jonkin ryhmän hankinnat järjestelmällisesti korkeammalle? Jättihankinnat eivät pääse vääristämään tällaista testiä. Parittaisissa vertailuissa käytin **Wilcoxonin–Mannin–Whitneyn testiä** ja korjasin p-arvot **Holmin menetelmällä**. Korjaus tarvitaan, koska kun testejä tehdään useita, jokin niistä näyttää helposti "merkitsevältä" pelkän sattuman vuoksi.

**Miksi pelkkä p-arvo ei riitä.** Kun havaintoja on tuhansia, pienikin ero on "tilastollisesti merkitsevä". Siksi raportoin myös **vaikutuksen koon**, joka kertoo, kuinka *suuri* ero on. Käytin Cliffin deltaa. Se vastaa kysymykseen, kuinka paljon todennäköisemmin satunnainen A-ryhmän hankinta on suurempi kuin satunnainen B-ryhmän hankinta kuin päinvastoin. Delta 0 tarkoittaa, että eroa ei ole, ja delta 1 sitä, että jokainen A on suurempi kuin jokainen B. Karkeasti luokiteltuna alle 0,15 on pieni ero, 0,15–0,33 kohtalainen, 0,33–0,47 suuri ja sitä suurempi erittäin suuri.

```{r}
#| label: tests-nature

d_test <- recent |> filter(nature != "Muu / tuntematon") |>
  mutate(nature = factor(nature, levels = c("Tavarat", "Palvelut", "Rakennusurakat")))

kw <- kruskal.test(value_real ~ nature, data = d_test)
eps2 <- unname(kw$statistic) / (nrow(d_test) - 1)       # epsilon^2-vaikutuksen koko

cliff <- function(a, b) {
  # Cliffin delta Mannin–Whitneyn U:sta; as.numeric estää kokonaislukuylivuodon
  u <- suppressWarnings(wilcox.test(a, b, exact = FALSE)$statistic)
  2 * as.numeric(u) / (as.numeric(length(a)) * as.numeric(length(b))) - 1
}
pairs <- combn(levels(d_test$nature), 2, simplify = FALSE)
pw <- map_dfr(pairs, function(p) {
  a <- d_test$value_real[d_test$nature == p[1]]
  b <- d_test$value_real[d_test$nature == p[2]]
  tibble(A = p[1], B = p[2],
         `Mediaani A` = eur(median(a)), `Mediaani B` = eur(median(b)),
         p_raw = wilcox.test(a, b, exact = FALSE)$p.value,
         `Cliffin delta (A vs B)` = round(cliff(a, b), 2))
}) |>
  mutate(`p (Holm)` = map_chr(p.adjust(p_raw, "holm"), fi_p)) |>
  select(-p_raw)

stopifnot(all(abs(pw$`Cliffin delta (A vs B)`) <= 1))
knitr::kable(pw)
```

Kruskalin–Wallisin testin tulos on H = `r format(round(kw$statistic), big.mark = " ")`, p `r fi_p(kw$p.value)`. Ryhmät eroavat siis tilastollisesti merkitsevästi. Vaikutuksen koko on kuitenkin ε² = `r format(round(eps2, 3), decimal.mark = ",")`, eli **hankintalaji selittää vain noin `r pct(eps2, 0)` hankintojen kokojärjestyksen vaihtelusta**. Hankintalajin sisäinen vaihtelu on siis moninkertainen lajien väliseen eroon verrattuna. Päättäjälle tämä tarkoittaa, että "rakennushankkeet ovat isoja ja tavarahankinnat pieniä" pitää paikkansa vain keskimäärin. Yksittäisestä hankinnasta lajin perusteella ei voi päätellä juuri mitään.

## Tavallisen hankinnan malli: mitä seuraava hankinta todennäköisesti maksaa?

Häntämalli kertoo jättiläisistä. Useimmat yritykset ja hankintayksiköt tarvitsevat kuitenkin vastauksen arkisempaan kysymykseen: **jos tuoteluokassa X julkaistaan seuraava kilpailutus, minkä kokoinen se todennäköisesti on?**

Tähän rakensin **hierarkkisen bayesilaisen mallin** toteutuneista sopimusarvoista. Se perustuu eForms-jälki-ilmoituksiin, joissa voittanut tarjous on ilmoitettu euroina.

- **Hierarkkinen** tarkoittaa, että tuoteluokat (CPV-pääryhmät, esimerkiksi "IT-palvelut" tai "rakennustyöt") saavat kukin oman arvionsa, mutta ne "lainaavat voimaa" toisiltaan. Pienessä tuoteluokassa, jossa on vain kourallinen hankintoja, arvio vedetään maltillisesti kohti kaikkien luokkien yhteistä tasoa. Näin vähäinen data ei tuota villejä arvioita. Isossa luokassa luokan oma data määrää lopputuloksen.
- Malli olettaa, että sopimusarvon logaritmi on kellokäyrällä (**lognormaali malli**) ja että myös hajonta saa vaihdella tuoteluokittain. Esimerkiksi lääkehankinnat voivat vaihdella kooltaan paljon enemmän kuin painotuotteet.

```{r}
#| label: ln-data

# Yksi voittaja per osa: puitejärjestelyissä usean voittajan arvot ovat
# usein koko järjestelyn enimmäisarvoja eivätkä kunkin voittajan osuuksia.
single <- awards |>
  add_count(notice_id, lot_id, name = "n_winners") |>
  filter(n_winners == 1, !is.na(tender_value), tender_value >= 100, tender_value <= 5e9) |>
  mutate(year   = as.integer(format(issue_date, "%Y")),
         nature = nature_fi(coalesce(lot_nature, contract_nature)),
         cpv2   = str_sub(coalesce(lot_cpv, cpv_main), 1, 2)) |>
  filter(nature != "Muu / tuntematon", !is.na(cpv2), !is.na(year)) |>
  left_join(hicp_full, by = "year") |>
  mutate(value_real = tender_value * hicp_base / hicp)

stopifnot(nrow(single) > 500, !any(is.na(single$value_real)))

cpv_names <- c(
  "03" = "Maatalous- ja metsätuotteet", "09" = "Polttoaineet ja energia",
  "14" = "Kaivostuotteet", "15" = "Elintarvikkeet", "16" = "Maatalouskoneet",
  "18" = "Vaatteet ja jalkineet", "19" = "Nahka- ja tekstiilit", "22" = "Painotuotteet",
  "24" = "Kemikaalit", "30" = "Toimistokoneet ja tietokoneet", "31" = "Sähkölaitteet",
  "32" = "Tietoliikennelaitteet", "33" = "Lääkinnälliset laitteet ja lääkkeet",
  "34" = "Kulkuneuvot", "35" = "Turvallisuus- ja puolustusvarusteet",
  "37" = "Urheilu- ja vapaa-ajan välineet", "38" = "Laboratoriolaitteet",
  "39" = "Kalusteet ja kodintarvikkeet", "41" = "Vesi", "42" = "Teollisuuskoneet",
  "43" = "Kaivos- ja rakennuskoneet", "44" = "Rakennustarvikkeet",
  "45" = "Rakennustyöt", "48" = "Ohjelmistot", "50" = "Korjaus ja huolto",
  "51" = "Asennuspalvelut", "55" = "Majoitus- ja ravintolapalvelut",
  "60" = "Kuljetuspalvelut", "63" = "Liikenteen tukipalvelut",
  "64" = "Posti- ja televiestintä", "65" = "Energia- ja vesihuolto",
  "66" = "Rahoitus ja vakuutus", "70" = "Kiinteistöpalvelut",
  "71" = "Arkkitehti- ja insinööripalvelut", "72" = "IT-palvelut",
  "73" = "Tutkimus ja kehitys", "75" = "Julkishallinnon palvelut",
  "76" = "Öljy- ja kaasualan palvelut", "77" = "Maa-, metsä- ja puutarhapalvelut",
  "79" = "Liike-elämän palvelut", "80" = "Koulutuspalvelut",
  "85" = "Terveys- ja sosiaalipalvelut", "90" = "Jäte-, puhdistus- ja ympäristöpalvelut",
  "92" = "Virkistys-, kulttuuri- ja urheilupalvelut", "98" = "Muut palvelut"
)
single <- single |>
  mutate(cpv_name = coalesce(cpv_names[cpv2], paste("CPV", cpv2)),
         nature = factor(nature, levels = c("Tavarat", "Palvelut", "Rakennusurakat")))
```

```{r}
#| label: ln-fit

fit_ln <- brm(
  bf(value_real ~ 1 + nature + (1 | cpv2),
     sigma ~ 1 + (1 | cpv2)),
  family = lognormal(),
  data   = single,
  prior  = c(prior(normal(12, 3), class = Intercept),
             prior(normal(0, 2), class = b),
             prior(exponential(1), class = sd),
             prior(normal(0, 1), class = Intercept, dpar = sigma),
             prior(exponential(1), class = sd, dpar = sigma)),
  chains = 4, iter = 2000, seed = 2026,
  file = file.path(models_dir, "p1_lognormal"), file_refit = "on_change"
)

# Konvergenssitarkistus: Rhat lähellä 1 ja riittävä tehollinen otoskoko
rh <- rhat(fit_ln)
stopifnot(max(rh, na.rm = TRUE) < 1.05)
```

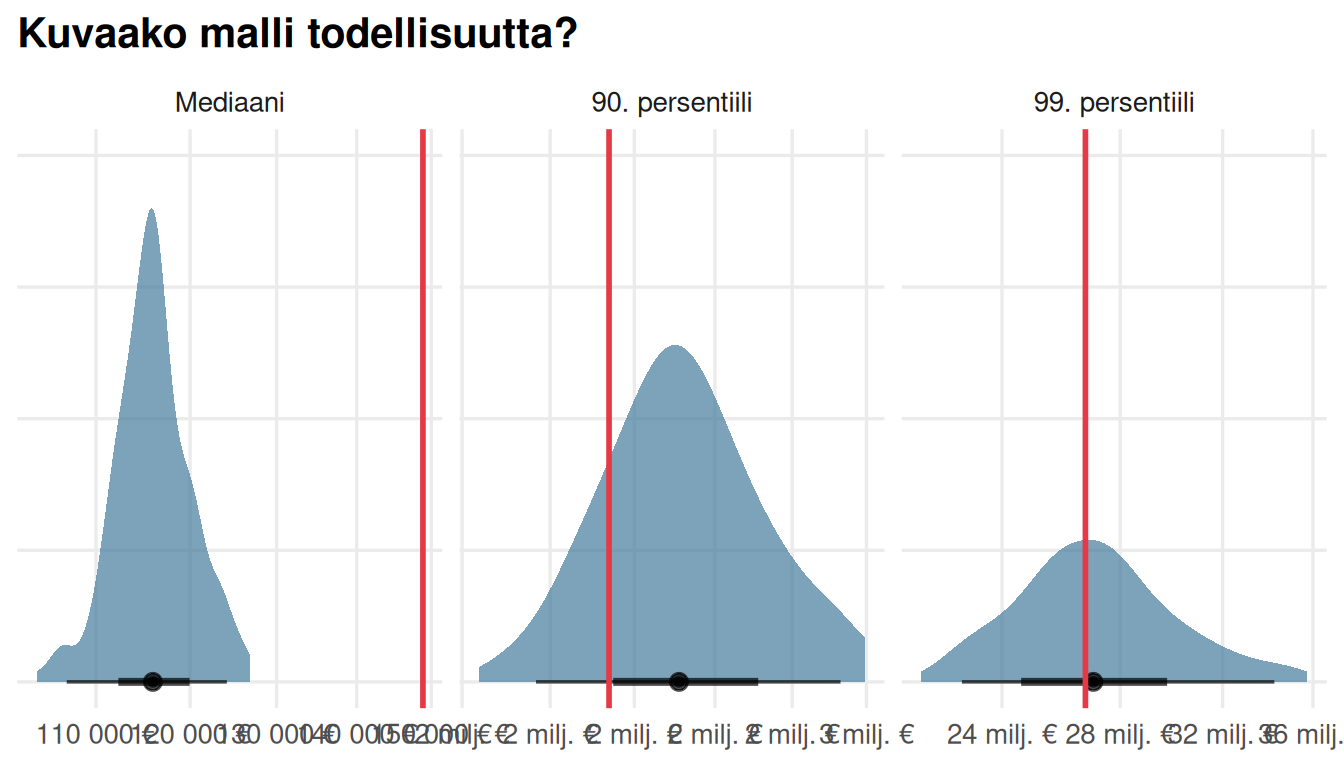
**Mallin tarkistus.** Mallin pitää pystyä tuottamaan aineisto, joka näyttää todelliselta. Arvoin mallista 200 kuvitteellista aineistoa ja vertasin niiden mediaania ja ylimpiä persentiilejä todellisiin.

```{r}
#| label: fig-ppc
#| fig-cap: "Mallin tarkistus: mallin tuottamien kuvitteellisten aineistojen tunnusluvut (jakaumat) verrattuna todelliseen arvoon (pystyviiva)."
#| fig-height: 4

yrep <- posterior_predict(fit_ln, ndraws = 200)
ppc <- tibble(draw = seq_len(nrow(yrep)),
              Mediaani      = apply(yrep, 1, median),
              `90. persentiili` = apply(yrep, 1, quantile, 0.90),
              `99. persentiili` = apply(yrep, 1, quantile, 0.99)) |>
  pivot_longer(-draw, names_to = "stat") |>
  mutate(stat = fct_inorder(stat))
obs_ppc <- tibble(stat = factor(c("Mediaani", "90. persentiili", "99. persentiili"),
                                levels = levels(ppc$stat)),
                  value = unname(quantile(single$value_real, c(0.5, 0.9, 0.99))))
ppc_cover <- ppc |> left_join(obs_ppc, by = "stat", suffix = c("", "_obs")) |>
  group_by(stat) |> summarise(p_above = mean(value > value_obs), .groups = "drop")

ggplot(ppc, aes(value)) +
  stat_halfeye(fill = "#457b9d", alpha = 0.7) +
  geom_vline(data = obs_ppc, aes(xintercept = value), colour = "#e63946", linewidth = 1) +
  facet_wrap(~stat, scales = "free_x") +
  scale_x_log10(labels = lab_eur) +
  labs(x = NULL, y = NULL, title = "Kuvaako malli todellisuutta?") +
  theme(axis.text.y = element_blank())
```

**Kuvan lukuohje.** Sininen "vuori" näyttää, mitä mallin mukaan olisi pitänyt havaita: leveä vuori tarkoittaa epävarmuutta, ja huippu on todennäköisin arvo. Punainen viiva on se, mitä todellisuudessa havaittiin. Malli on hyvä, jos punainen viiva osuu vuoren keskelle. Jos viiva on vuoren reunalla tai ulkopuolella, malli erehtyy järjestelmällisesti.

`r q99_p <- ppc_cover$p_above[ppc_cover$stat == "99. persentiili"]; if (q99_p < 0.05) paste0("Mediaani ja 90. persentiili osuvat kohdalleen, mutta **malli aliarvioi ylimmän prosentin**: vain ", pct(q99_p, 0), " kuvitteellisista aineistoista tuotti yhtä suuren 99. persentiilin kuin todellisuus. Tämä on sama paksun hännän ilmiö kuin edellä. Lognormaali malli sopii *tavallisen* hankinnan kuvaamiseen, mutta jättiläisten arvioinnissa tarvitaan häntämallia. Kahden mallin yhdistelmä on tässä rehellisempi kuin yksi malli, joka väittää osaavansa kaiken.") else "Malli toistaa sekä tavallisten että suurten hankintojen tason hyvin, joten sen ennusteisiin voi luottaa kohtuullisesti myös jakauman yläpäässä."`

```{r}
#| label: fig-cpv-pred
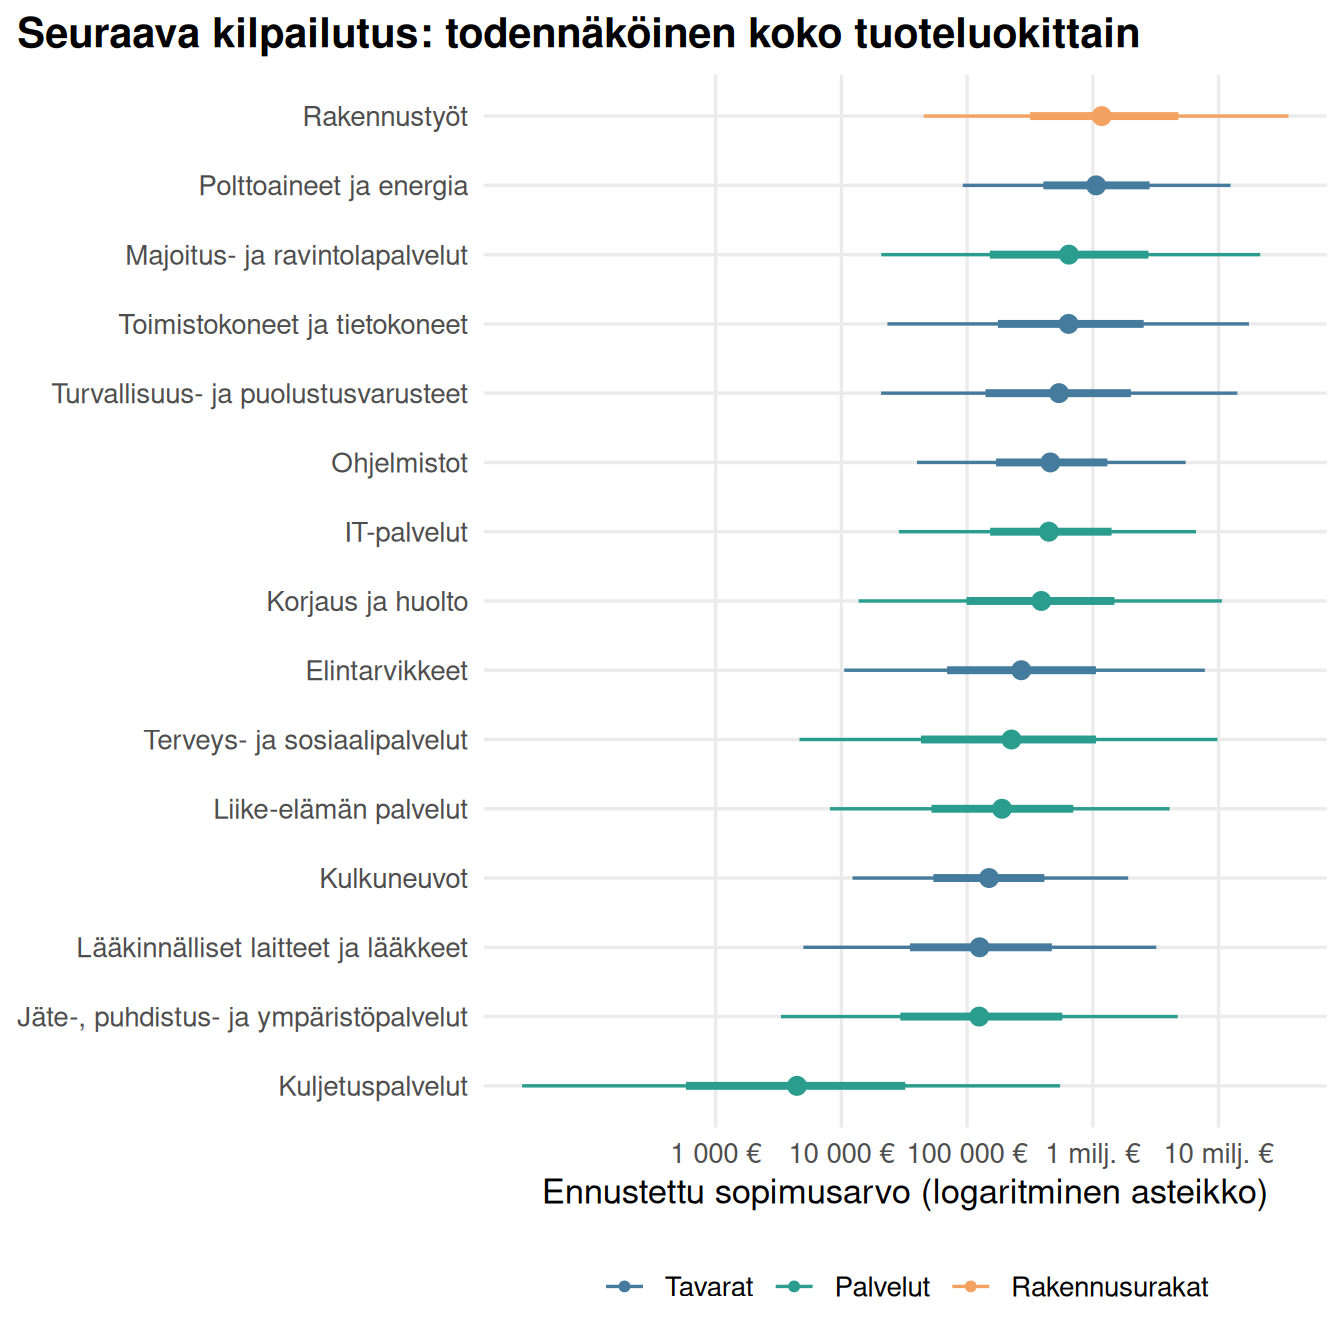
#| fig-cap: "Seuraavan hankinnan ennustettu sopimusarvo tuoteluokittain (15 euromäärältään suurinta CPV-pääryhmää). Piste = mediaani, paksu viiva = 50 %:n ja ohut viiva = 90 %:n ennusteväli."
#| fig-height: 7

top_cpv <- single |>
  group_by(cpv2, cpv_name) |>
  summarise(eur = sum(value_real), n = n(),
            nature = names(which.max(table(nature))), .groups = "drop") |>
  slice_max(eur, n = 15)

nd <- top_cpv |> mutate(nature = factor(nature, levels = levels(single$nature)))
pp <- posterior_predict(fit_ln, newdata = nd, ndraws = 4000)
stopifnot(ncol(pp) == nrow(nd))

stopifnot(!anyDuplicated(nd$cpv_name))
colnames(pp) <- nd$cpv_name
pred_long <- as_tibble(pp) |>
  pivot_longer(everything(), names_to = "cpv_name", values_to = "value") |>
  left_join(nd |> select(cpv_name, nature, n), by = "cpv_name")

pred_sum <- pred_long |> group_by(cpv_name) |>
  summarise(med = median(value), lo90 = quantile(value, .05), hi90 = quantile(value, .95),
            .groups = "drop")

ggplot(pred_long, aes(x = value, y = fct_reorder(cpv_name, value, median), colour = nature)) +
  stat_pointinterval(.width = c(0.5, 0.9)) +
  scale_x_log10(labels = lab_eur, breaks = 10^(3:9)) +
  scale_colour_manual(values = col_nat, name = NULL) +
  labs(x = "Ennustettu sopimusarvo (logaritminen asteikko)", y = NULL,
       title = "Seuraava kilpailutus: todennäköinen koko tuoteluokittain")
```

**Kuvan lukuohje.** Jokainen rivi on yksi tuoteluokka. Piste kertoo mediaanin: seuraava hankinta on yhtä todennäköisesti tätä pienempi kuin suurempi. Paksu viiva on väli, jolle hankinta osuu puolessa tapauksista, ja ohut viiva väli, jolle se osuu yhdeksässä tapauksessa kymmenestä. Vaaka-akseli on jälleen logaritminen. Huomaa, kuinka leveitä välit ovat: **saman tuoteluokan kaksi peräkkäistä hankintaa voivat olla kooltaan satakertaisesti eri luokkaa**. Tämä ei ole mallin heikkous, vaan rehellinen kuva siitä, miltä markkina näyttää.

```{r}
#| label: nature-bayes

post_b <- as_draws_df(fit_ln)
ratio_serv  <- exp(post_b$b_naturePalvelut)
ratio_works <- exp(post_b$b_natureRakennusurakat)
```

Sama malli antaa myös bayesilaisen vastineen yllä tehdylle testille, ja se huomioi tuoteluokkien erot. Kun tuoteluokka on vakioitu, palveluhankinnan mediaanikoko on `r format(round(median(ratio_serv), 2), decimal.mark = ",")`-kertainen tavarahankintaan verrattuna (90 %:n väli `r format(round(quantile(ratio_serv, .05), 2), decimal.mark = ",")`–`r format(round(quantile(ratio_serv, .95), 2), decimal.mark = ",")`). Rakennusurakoilla vastaava kerroin on `r format(round(median(ratio_works), 2), decimal.mark = ",")` (90 %:n väli `r format(round(quantile(ratio_works, .05), 2), decimal.mark = ",")`–`r format(round(quantile(ratio_works, .95), 2), decimal.mark = ",")`). Todennäköisyys sille, että rakennusurakan mediaani on suurempi kuin tavarahankinnan, on `r pct(mean(ratio_works > 1), 0)`.

## Arvio vastaan todellisuus: kuinka osuvia hankintayksiköiden omat arviot ovat?

eForms-ilmoituksissa on sekä hankintayksikön **etukäteisarvio** että **voittaneen tarjouksen arvo**. Kun nämä yhdistetään, nähdään kuinka hyvin julkinen ostaja tuntee markkinan, jolta se ostaa.

```{r}
#| label: est-vs-act

eva <- single |>
  filter(!is.na(lot_est_value), lot_est_value >= 100) |>
  mutate(ratio = tender_value / lot_est_value, log_ratio = log(ratio))

n_unit_err <- sum(abs(log10(eva$ratio)) > 2)          # yli 100-kertainen ero -> näppäilyvirhe
eva <- eva |> filter(abs(log10(ratio)) <= 2)
stopifnot(nrow(eva) > 200)

wt <- wilcox.test(eva$log_ratio, mu = 0, exact = FALSE)
n_eva <- sum(eva$log_ratio != 0)        # Wilcoxon pudottaa nollaerot pois
r_rb <- 2 * as.numeric(wt$statistic) / (as.numeric(n_eva) * (n_eva + 1) / 2) - 1   # rank-biserial
share_over <- mean(eva$ratio > 1)
share_exact <- mean(abs(eva$ratio - 1) < 0.005)
```

```{r}
#| label: est-vs-act-bayes

# Tyypillisen suhteen (mediaanin) epävarmuus bayesilaisella bootstrapilla.
# Parametrinen t-jakaumamalli ei sovi tähän: suuri joukko tarkalleen 1,00:n
# suhteita (arvioksi kirjattu sopimushinta) muodostaa piikin, jonka vuoksi
# MCMC-ketjut eivät sekoittuneet (R-hat 3,6). Bootstrap ei oleta jakaumamuotoa.
bb_median <- function(x, n = 4000) {
  stopifnot(length(x) >= 20)
  map_dbl(seq_len(n), function(i) {
    w <- rexp(length(x)); w <- w / sum(w)              # Dirichlet(1)-painot
    o <- order(x); cw <- cumsum(w[o])
    x[o][which(cw >= 0.5)[1]]                          # painotettu mediaani
  })
}

ratio_draws <- eva |>
  filter(abs(ratio - 1) >= 0.005) |>                   # piikki pois, raportoidaan erikseen
  group_by(nature) |>
  filter(n() >= 20) |>
  summarise(ratio = list(bb_median(ratio)), .groups = "drop") |>
  unnest(ratio) |>
  mutate(nature = as.character(nature))
stopifnot(nrow(ratio_draws) > 0, all(ratio_draws$ratio > 0))
```

```{r}
#| label: fig-ratio
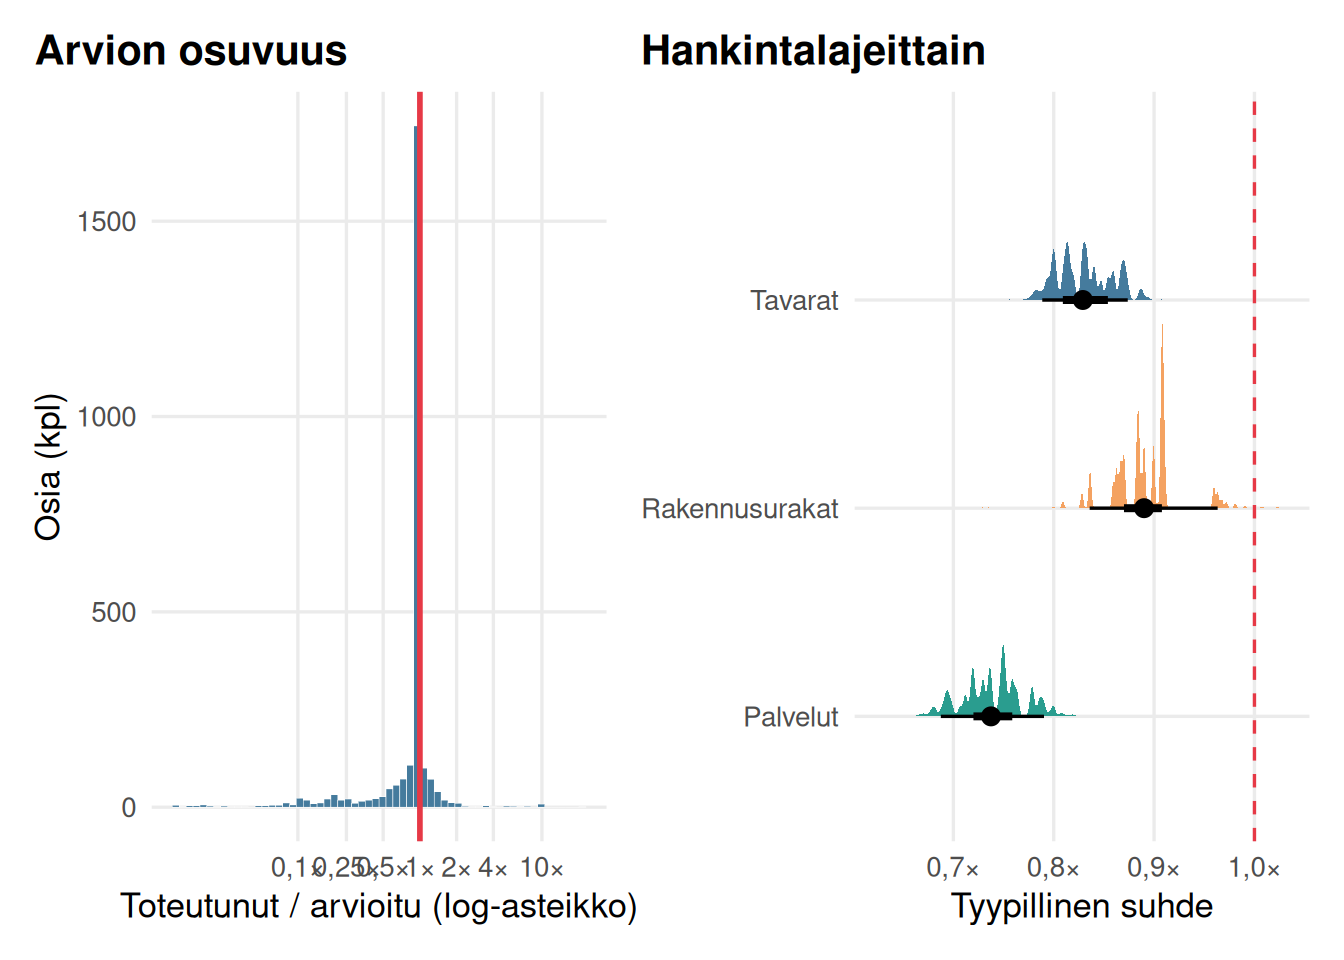
#| fig-cap: "Voittaneen tarjouksen suhde hankintayksikön arvioon (vasen) ja tyypillisen suhteen bayesilainen posteriorijakauma hankintalajeittain (oikea)."
#| fig-height: 5

p1 <- ggplot(eva, aes(ratio)) +
  geom_histogram(bins = 60, fill = "#457b9d", colour = "white", linewidth = 0.1) +
  geom_vline(xintercept = 1, colour = "#e63946", linewidth = 1) +
  scale_x_log10(breaks = c(0.1, 0.25, 0.5, 1, 2, 4, 10),
                labels = c("0,1×", "0,25×", "0,5×", "1×", "2×", "4×", "10×")) +
  labs(x = "Toteutunut / arvioitu (log-asteikko)", y = "Osia (kpl)",
       title = "Arvion osuvuus")
p2 <- ggplot(ratio_draws, aes(ratio, nature, fill = nature)) +
  stat_halfeye(.width = c(0.5, 0.9)) +
  geom_vline(xintercept = 1, colour = "#e63946", linetype = 2) +
  scale_fill_manual(values = col_nat, guide = "none") +
  scale_x_continuous(labels = \(x) paste0(format(x, decimal.mark = ","), "×")) +
  labs(x = "Tyypillinen suhde", y = NULL, title = "Hankintalajeittain")
p1 + p2
```

**Kuvan lukuohje.** Vasemmassa kuvassa jokainen havainto on yksi kilpailutettu osa. Punainen viiva "1×" tarkoittaa, että voittanut tarjous oli täsmälleen yhtä suuri kuin hankintayksikön arvio. Viivan vasemmalla puolella tarjous jäi arvion alle, ja oikealla puolella arvio ylittyi. Oikeassa kuvassa on *tyypillinen* (mediaani)suhde kussakin hankintalajissa niistä tapauksista, joissa arvio ja toteuma eivät ole täsmälleen samat. Vuoren leveys kuvaa epävarmuutta: se on laskettu **bayesilaisella bootstrapilla**, eli aineistoa on painotettu satunnaisesti uudelleen 4 000 kertaa ja mediaani laskettu joka kerta. Menetelmä ei oleta mitään valmista jakaumamuotoa. Valitsin sen, koska tarkalleen 1,00:n suhteiden suuri joukko teki tavanomaisesta jakaumamallista epävakaan.

Havainnot:

- **Voittanut tarjous ylitti arvion `r pct(share_over, 0)` osista.** Arvio osui alle puolen prosentin tarkkuudella kohdalleen `r pct(share_exact, 0)` tapauksista. Usein tämä selittyy sillä, että arvioksi on ilmoitettu jälkikäteen sopimuksen hinta.
- **Wilcoxonin merkittyjen sijalukujen testi** sopii tähän, koska samasta hankinnasta on kaksi lukua (arvio ja toteuma), joten vertailu tehdään parin sisällä. Testi kertoo, poikkeaako tyypillinen suhde luvusta 1: p `r fi_p(wt$p.value)`. Vaikutuksen koko (sijalukuihin perustuva korrelaatio) on `r format(round(r_rb, 2), decimal.mark = ",")`, ja negatiivinen arvo tarkoittaa, että tarjoukset jäävät tyypillisesti arvion alle.
- Lisäksi `r num(n_unit_err)` osassa arvio ja toteuma erosivat yli satakertaisesti. Nämä ovat lähes varmasti yksikkövirheitä (esimerkiksi tuhansina euroina ilmoitettu arvo), ja ne on jätetty pois.

::: {.callout-note title="Faktalaatikko: Kustannusylitykset ovat sääntö, eivät poikkeus"}
Tanskalais-brittiläinen tutkija **Bent Flyvbjerg** kollegoineen kokosi 258 liikenneinfrastruktuurihankkeen aineiston 20 maasta (*Transport Reviews*, 2003). Kustannukset ylittyivät keskimäärin **rautateillä 45 %, silloissa ja tunneleissa 34 % ja teillä 20 %**, ja hajonta oli valtavaa.

Myöhemmin Flyvbjerg ja kumppanit analysoivat 5 392 IT-hankkeen aineiston (*Journal of Management Information Systems*, 2022). He havaitsivat, että IT-hankkeiden kustannusylitykset noudattavat **potenssilakia** eli paksuhäntäistä jakaumaa. Useimmat ylitykset ovat pieniä, mutta harvat ylitykset ovat niin valtavia, että ne hallitsevat kokonaiskuvaa. Kyse on samasta ilmiöstä, jonka yllä löysimme hankintojen koosta.

Muodollista meta-analyysia kustannusylitysten yhdistetystä suuruudesta en löytänyt. Liikenneinfrastruktuurin kustannusylitysten syitä kartoittava systemaattinen kirjallisuuskatsaus (Cavalieri, Cristaudo & Guccio, *Transport Reviews* 2019) kävi läpi 945 artikkelia, joista 26 täytti mukaanottokriteerit. Katsauksen mukaan näyttö on hajallaan tieteenalojen välillä ja tulokset vaihtelevat paljon. Ylitysten keskikoko on siis itsekin jakauma.

**Tärkeä ero Hilma-dataan.** Hilmasta näkyy vain *sopimushinta* eli voittanut tarjous. Siitä ei näe, mitä hanke lopulta maksoi. Flyvbjerg mittaa juuri lopullisia kustannuksia. Hilman "tarjous jäi alle arvion" ei siis tarkoita, että hanke pysyi budjetissa.
:::

```{r}
#| label: cf-overrun

works_eur <- single |> filter(nature == "Rakennusurakat", year >= last_full - 2) |>
  group_by(year) |> summarise(eur = sum(value_real), .groups = "drop")
works_annual <- mean(works_eur$eur)
cf_over <- tibble(
  Skenaario = c("Sopimushinta toteutuu sellaisenaan",
                "Ylitys kuten teillä (Flyvbjerg ym. 2003): +20 %",
                "Ylitys kuten silloissa ja tunneleissa: +34 %",
                "Ylitys kuten rautateillä: +45 %"),
  kerroin = c(1, 1.20, 1.34, 1.45)) |>
  mutate(`Rakennusurakat vuodessa` = eur(works_annual * kerroin),
         `Lisäkustannus vuodessa`  = eur(works_annual * (kerroin - 1))) |>
  select(-kerroin)
knitr::kable(cf_over)
```

**Vastaskenaario.** Taulukossa yhden voittajan rakennusurakoiden vuotuinen sopimusarvo (`r eur(works_annual)` kolmen viime vuoden keskiarvona) on kerrottu Flyvbjergin tutkimuksen keskimääräisillä ylitysprosenteilla. Jos Suomen rakennusurakat ylittyisivät samassa suhteessa kuin kansainvälisessä aineistossa, sopimushintojen päälle tulisi vuosittain **`r eur(works_annual * 0.20)`–`r eur(works_annual * 0.45)`**, jota Hilma ei näe. Tämä on skenaario, ei mittaus. Se osoittaa, miksi hankinnan *jälkiseuranta*, eli toteutuneiden kustannusten avaaminen sopimushintojen rinnalle, olisi seuraava looginen askel julkisen talouden läpinäkyvyydessä.

### Budjettivarauksen vastaskenaario

Hankintayksikön budjetoija joutuu kysymään, kuinka paljon arvion päälle pitää varata, jotta raha riittää. Alla lasken toteutuneesta aineistosta, kuinka usein voittanut tarjous olisi ylittänyt eri suuruiset varaukset. Epävarmuus on laskettu bayesilaisesti: osuuden posteriorijakauma on beta-jakauma, ja lähtöoletuksena on tasainen priori.

```{r}
#| label: cf-reserve

reserve_tbl <- tibble(varaus = c(0, 0.10, 0.20, 0.30, 0.50)) |>
  mutate(k = map_int(varaus, \(r) sum(eva$ratio > 1 + r)),
         n = nrow(eva),
         med = qbeta(0.5, k + 1, n - k + 1),
         lo  = qbeta(0.05, k + 1, n - k + 1),
         hi  = qbeta(0.95, k + 1, n - k + 1)) |>
  transmute(`Varaus arvion päälle` = pct(varaus, 0),
            `Budjetti ylittyy` = paste0(pct(med), " (", pct(lo), "–", pct(hi), ")"))

mean_reserve <- mean(eva$ratio) - 1
q95_reserve  <- quantile(eva$ratio, 0.95) - 1
knitr::kable(reserve_tbl)
```

Jos varaus mitoitetaan **keskiarvon** mukaan, sen pitäisi olla `r pct(mean_reserve, 0)`. Jotta budjetti riittäisi 19 kerralla 20:stä, varauksen pitäisi olla `r pct(q95_reserve, 0)`. Ero näiden kahden luvun välillä on käytännön esimerkki siitä, mitä "maailma on jakauma" tarkoittaa rahassa. Keskiarvoon perustuva varaus pettää juuri silloin, kun sitä eniten tarvittaisiin, eli harvinaisissa suurissa ylityksissä.

## Valvonnan vastaskenaario: mihin tarkastusresurssi kannattaa kohdistaa?

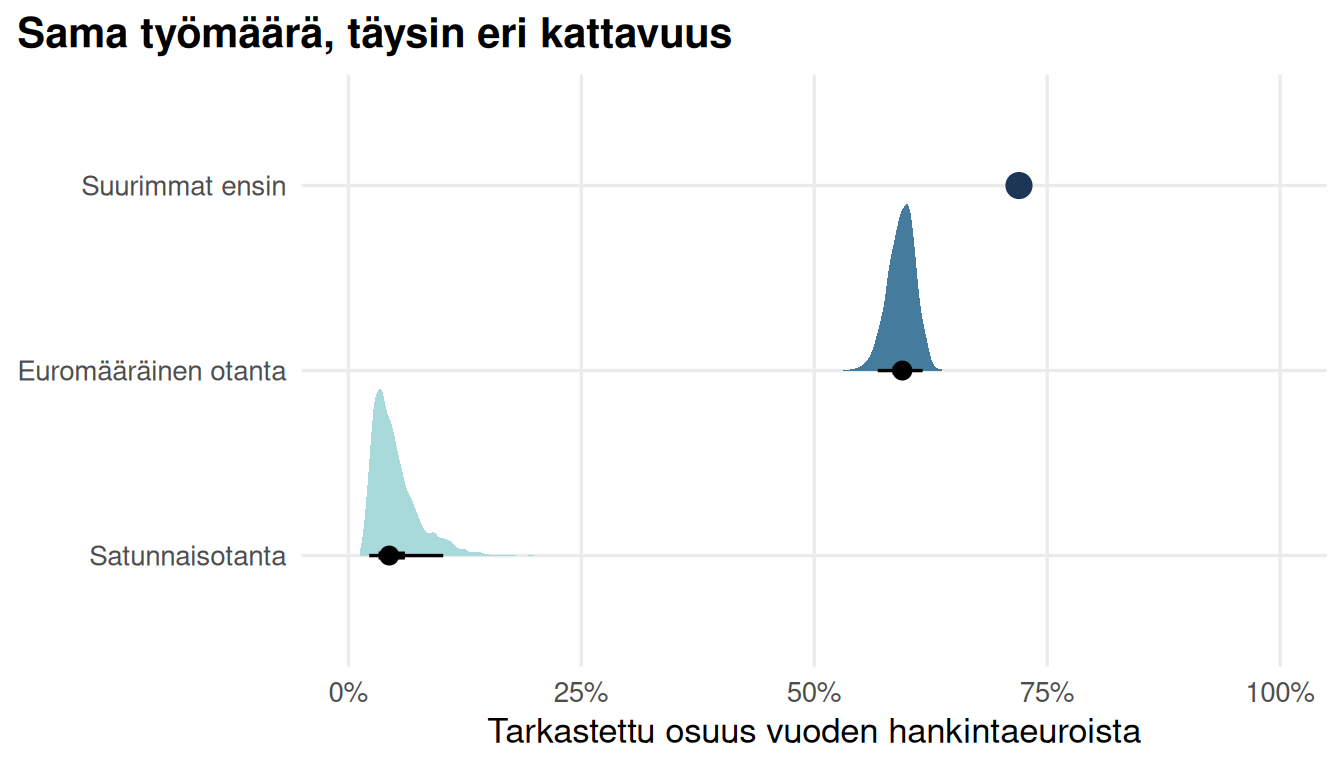
Kuvitellaan tarkastaja: tilintarkastaja, valtiontalouden tarkastusviraston virkamies tai kunnan sisäinen tarkastaja. Hänellä on aikaa käydä läpi **5 % vuoden hankintailmoituksista**. Kuinka suuren osan *euroista* hän ehtii nähdä?

Vertaan kolmea strategiaa:

1. **Satunnaisotanta**: jokaisella hankinnalla on sama todennäköisyys tulla valituksi.
2. **Euromääräinen otanta** (*monetary unit sampling*): todennäköisyys tulla valituksi on suoraan verrannollinen hankinnan arvoon. Tämä on tilintarkastuksessa vakiintunut menetelmä.
3. **Suurimmat ensin**: tarkastetaan suurimmat 5 %.

```{r}
#| label: cf-audit

va <- cn |> filter(year == last_full) |> pull(value_real)
k  <- ceiling(0.05 * length(va))
tot <- sum(va)

sim_random <- replicate(2000, sum(sample(va, k)) / tot)
sim_mus    <- replicate(2000, sum(sample(va, k, prob = va)) / tot)
cov_top    <- sum(sort(va, decreasing = TRUE)[1:k]) / tot

audit <- bind_rows(
  tibble(strategia = "Satunnaisotanta", cov = sim_random),
  tibble(strategia = "Euromääräinen otanta", cov = sim_mus),
  tibble(strategia = "Suurimmat ensin", cov = cov_top)
) |> mutate(strategia = fct_inorder(strategia))
stopifnot(cov_top >= max(sim_random))
```

```{r}
#| label: fig-audit
#| fig-cap: "Kuinka suuren osan vuoden hankintaeuroista tarkastaja näkee, kun hän ehtii käydä läpi 5 % ilmoituksista. Satunnaisille strategioille näytetään 2 000 simuloidun tarkastuksen jakauma."
#| fig-height: 4

ggplot(mapping = aes(cov, strategia, fill = strategia)) +
  stat_halfeye(data = filter(audit, strategia != "Suurimmat ensin"),
               .width = c(0.5, 0.9), normalize = "groups") +
  geom_point(data = filter(audit, strategia == "Suurimmat ensin"),
             size = 4, colour = "#1d3557") +
  scale_x_continuous(labels = label_percent(), limits = c(0, 1)) +
  scale_fill_manual(values = c("#a8dadc", "#457b9d", "#1d3557"), guide = "none") +
  labs(x = "Tarkastettu osuus vuoden hankintaeuroista", y = NULL,
       title = "Sama työmäärä, täysin eri kattavuus")
```

**Kuvan lukuohje.** Jokainen rivi on yksi tapa valita tarkastettavat hankinnat. "Vuori" näyttää, kuinka suuren osan euroista tarkastaja tavoittaisi, jos sama arvonta toistettaisiin 2 000 kertaa. Suurimmat ensin -strategiassa arvontaa ei ole, joten sen tulos on yksi piste.

Kun aineistona on vuoden `r last_full` `r num(length(va))` hankintailmoitusta ja niistä tarkastetaan `r num(k)`, tulokset ovat:

- **satunnaisotanta** kattaa tyypillisesti vain `r pct(median(sim_random), 0)` euroista, ja huonona vuonna (5 %:n kvantiili) `r pct(quantile(sim_random, .05), 0)`
- **euromääräinen otanta** kattaa tyypillisesti `r pct(median(sim_mus), 0)`
- **suurimmat ensin** kattaa `r pct(cov_top, 0)`.

Sama työmäärä tuottaa siis jopa `r round(cov_top / median(sim_random))`-kertaisen kattavuuden. "Suurimmat ensin" ei kuitenkaan ole automaattisesti paras valinta: jos tiedetään, että vain suurimmat tarkastetaan, väärinkäytöksiin houkuteltu ostaja pilkkoo hankintansa. Siksi euromääräinen otanta on usein hyvä kompromissi, koska se on painotettu suuriin mutta silti ennustamaton.

### Kymmenen hankinnan vastaskenaario

```{r}
#| label: cf-top10

top10_vals <- sort(va, decreasing = TRUE)[1:10]
mean_with <- mean(va); mean_without <- mean(sort(va, decreasing = TRUE)[-(1:10)])
med_with  <- median(va); med_without <- median(sort(va, decreasing = TRUE)[-(1:10)])
share_top10_n <- 10 / length(va)
share_top10_eur <- sum(top10_vals) / tot
```

Entä jos vuoden `r last_full` kymmenen suurinta hankintaa olisi jätetty kilpailuttamatta, siirretty seuraavalle vuodelle tai jos niiden arvo olisi ilmoitettu väärin? Kymmenen hankintaa on `r pct(share_top10_n, 2)` vuoden ilmoituksista, mutta niiden osuus euroista on **`r pct(share_top10_eur, 0)`**. Ilman niitä keskiarvo putoaisi `r eur(mean_with)`:sta `r eur(mean_without)`:oon, eli `r pct(1 - mean_without / mean_with, 0)`. Mediaani muuttuisi vain `r eur(med_with)`:sta `r eur(med_without)`:oon. **Keskiarvo on kymmenen hankinnan panttivanki, mediaani ei ole.** Tämä on hyvä muistaa aina, kun uutisotsikko kertoo hankintojen "keskimäärin kasvaneen".

## Mittakaava: kuinka suuren osan julkisista hankinnoista Hilma näkee?

```{r}
#| label: macro

gov_proc <- gov |>
  filter(na_item != "B1GQ") |>
  group_by(year) |> summarise(proc_meur = sum(values, na.rm = TRUE), .groups = "drop") |>
  left_join(gov |> filter(na_item == "B1GQ") |> select(year, gdp_meur = values), by = "year")

hilma_year <- cn |> group_by(year) |>
  summarise(hilma_meur = sum(estimatedValue) / 1e6, .groups = "drop")

macro <- inner_join(gov_proc, hilma_year, by = "year") |>
  filter(year >= last_full - 6) |>
  mutate(proc_share_gdp = proc_meur / gdp_meur, ratio = hilma_meur / proc_meur)
stopifnot(nrow(macro) >= 3)
has_d632 <- any(str_detect(gov$na_item, "^D632"))
m_last <- macro |> slice_max(year, n = 1)
```

Eurostatin kansantalouden tilinpidon mukaan Suomen julkisyhteisöjen hankinnat olivat vuonna `r m_last$year` noin **`r eur(m_last$proc_meur * 1e6, 0)`**, eli `r pct(m_last$proc_share_gdp, 0)` bruttokansantuotteesta. Luku on laskettu OECD:n määritelmällä: välituotekäyttö + investoinnit`r if (has_d632) " + markkinatuottajilta ostetut luontoissosiaalietuudet" else " (luontoissosiaalietuudet puuttuivat aineistosta, joten luku on alaraja)"`. Hilman hankintailmoitusten arvioitujen arvojen summa samana vuonna oli `r eur(m_last$hilma_meur * 1e6, 0)`.

Nämä kaksi lukua **eivät mittaa samaa asiaa**. Kansantalouden tilinpito kertoo vuoden aikana käytetyt eurot. Hilman arvo taas on koko sopimuksen arvio monivuotiselta kaudelta, ja puitejärjestelyissä se on usein enimmäisarvo. Hilmasta myös puuttuvat kynnysarvon alittavat pienhankinnat ja ne ilmoitukset, joissa arvoa ei kerrota. Vertailu kertoo siis mittakaavasta, ei kattavuusprosentista. Se osoittaa kuitenkin, että **Hilma yksin ei riitä vastaamaan kysymykseen "mihin julkinen raha menee"**. Ilmoitukset kertovat aikeista, eivät maksuista.

## Ennuste: paljonko Suomessa kilpailutetaan vuonna `r last_full + 2`?

Ennuste on tämän kirjoituksen tärkein osa. Jos ymmärrämme ilmiön, meidän pitäisi pystyä ennustamaan se, ja ennusteen pitää olla **jakauma eikä yksi luku**.

**Mallin rakenne.** Vuoden hankintavolyymi syntyy kahdesta tekijästä:

1. **Kuinka monta hankintaa** julkaistaan kunakin kuukautena. Tätä mallinnan bayesilaisella regressiomallilla, jossa on vuosittainen trendi ja kuukausittainen kausivaihtelu. Malli käyttää *negatiivista binomijakaumaa*, joka sopii lukumäärille, joiden vaihtelu on suurempaa kuin puhdas sattuma selittäisi.
2. **Kuinka suuri kukin hankinta on.** Tämä arvotaan kolmen viimeisimmän vuoden todellisista hankinnoista **bayesilaisella bootstrapilla**. Se on menetelmä, joka ei oleta mitään valmista jakaumamuotoa, vaan käyttää todellista paksuhäntäistä jakaumaa sellaisenaan ja huomioi silti sen, että havaittu jakauma on vain otos.

Kun nämä yhdistetään tuhansia kertoja, saadaan **tuhansia mahdollisia vuosia** ja niiden vuosisummien jakauma.

**Ennen ennustamista tarkistin, toimiiko menetelmä.** Kuvittelin olevani vuoden `r last_full - 1` lopussa, sovitin mallin vain siihen mennessä kertyneeseen dataan ja ennustin vuoden `r last_full`. Sitten vertasin ennustetta siihen, mitä todella tapahtui. Vertailukohtana on kolme yksinkertaista **pistearviota**, joita tällaisessa tilanteessa usein käytetään.

```{r}
#| label: forecast-fns

monthly_counts <- function(d) {
  d |> mutate(month = as.Date(format(datePublished, "%Y-%m-01"))) |>
    count(month) |>
    complete(month = seq(min(month), max(month), by = "month"), fill = list(n = 0L)) |>
    mutate(t = as.numeric(month - min(month)) / 365.25,
           m = factor(format(month, "%m")))
}

fit_counts <- function(train, name) {
  brm(n ~ t + m, family = negbinomial(), data = train,
      prior = c(prior(normal(0, 1), class = b),
                prior(normal(6, 3), class = Intercept)),
      chains = 4, iter = 2000, seed = 2026,
      file = file.path(models_dir, name), file_refit = "on_change")
}

# Vuosisummien posteriorijakauma: lukumäärät mallista x arvot bayesilaisella bootstrapilla
simulate_year <- function(fit, newmonths, pool, ndraws = 1000) {
  stopifnot(nrow(newmonths) == 12, length(pool) > 1000)
  cnt <- posterior_predict(fit, newdata = newmonths, ndraws = ndraws)
  n_year <- rowSums(cnt)
  map_dbl(n_year, function(N) {
    w <- rexp(length(pool)); w <- w / sum(w)               # Dirichlet(1)-painot
    sum(sample(pool, N, replace = TRUE, prob = w))
  }) |> (\(x) tibble(N = n_year, total = x))()
}

future_months <- function(train_counts, year) {
  start <- min(train_counts$month)
  tibble(month = seq(as.Date(paste0(year, "-01-01")), by = "month", length.out = 12)) |>
    mutate(t = as.numeric(month - start) / 365.25,
           m = factor(format(month, "%m"), levels = levels(train_counts$m)))
}
```

```{r}
#| label: backtest

bt_year   <- last_full
train_bt  <- cn |> filter(year >= bt_year - 5, year < bt_year)
counts_bt <- monthly_counts(train_bt)
fit_bt    <- fit_counts(counts_bt, paste0("p1_counts_bt", bt_year))
stopifnot(max(rhat(fit_bt), na.rm = TRUE) < 1.05)

pool_bt <- train_bt |> filter(year >= bt_year - 3) |> pull(value_real)
sim_bt  <- simulate_year(fit_bt, future_months(counts_bt, bt_year), pool_bt)

actual_bt   <- sum(cn$value_real[cn$year == bt_year])
actual_n_bt <- sum(cn$year == bt_year)
n_hat       <- median(sim_bt$N)

point_fc <- tibble(
  Menetelmä = c("Edellisen vuoden summa",
                "Ennustettu lukumäärä × keskiarvohankinta",
                "Ennustettu lukumäärä × mediaanihankinta",
                "Bayesilainen ennuste (mediaani)"),
  Ennuste = c(sum(train_bt$value_real[train_bt$year == bt_year - 1]),
              n_hat * mean(pool_bt),
              n_hat * median(pool_bt),
              median(sim_bt$total))) |>
  mutate(Virhe = Ennuste / actual_bt - 1)

pct_rank_bt <- mean(sim_bt$total <= actual_bt)   # missä kohtaa ennustejakaumaa toteuma oli
in50 <- between(actual_bt, quantile(sim_bt$total, .25), quantile(sim_bt$total, .75))
in90 <- between(actual_bt, quantile(sim_bt$total, .05), quantile(sim_bt$total, .95))
n_in90 <- between(actual_n_bt, quantile(sim_bt$N, .05), quantile(sim_bt$N, .95))

knitr::kable(point_fc |> mutate(Ennuste = eur(Ennuste), Virhe = pct(Virhe, 0)),
             caption = paste0("Takautuva testi: vuoden ", bt_year, " toteuma oli ", eur(actual_bt), "."))
```

Takautuvan testin tulos:

- **Lukumäärä**: malli ennusti `r num(n_hat)` hankintailmoitusta (90 %:n väli `r num(quantile(sim_bt$N, .05))`–`r num(quantile(sim_bt$N, .95))`), ja toteutui `r num(actual_n_bt)`. `r if (n_in90) "Toteuma osui ennustevälille." else "Toteuma jäi ennustevälin ulkopuolelle, mikä kertoo, että ilmoitusmäärissä tapahtui jotain, mitä aiempi trendi ei ennakoinut."`
- **Euromäärä**: toteuma `r eur(actual_bt)` osui ennustejakauman kohtaan, jota pienempiä oli `r pct(pct_rank_bt, 0)` ennustetuista vuosista. `r if (in50) "Se oli 50 %:n ennustevälillä." else if (in90) "Se oli 90 %:n ennustevälillä mutta ei 50 %:n välillä." else "Se jäi 90 %:n ennustevälin ulkopuolelle."`
- Pistearvioista virheet vaihtelivat `r pct(min(abs(point_fc$Virhe[1:3])), 0)`:n ja `r pct(max(abs(point_fc$Virhe[1:3])), 0)`:n välillä. Pistearvion ongelma ei ole se, että se olisi aina pahasti väärässä, vaan se, että **se ei kerro, kuinka väärässä se voi olla**. Bayesilainen ennuste kertoo tämän suoraan.

```{r}
#| label: forecast

fc_year     <- last_full + 2
train_fc    <- cn |> filter(year >= last_full - 4)
counts_fc   <- monthly_counts(train_fc)
fit_fc      <- fit_counts(counts_fc, paste0("p1_counts_fc", fc_year))
stopifnot(max(rhat(fit_fc), na.rm = TRUE) < 1.05)

pool_fc <- train_fc |> filter(year >= last_full - 2) |> pull(value_real)
sim_fc  <- simulate_year(fit_fc, future_months(counts_fc, fc_year), pool_fc)

fc_q <- quantile(sim_fc$total, c(0.05, 0.25, 0.5, 0.75, 0.95))
p_over_last <- mean(sim_fc$total > sum(cn$value_real[cn$year == last_full]))

# Ennuste talteen myöhempää vertailua varten (ennalta rekisteröity ennuste)
# Tallennetaan vain kerran: myöhemmät renderöinnit eivät saa ylikirjoittaa
# alkuperäistä, päivättyä ennustetta.
fc_file <- file.path(hilma_dir, paste0("p1_forecast_", fc_year, ".qs2"))
if (!file.exists(fc_file)) {
  qd_save(sim_fc |> mutate(forecast_made = Sys.Date(), target_year = fc_year), fc_file)
}
```

```{r}
#| label: fig-forecast
#| fig-cap: "Vuoden hankintailmoitusten arvioitujen arvojen summa: toteutuneet vuodet (pisteet) ja ennustejakauma (oikealla). Takautuvan testin ennustejakauma vuodelle, jonka toteuma tunnetaan, on piirretty harmaalla."
#| fig-height: 5.5

hist_years <- cn |> filter(year >= last_full - 6) |>
  group_by(year) |> summarise(total = sum(value_real), .groups = "drop")

ggplot() +
  stat_halfeye(data = sim_bt, aes(x = bt_year, y = total), fill = "grey75",
               .width = c(0.5, 0.9), width = 0.8, alpha = 0.8, orientation = "vertical") +
  stat_halfeye(data = sim_fc, aes(x = fc_year, y = total), fill = "#457b9d",
               .width = c(0.5, 0.9), width = 0.8, orientation = "vertical") +
  geom_line(data = hist_years, aes(year, total), colour = "grey30") +
  geom_point(data = hist_years, aes(year, total), size = 2.5) +
  scale_y_continuous(labels = lab_eur) +
  scale_x_continuous(breaks = seq(last_full - 6, fc_year)) +
  labs(x = NULL, y = "Arvioitujen arvojen summa (reaalieuroa)",
       title = paste0("Vuoden ", fc_year, " ennuste on jakauma, ja se on leveä"))
```

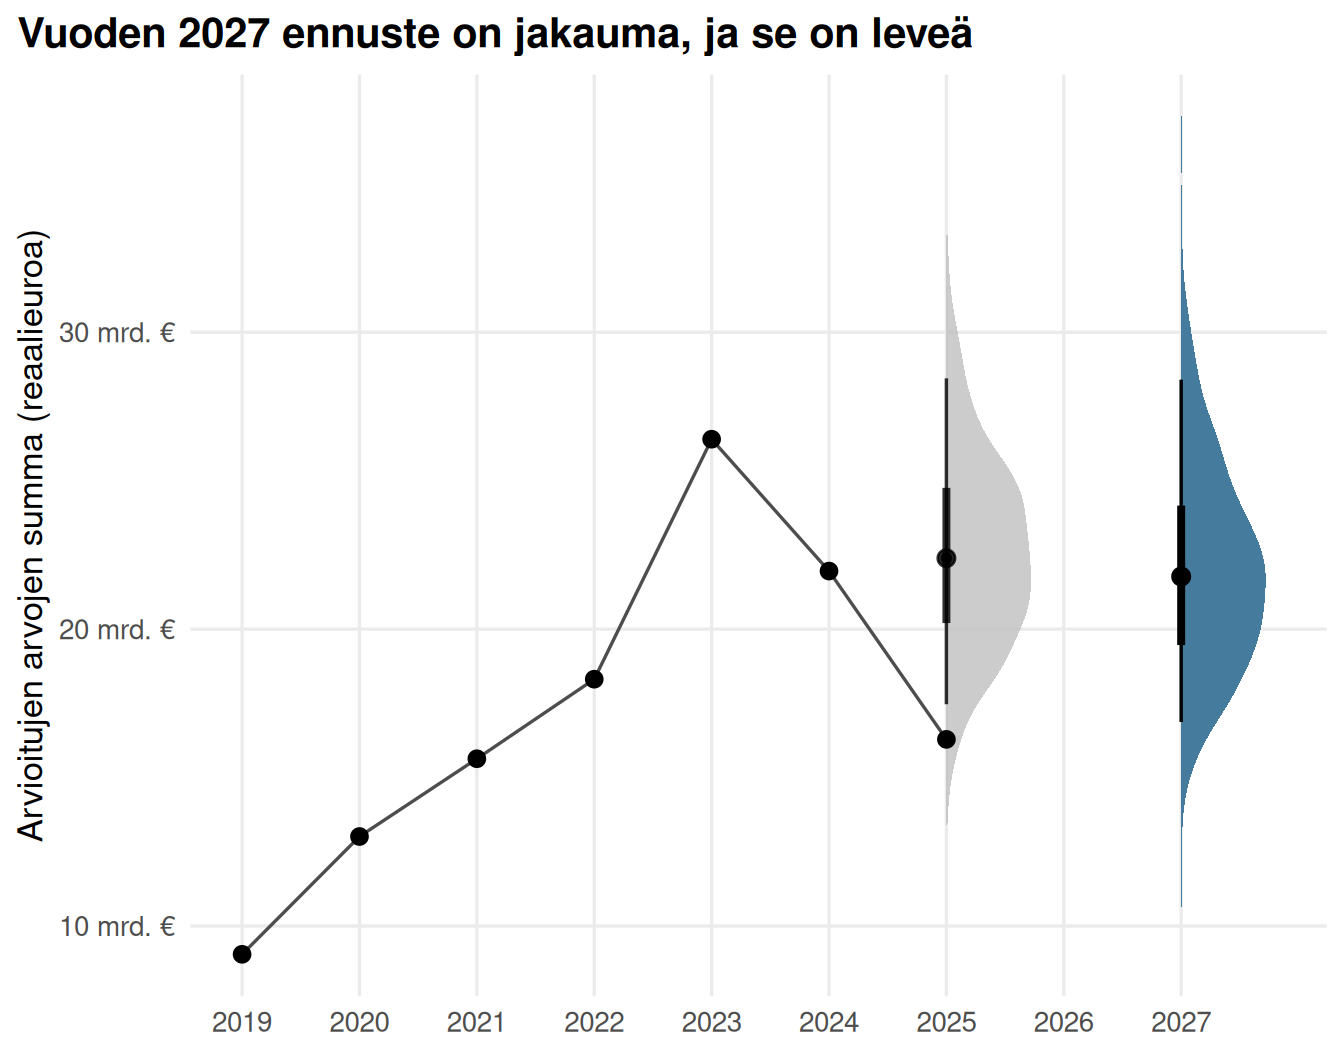
**Kuvan lukuohje.** Mustat pisteet ovat toteutuneita vuosia. Sininen "vuori" oikeassa reunassa on ennuste vuodelle `r fc_year`: vuoren leveimmän kohdan korkeudella oleva summa on todennäköisin, ja vuoren alla oleva paksu viiva kattaa puolet ja ohut viiva yhdeksän kymmenestä mahdollisesta lopputuloksesta. Harmaa vuori on takautuvan testin ennuste vuodelle `r bt_year`. Sen kohdalla oleva musta piste näyttää, mihin toteuma osui.

**Ennuste vuodelle `r fc_year`:** hankintailmoitusten arvioitujen arvojen summa on todennäköisimmin noin **`r eur(fc_q[3])`**. Puolet mahdollisista lopputuloksista osuu välille `r eur(fc_q[2])`–`r eur(fc_q[4])` ja yhdeksän kymmenestä välille `r eur(fc_q[1])`–`r eur(fc_q[5])`. Todennäköisyys sille, että summa ylittää vuoden `r last_full` toteuman, on `r pct(p_over_last, 0)`.

Ennusteväli on leveä, ja se on tämän kirjoituksen tärkein tulos. **Yksi jättihankinta voi siirtää koko vuoden summaa miljardeilla.** Jos joku esittää vuoden hankintavolyymin ennusteena yhden luvun, hän joko tietää jotain, mitä data ei tiedä, tai ei ole katsonut jakaumaa. Tallensin ennusteen päivättynä, ja vertaan sitä toteumaan, kun vuosi `r fc_year` on ohi.

**Rajoitukset.** Malli olettaa, että viime vuosien trendi ja kausivaihtelu jatkuvat. Lainsäädännön muutos, talouden käänne tai yksittäinen poikkeuksellinen hanke voi muuttaa kuvaa. eForms-siirtymä vuonna 2023 on voinut muuttaa myös sitä, mitä ilmoituksiin kirjataan. Lisäksi ennuste koskee *arvioituja* arvoja eli aikeita, ei toteutuneita maksuja.

## Miten tätä voi käyttää käytännössä?

**Päättäjälle ja virkamiehelle:**

- Kun hankintamenoista puhutaan, kysy **mediaania ja vaihteluväliä**, älä keskiarvoa. Jos kunnan "keskimääräinen hankinta" on kasvanut, tarkista ensin, johtuuko kasvu yhdestä hankkeesta.
- Mitoita budjettivaraukset jakauman yläpään mukaan (esimerkiksi niin, että raha riittää 19 kerralla 20:stä), älä keskimääräisen ylityksen mukaan.
- Kohdista valvonta euroihin, ei kappalemääriin. Sama työmäärä voi kattaa moninkertaisen osuuden rahasta.

**Tarjoajayritykselle:**

- Tuoteluokkakohtainen ennusteväli kertoo, minkä kokoisiin kilpailutuksiin kannattaa varautua. Jos oma kapasiteetti riittää vain luokan mediaanihankintaan, tiedät heti, kuinka suuri osa markkinasta jää ulottumattomiin ilman kumppania.
- Arvion ja toteuman suhde kertoo, kuinka paljon tilaa hankintayksikön arviossa tyypillisesti on.

## Mitä tämä tarkoittaa yrityksellesi?

Sama menetelmäpaketti (paksun hännän mallintaminen, hierarkkinen bayesilainen ennuste ja vastaskenaariot) toimii kaikkialla, missä rahavirrat ovat epätasaisia. Muutama ajatus, jotka eivät ehkä tule ensimmäisenä mieleen:

- **Myyntiputken arvo jakaumana.** Myyntijohtaja raportoi hallitukselle usein yhden luvun: "putkessa on 12 miljoonaa". Jos kaupat ovat paksuhäntäisiä, kuten julkisissa hankinnoissa, luku voi riippua yhdestä jättidiilistä. Bayesilainen putkimalli kertoo todennäköisyyden sille, että kvartaalin tavoite täyttyy, ja sen, kuinka paljon tulos riippuu yksittäisistä kaupoista.
- **Vakuutus- ja takausyhtiöt.** Julkisten urakoiden tarjous- ja toteutusvakuudet ovat riskiä, jonka koko noudattaa juuri tässä mitattua häntää. Hännän paksuus on suora syöte vakuutusmaksun ja riskipääoman mitoitukseen.
- **Pankki tai rahoittaja.** Jos yritysasiakkaan liikevaihdosta merkittävä osa tulee julkisista hankinnoista, Hilman jälki-ilmoituksista voi rakentaa ennakoivan riskimittarin: milloin asiakkaan sopimukset päättyvät, ja kuinka todennäköisesti se voittaa ne uudelleen.
- **Rekrytointi- ja henkilöstöpalvelut.** Kuukausittainen ennuste tuoteluokan kilpailutusmääristä kertoo, milloin esimerkiksi rakennus- tai sote-alan työvoiman kysyntä piikkaa, puoli vuotta ennen kuin työpaikkailmoitukset ilmestyvät.
- **Sisäinen tarkastus missä tahansa organisaatiossa.** Ostolaskut, matkalaskut ja vakuutuskorvaukset ovat kaikki paksuhäntäisiä. Euromääräinen otanta ja hännän seuranta ovat halvin tapa kasvattaa valvonnan kattavuutta lisäämättä henkilöstöä.
- **Hankintayksikkö itse.** Mallilla voi tarkistaa, onko oma arvio realistinen, ennen kuin tarjouspyyntö lähtee. Kun arvio on oikean kokoinen, valitaan oikea menettely, oikea kynnysarvo ja oikea budjetti.

Rakennan tällaisia malleja avoimesta datasta ja asiakkaan omasta datasta: kertaluonteisina analyyseina, jatkuvina seurantapalveluina tai vuokrattavana data-asiantuntijana organisaatioosi. **[Varaa maksuton 30 minuutin keskustelu](https://www.kristianvepsalainen.com)**, niin katsotaan, mitä jakaumat kertovat sinun liiketoiminnastasi.

---

### Lähteet

**Data**

- Hilma – hankintailmoitukset.fi, avoin rajapinta (AVP). Hansel Oy. Maksuton, kaupallinen käyttö sallittu.
- Eurostat: HICP – annual average indices (`prc_hicp_aind`) ja Government revenue, expenditure and main aggregates (`gov_10a_main`).

**Tutkimus**

- Axtell, R. L. (2001). Zipf distribution of U.S. firm sizes. *Science*, 293(5536), 1818–1820.
- Cavalieri, M., Cristaudo, R. & Guccio, C. (2019). Tales on the dark side of the transport infrastructure provision: a systematic literature review of the determinants of cost overruns. *Transport Reviews*, 39(6), 774–794.
- Flyvbjerg, B., Skamris Holm, M. K. & Buhl, S. L. (2003). How common and how large are cost overruns in transport infrastructure projects? *Transport Reviews*, 23(1), 71–88.
- Flyvbjerg, B., Budzier, A., Lee, J. S., Keil, M., Lunn, D. & Bester, D. W. (2022). The empirical reality of IT project cost overruns: Discovering a power-law distribution. *Journal of Management Information Systems*, 39(3), 607–639.

*Koodi: R (tidyverse, brms, ggdist). Kaikki analyysit ovat toistettavissa avoimella datalla.*