---
title: "Sähköautot eivät ole siellä missä laturit"
subtitle: "Latausverkko jakaumana, osa 3: kuntakohtainen sähköistymisaste ja latauspistokkeiden riittävyys"
description: |
Suomen sähköistymisaste on yksi luku. Kuntakohtaisesti se vaihtelee
moninkertaisesti, ja pienissä kunnissa sitä ei tiedetä tarkasti. Rakennamme
hierarkkisen mallin, joka kertoo kunnittain sekä arvion että sen
epävarmuuden, ja vertaamme autokantaa latauspistokkeisiin.
date: 2026-09-15
categories: [avoin data, bayes, latausverkko, alueellisuus, hierarkkinen malli]
---
```{r}
#| label: setup
#| include: false
#| cache: false
library(here)
library(tidyverse)
library(sf)
library(giscoR)
library(ggdist)
library(patchwork)
library(qs2)
library(scales)
library(brms)
library(tidybayes)
select <- dplyr::select
filter <- dplyr::filter
source(here("R", "theme_kristian.R"))
knitr::opts_chunk$set(
echo = FALSE, warning = FALSE, message = FALSE,
fig.width = 9, fig.height = 5.5, dpi = 150
)
theme_set(theme_kristian())
pal <- c(punainen = "#e63946", turkoosi = "#2a9d8f", oranssi = "#f4a261",
navy = "#1d3557", sininen = "#457b9d")
data_dir <- here("data", "latausverkko")
dir.create(data_dir, showWarnings = FALSE, recursive = TRUE)
set.seed(42)
asemat <- qs2::qd_read(file.path(data_dir, "asemat.qs"))
liitokset <- qs2::qd_read(file.path(data_dir, "liitokset.qs"))
```
## Yksi luku, joka piilottaa kaiken olennaisen
Suomen sähköautoistumisesta puhutaan yhtenä prosenttilukuna. Niin monta
prosenttia henkilöautoista on täyssähköautoja. Luku nousee vuosittain, ja siitä
uutisoidaan.
Luku on totta koko maan tasolla ja lähes hyödytön kaikessa muussa. Sähköauton
hankinta riippuu siitä, voiko sen ladata kotona, kuinka pitkiä matkoja ajetaan
ja millainen latausverkko on lähialueella. Nämä eroavat Suomen sisällä enemmän
kuin monen maan välillä.
Tässä osassa katson, miten sähköautot ovat jakautuneet kunnittain, ja vertaan
autokantaa latauspistokkeisiin. Matkalla tulee vastaan tilastollinen ongelma,
joka toistuu kaikessa aluevertailussa ja jonka ohittaminen tuottaa
säännönmukaisesti vääriä johtopäätöksiä: **pienissä kunnissa osuudet heittelevät
sattumalta, ja ilman korjausta ne valtaavat kaikki kärkisijat.**
## Aineiston hakeminen
Traficomin tilastotietokanta tarjoaa kuntatason ajoneuvokannan avoimena
rajapintana. Kanta ei ole sama kuin Tilastokeskuksen StatFin, vaikka se pyörii
samalla alustalla — se on Traficomin oma tietokanta omassa osoitteessaan. Tämä
kannattaa tietää, koska StatFinistä taulua ei löydy.
Rajapinta on toiminnaltaan kankea. Kysely on rajattava tarkasti, koska
solumäärälle on katto, eivätkä kaikki muuttujat ole pilkottavissa osiin. Lisäksi
näiden tietokantojen rakenteeseen tehtiin kesäkuussa 2026 muutos, jossa
muuttujien tunnisteet vaihtuivat — kysely, joka toimi keväällä, ei välttämättä
toimi nyt.
Tästä seuraa työtapa, jota suosittelen kaikkeen avoimen datan käyttöön: **hae
kerran, tallenna, älä koske rajapintaan uudelleen.**
```{r}
#| label: aineiston-luku
#| echo: true
#| cache: false
kanta_path <- file.path(data_dir, "autokanta.qs")

# Aineisto haetaan rajapinnasta kerran ja tallennetaan levylle. Sen jälkeen
# jokainen ajo lukee tiedostosta eikä koske rajapintaan lainkaan. Tämä on
# tietoinen valinta: rajapinnat muuttuvat, tiedostot eivät.
stopifnot(
  "Aineisto puuttuu. Hae se kerran ohjeen mukaan (ks. teksti alla)." =
    file.exists(kanta_path)
)

autokanta <- qs2::qd_read(kanta_path)

# Sarakenimet tulevat suoraan rajapinnasta ja voivat muuttua taulupäivityksessä,
# joten ne tunnistetaan sisällön perusteella eikä sijainnin.
tunnista_sarake <- function(df, hakusana) {
  osuma <- names(df)[str_detect(names(df), regex(hakusana, ignore_case = TRUE))]
  stopifnot("Saraketta ei löytynyt tai osumia oli useita" = length(osuma) == 1)
  osuma
}

sar_alue   <- tunnista_sarake(autokanta, "^Alue$")
sar_merkki <- tunnista_sarake(autokanta, "^Merkki$")
sar_vuosi  <- tunnista_sarake(autokanta, "vuosi")
sar_voima  <- tunnista_sarake(autokanta, "voima")
sar_arvo   <- setdiff(names(autokanta),
                      c(sar_alue, sar_merkki, sar_vuosi, sar_voima))

stopifnot(
  "Arvosaraketta ei tunnistettu yksikäsitteisesti" = length(sar_arvo) == 1
)

autokanta <- autokanta |>
  rename(alue = all_of(sar_alue), merkki = all_of(sar_merkki),
         vuosi = all_of(sar_vuosi), voima = all_of(sar_voima),
         n = all_of(sar_arvo))

# Rajapinta palauttaa tyhjän solun silloin kun kunnassa ei ole yhtäkään
# kyseisen merkin ja käyttövoiman yhdistelmää. Tyhjä tarkoittaa siis nollaa,
# ei tuntematonta. Ero on olennainen: jos tyhjät tulkittaisiin puuttuvaksi
# tiedoksi, kuntien summat jäisivät vajaiksi.
osuus_tyhjia <- mean(is.na(autokanta$n))

stopifnot(
  "Käyttöönottovuosi ei ole rajattu yhteen arvoon" = n_distinct(autokanta$vuosi) == 1,
  "Negatiivisia autolukuja" = all(autokanta$n >= 0, na.rm = TRUE),
  "Odotettuja käyttövoimia puuttuu" =
    all(c("Yhteensä", "Sähkö") %in% autokanta$voima),
  "Alueita on odottamaton määrä" = between(n_distinct(autokanta$alue), 280, 300)
)

# Tulkinnan oikeellisuus varmistetaan aineistosta itsestään: jos tyhjät ovat
# nollia, merkkikohtaisten rivien summa täsmää yhteensä-riviin. Jos ne
# olisivat salattuja lukuja, summa jäisi systemaattisesti vajaaksi.
tarkistus_summa <- autokanta |>
  filter(voima == "Yhteensä") |>
  group_by(alue) |>
  summarise(
    yhteensa_rivi = sum(n[merkki == "Henkilöautot yhteensä"], na.rm = TRUE),
    merkkien_summa = sum(n[merkki != "Henkilöautot yhteensä" &
                             !str_detect(merkki, "yhteensä")], na.rm = TRUE),
    .groups = "drop"
  ) |>
  mutate(ero = abs(merkkien_summa - yhteensa_rivi) / pmax(yhteensa_rivi, 1))

stopifnot(
  "Merkkikohtaiset luvut eivät summaudu yhteensä-riviin – tyhjät eivät ole nollia" =
    median(tarkistus_summa$ero, na.rm = TRUE) < 0.02
)
```
Aineisto haetaan kerran ja tallennetaan levylle. Sen jälkeen jokainen ajo lukee
tiedostosta eikä ota rajapintaan yhteyttä lainkaan. Tämä ei ole pelkkä
nopeusoptimointi vaan periaate: rajapinnat muuttuvat ja menevät rikki,
tiedostot eivät. Analyysin toistettavuus ei saa riippua siitä, että
kolmannen osapuolen palvelin vastaa tänään samalla tavalla kuin eilen.
Haku tehdään kerran seuraavasti:
```r
# Aja tämä kerran konsolissa, ei osana dokumentin renderöintiä
px_url <- paste0("https://trafi2.stat.fi/PXWeb/api/v1/fi/TraFi/",
                 "TraFi__Liikennekaytossa_olevat_ajoneuvot/010_kanta_tau_101.px")

kysely <- pxweb::pxweb_query(list(
  "Alue"              = "*",
  "Merkki"            = "*",
  "Käyttöönottovuosi" = "Yhteensä",
  "Käyttövoima"       = "*"
))

raaka <- pxweb::pxweb_get_data(px_url, kysely)
qs2::qd_save(tibble::as_tibble(raaka),
             here::here("data", "latausverkko", "autokanta.qs"))
```
Käyttöönottovuosi on rajattava yhteen arvoon. Ilman rajausta kyselystä tulisi
lähes 600 000 solua, ja rajapinnan katto on noin 110 000 — muut kolme muuttujaa
eivät ole pilkottavissa eriin, joten haku ei mene läpi millään
uudelleenyrityksellä.
### Tyhjä solu ei ole puuttuva tieto
Aineistossa on runsaasti tyhjiä soluja:
`r percent(osuus_tyhjia, accuracy = 0.1)` riveistä. Syy on rakenteellinen. Taulu
sisältää jokaisen kunnan ja jokaisen automerkin ja jokaisen käyttövoiman
yhdistelmän, ja valtaosaa niistä ei ole olemassa — pienessä kunnassa ei ole
yhtään vetykäyttöistä Aston Martinia.
Tyhjä solu tarkoittaa siis nollaa, ei tuntematonta. Ero on ratkaiseva. Jos
tyhjät tulkittaisiin puuttuvaksi tiedoksi ja jätettäisiin laskuista pois, tulos
olisi sama; mutta jos ne tulkittaisiin salatuiksi luvuiksi — mitä ne joissakin
tilastoissa ovat — kuntien summat olisivat systemaattisesti liian pieniä.
En luota tässä oletukseen vaan tarkistan sen aineistosta. Jos tyhjät ovat
nollia, merkkikohtaisten rivien summa täsmää kunnan yhteensä-riviin. Jos ne
olisivat salattuja lukuja, summa jäisi vajaaksi. Koodissa oleva tarkistus
pysäyttää ajon, jos näin käy.
Tämä on pieni yksityiskohta, mutta juuri tällaiset kaatavat analyysejä
hiljaisesti. Puuttuvan arvon merkitys ei ole koskaan itsestään selvä, ja se on
harvoin dokumentoitu.
```{r}
#| label: kuntataso
#| echo: true
kunnat <- autokanta |>
  filter(
    merkki == "Henkilöautot yhteensä",
    !str_detect(alue, "MANNER-SUOMI|Ulkomaat|Tuntematon")
  ) |>
  mutate(luokka = case_when(
    voima == "Yhteensä" ~ "kaikki",
    voima == "Sähkö" ~ "sahko",
    str_detect(voima, "ladattava hybridi") ~ "phev",
    TRUE ~ NA_character_
  )) |>
  filter(!is.na(luokka)) |>
  group_by(kunta = alue, luokka) |>
  summarise(n = sum(n, na.rm = TRUE), .groups = "drop") |>
  pivot_wider(names_from = luokka, values_from = n, values_fill = 0) |>
  mutate(
    osuus_sahko = sahko / kaikki,
    osuus_ladattava = (sahko + phev) / kaikki
  ) |>
  filter(kaikki > 0)

stopifnot(
  "Kuntia ei kertynyt odotettua määrää" = between(nrow(kunnat), 280, 300),
  "Sähköautoja enemmän kuin autoja yhteensä" = all(kunnat$sahko <= kunnat$kaikki),
  "Osuus ei ole välillä 0–1" = all(between(kunnat$osuus_sahko, 0, 1))
)

koko_maa <- sum(kunnat$sahko) / sum(kunnat$kaikki)
```
Viimeinen tarkistus on tässä tärkein. Jos "Yhteensä"-rivi ei jostain syystä
olisikaan kokonaissumma, osuus voisi ylittää ykkösen — ja se kaataisi myöhemmän
mallin oudolla virheellä, jonka syytä olisi vaikea jäljittää. Parempi pysähtyä
heti.
::: {.callout-warning}
## Aineiston rajaus
Traficomin taulu ei sisällä Ahvenanmaan erillisrekisterissä olevia
henkilöautoja. Ahvenanmaa jää siis tämän tarkastelun ulkopuolelle. Tämä on
tyypillinen esimerkki alaviitteestä, joka on helppo ohittaa mutta joka muuttaa
tulkintaa: "koko Suomen" luku ei kata koko Suomea.
Aineisto kuvaa liikennekäytössä olevia henkilöautoja. Auto, joka on poistettu
liikennekäytöstä mutta ei romutettu, ei näy luvuissa. Alue tarkoittaa ajoneuvon
haltijan kotikuntaa, ei sitä missä autolla ajetaan — leasing- ja yritysautot
voivat siis kirjautua pääkonttorin kuntaan.
:::
## Sähköistymisaste vaihtelee moninkertaisesti
```{r}
#| label: perusluvut
#| echo: true
hajonta <- kunnat |>
  summarise(
    min = min(osuus_sahko), max = max(osuus_sahko),
    q10 = quantile(osuus_sahko, 0.1), q90 = quantile(osuus_sahko, 0.9),
    mediaani = median(osuus_sahko)
  )

suhde_90_10 <- hajonta$q90 / hajonta$q10
```
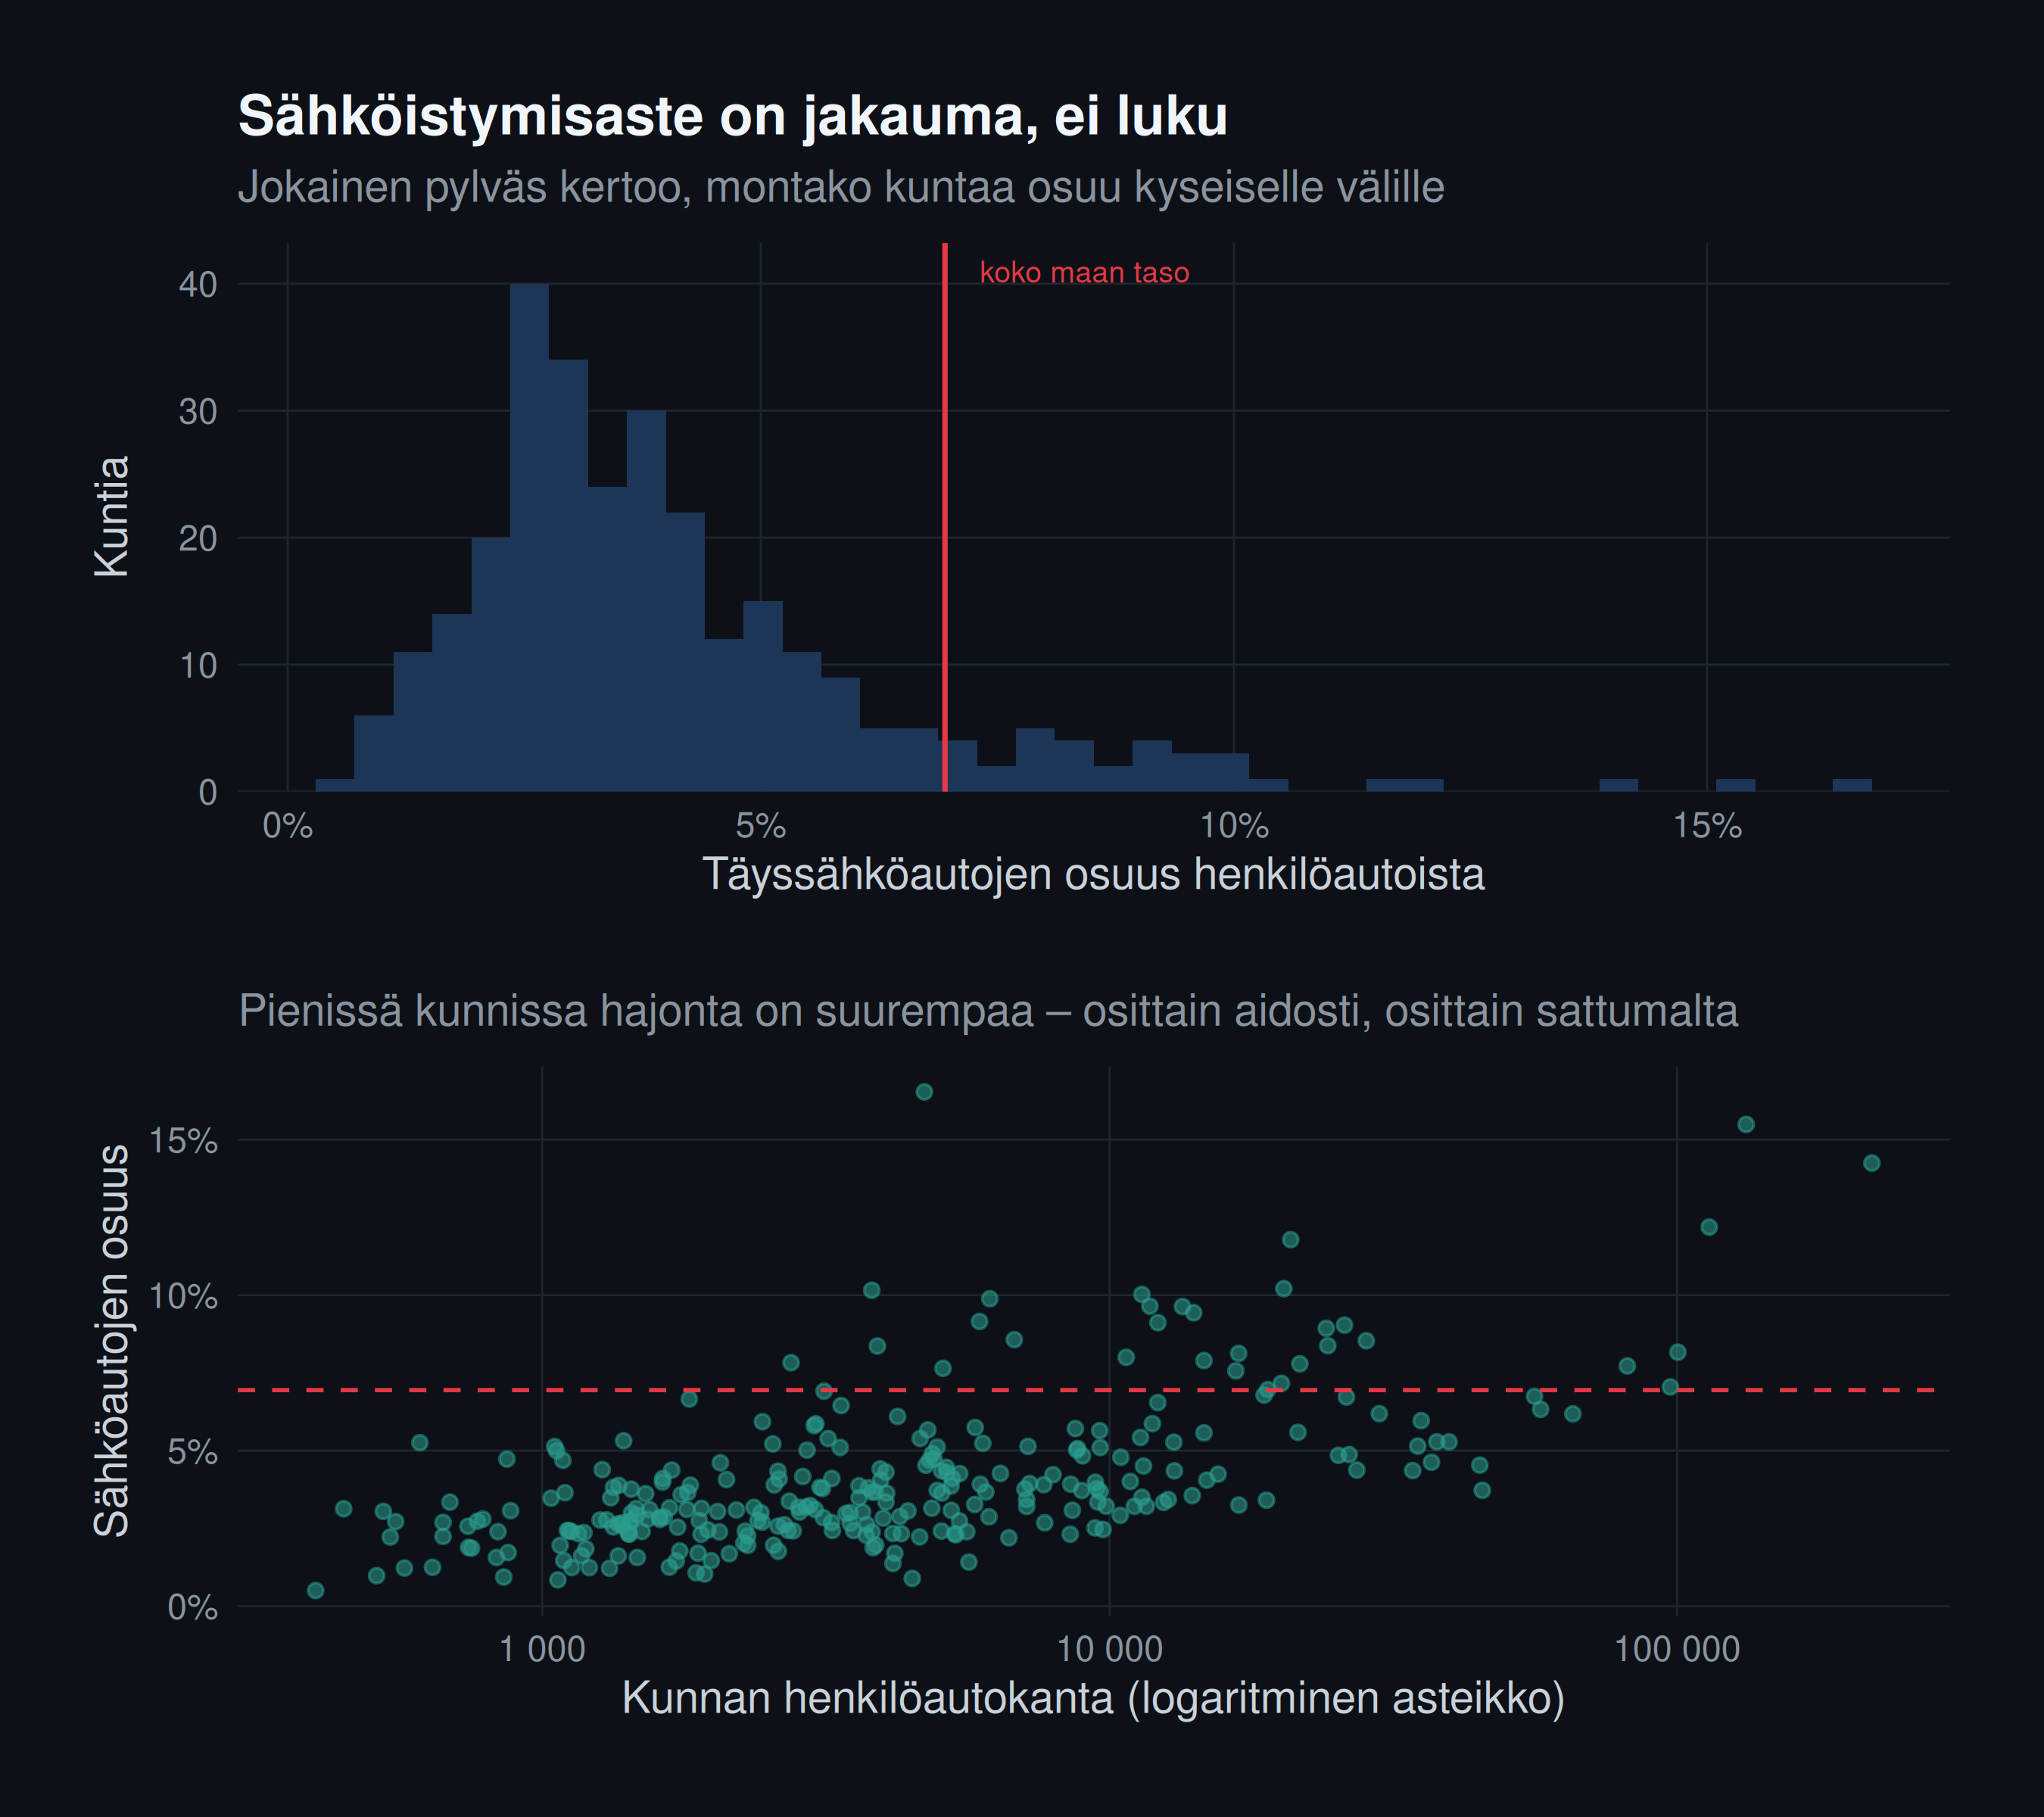
Koko maan sähköistymisaste on **`r percent(koko_maa, accuracy = 0.1)`**.
Kuntakohtaisesti se vaihtelee `r percent(hajonta$min, accuracy = 0.1)`:sta
`r percent(hajonta$max, accuracy = 0.1)`:iin. Kymmenennen ja yhdeksännenkymmenennen
prosenttipisteen suhde on
`r format(round(suhde_90_10, 1), decimal.mark = ",")`-kertainen — eli
kärkipäässä olevissa kunnissa sähköistymisaste on moninkertainen häntäpäähän
verrattuna.
```{r}
#| label: kuva-hajonta
#| fig-cap: "Kuntien sähköistymisasteet. Ylhäällä jakauma, alhaalla riippuvuus kunnan autokannan koosta."
#| fig-height: 8
p1 <- kunnat |>
ggplot(aes(osuus_sahko)) +
geom_histogram(bins = 40, fill = pal["navy"], colour = NA) +
geom_vline(xintercept = koko_maa, colour = pal["punainen"], linewidth = 0.8) +
annotate("text", x = koko_maa, y = Inf, hjust = -0.08, vjust = 1.8,
label = " koko maan taso", colour = pal["punainen"], size = 3.3) +
scale_x_continuous(labels = percent) +
scale_y_continuous(expand = expansion(mult = c(0, 0.08))) +
labs(x = "Täyssähköautojen osuus henkilöautoista", y = "Kuntia",
title = "Sähköistymisaste on jakauma, ei luku",
subtitle = "Jokainen pylväs kertoo, montako kuntaa osuu kyseiselle välille")
p2 <- kunnat |>
ggplot(aes(kaikki, osuus_sahko)) +
geom_point(colour = pal["turkoosi"], alpha = 0.55, size = 1.8) +
geom_hline(yintercept = koko_maa, colour = pal["punainen"], linetype = 2) +
scale_x_log10(labels = label_number(big.mark = " ")) +
scale_y_continuous(labels = percent) +
labs(x = "Kunnan henkilöautokanta (logaritminen asteikko)",
y = "Sähköautojen osuus",
subtitle = "Pienissä kunnissa hajonta on suurempaa – osittain aidosti, osittain sattumalta")
p1 / p2
```
**Miten alempaa kuvaa luetaan.** Jokainen piste on yksi kunta. Vaaka-akselilla
on kunnan henkilöautojen kokonaismäärä, pystyakselilla sähköautojen osuus.
Vaaka-akseli on logaritminen. Se tarkoittaa, että sama matka akselilla vastaa
aina samaa kerrointa: matka tuhannesta kahteentuhanteen on yhtä pitkä kuin
sadastatuhannesta kahteensataantuhanteen. Ilman tätä Helsinki venyttäisi kuvan
niin, että kaikki muut kunnat puristuisivat vasempaan reunaan.
Kuvassa näkyy suppilomainen muoto: mitä pienempi kunta, sitä enemmän pisteet
hajaantuvat pystysuunnassa. Osa hajonnasta on aitoa — kunnat oikeasti eroavat
toisistaan — mutta osa on pelkkää sattumaa. Näiden erottaminen on seuraavan
luvun aihe.
### Ero ei ole kaupunki vastaan maaseutu
Ennen kuin mennään menetelmiin, kannattaa katsoa suurimpia kuntia. Niissä
satunnaisvaihtelu on pienintä, joten luvut ovat luotettavia sellaisenaan.
```{r}
#| label: suuret-kunnat
#| echo: true
pks <- c("Helsinki", "Espoo", "Vantaa", "Kauniainen")

suuret <- kunnat |>
  slice_max(kaikki, n = 15) |>
  mutate(
    ryhma = if_else(kunta %in% pks, "Pääkaupunkiseutu", "Muu suuri kunta"),
    kunta = fct_reorder(kunta, osuus_sahko)
  )

pks_taso <- kunnat |> filter(kunta %in% pks) |>
  summarise(o = sum(sahko) / sum(kaikki)) |> pull(o)
muut_taso <- kunnat |> filter(!kunta %in% pks) |>
  summarise(o = sum(sahko) / sum(kaikki)) |> pull(o)
```
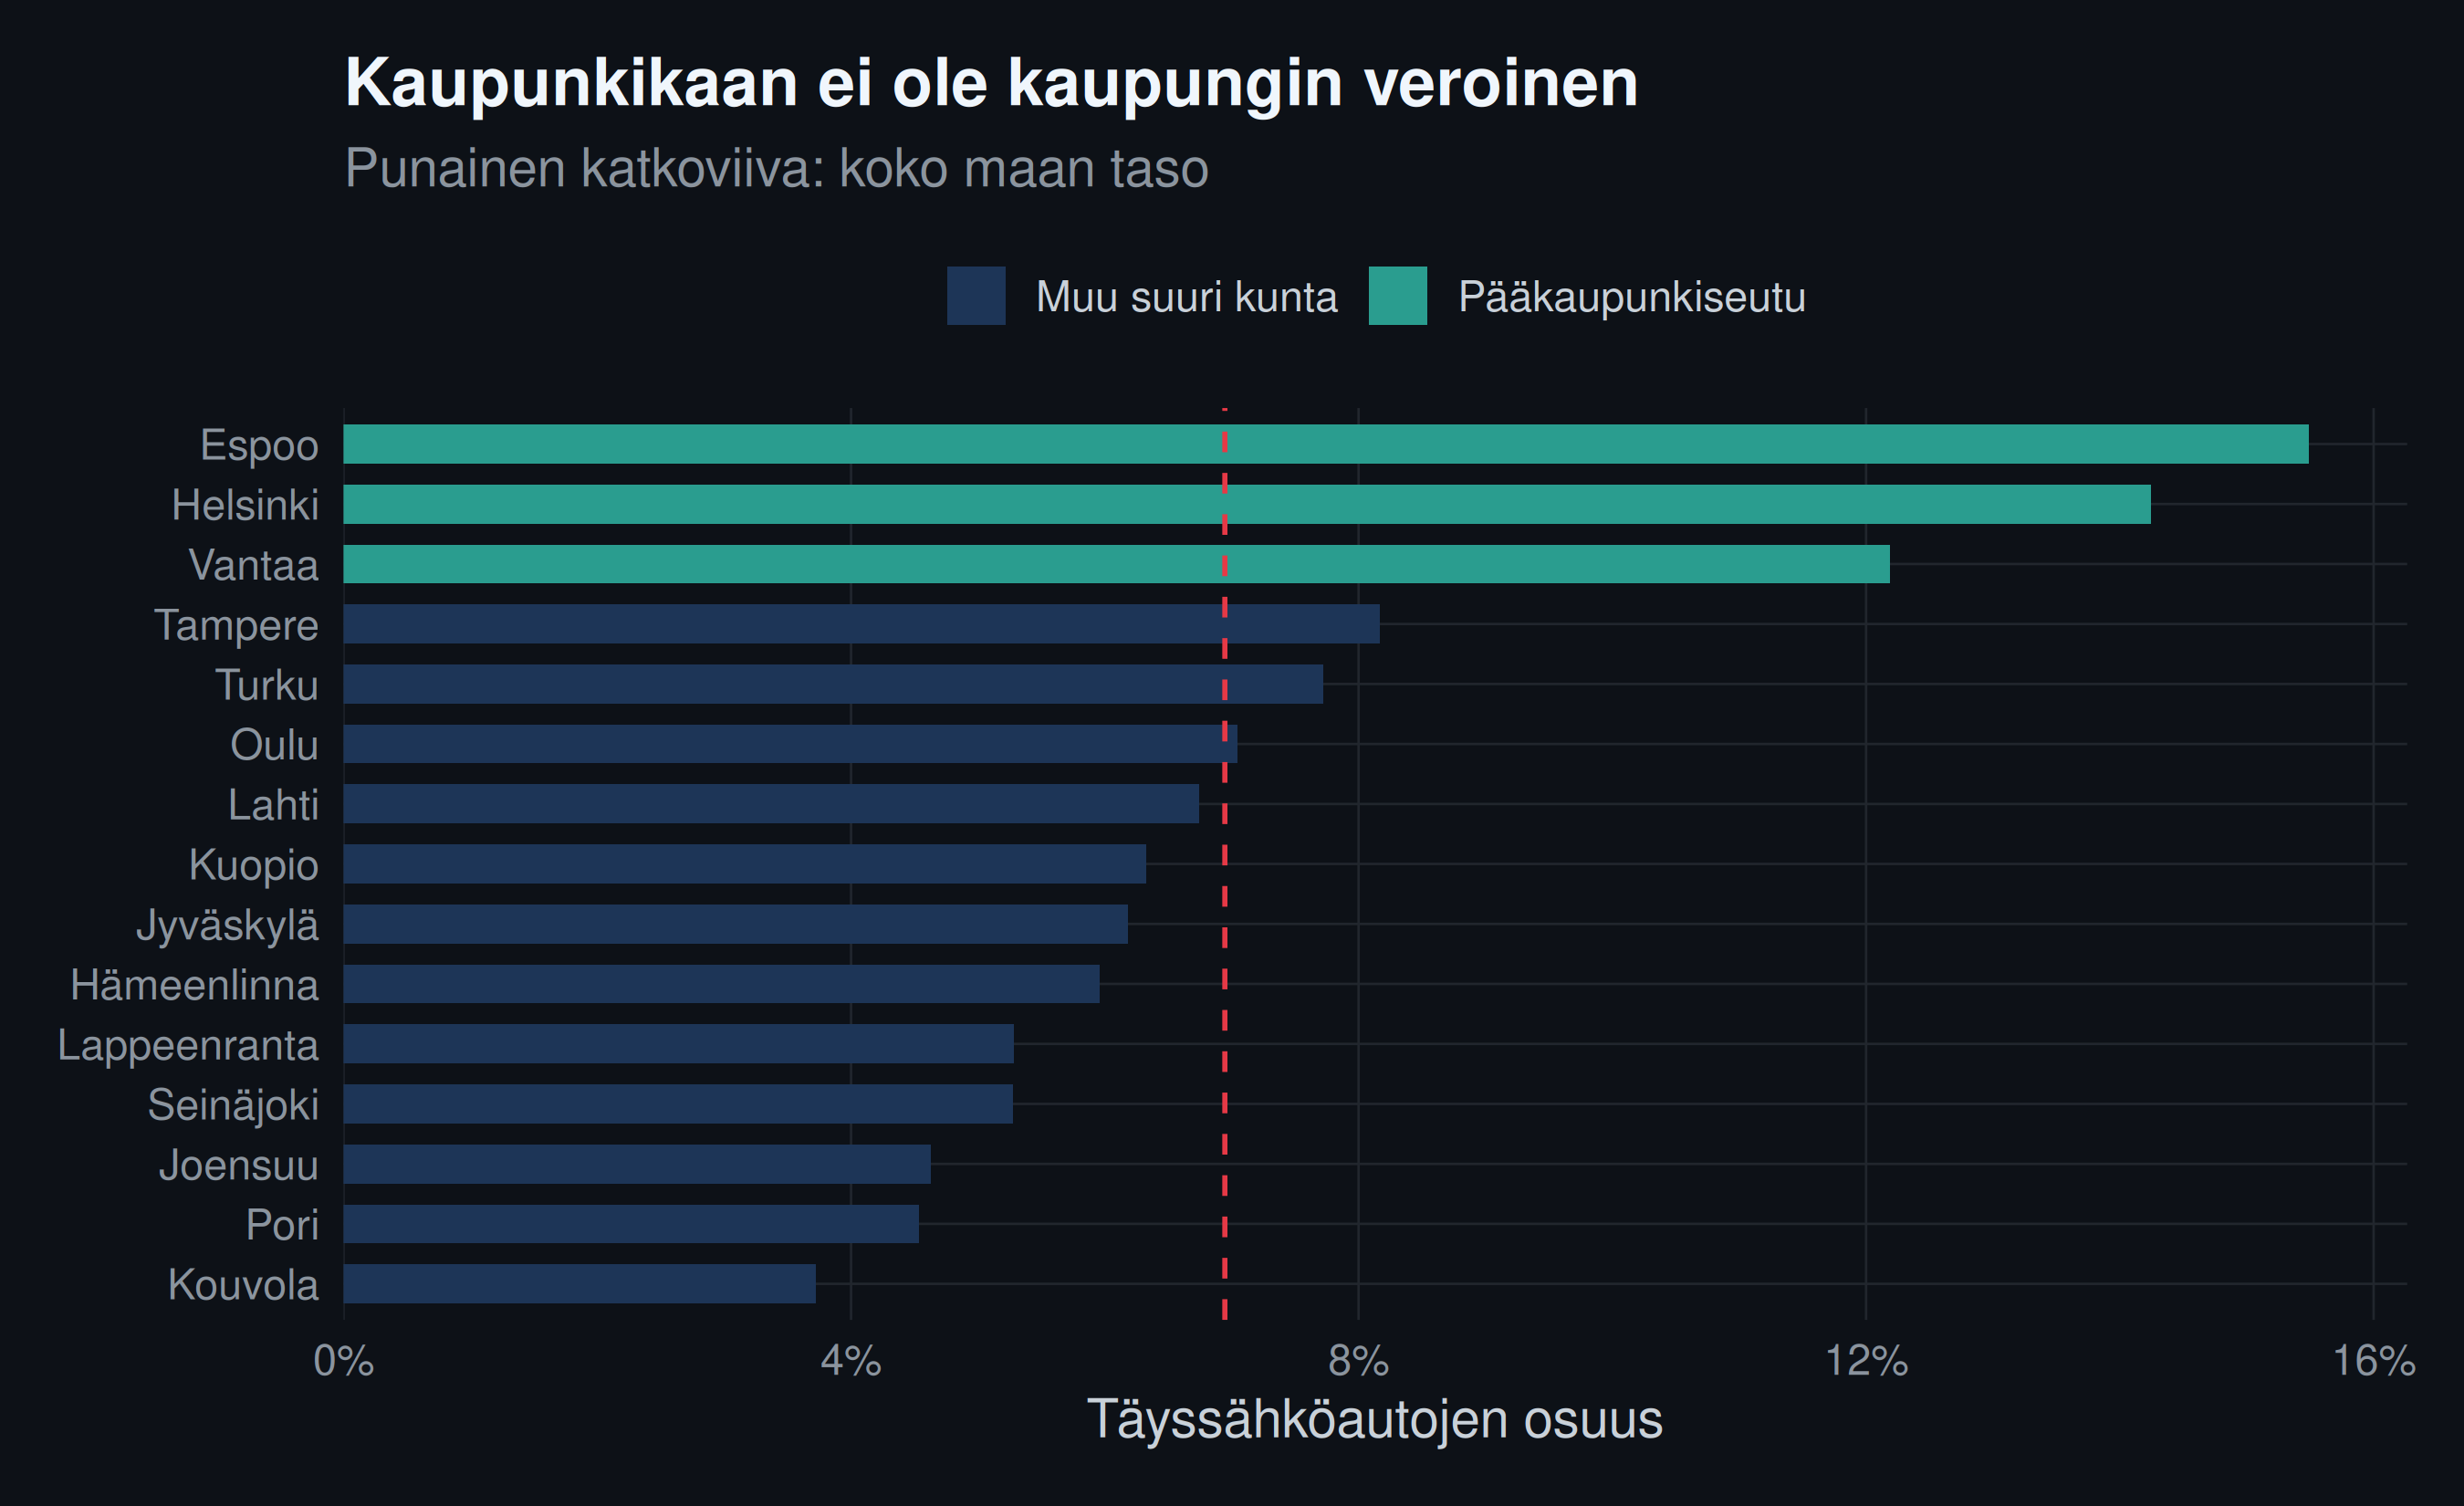
Pääkaupunkiseudun sähköistymisaste on
`r percent(pks_taso, accuracy = 0.1)` ja muun maan
`r percent(muut_taso, accuracy = 0.1)` — eli
`r format(round(pks_taso / muut_taso, 1), decimal.mark = ",")`-kertainen.
```{r}
#| label: kuva-suuret
#| fig-cap: "Sähköistymisaste Suomen 15 suurimmassa kunnassa autokannan mukaan mitattuna."
ggplot(suuret, aes(osuus_sahko, kunta, fill = ryhma)) +
geom_col(width = 0.65) +
geom_vline(xintercept = koko_maa, colour = pal["punainen"], linetype = 2) +
scale_fill_manual(values = c("Pääkaupunkiseutu" = unname(pal["turkoosi"]),
"Muu suuri kunta" = unname(pal["navy"]))) +
scale_x_continuous(labels = percent,
expand = expansion(mult = c(0, 0.05))) +
labs(x = "Täyssähköautojen osuus", y = NULL, fill = NULL,
title = "Kaupunkikaan ei ole kaupungin veroinen",
subtitle = "Punainen katkoviiva: koko maan taso")
```
Tämä on kiinnostavampi tulos kuin tavanomainen kaupunki–maaseutu-vastakkainasettelu.
Tampere ja Oulu ovat suuria yliopistokaupunkeja, mutta niiden sähköistymisaste
on lähempänä koko maan tasoa kuin pääkaupunkiseutua. Ero ei siis synny
kaupunkimaisuudesta sinänsä.
Todennäköisiä selityksiä on useita, eikä tämä aineisto erottele niitä: tulotaso,
työsuhdeautojen yleisyys, uudehkon asuntokannan latausvalmius, työmatkojen
pituus. Kaikki nämä ovat pääkaupunkiseudulla erilaisia kuin muualla, ja ne
korreloivat keskenään.
Olennaista on, että **yksinkertainen kaupunki–maaseutu-jaottelu ei tavoita
ilmiötä.** Jos latausinfran tukea kohdennettaisiin kaupunkimaisuuden
perusteella, kohdennus osuisi väärin — Tampere ja Espoo näyttäisivät samalta
vaikka niiden sähköautokannat eroavat lähes kaksinkertaisesti.
## Miksi pienten kuntien luvut eivät ole vertailukelpoisia
Kuvitellaan kunta, jossa on sata henkilöautoa. Jos niistä neljä on sähköautoja,
osuus on 4 %. Jos yksi asukas vaihtaa autonsa sähköautoon, osuus hyppää
5 %:iin — se nousee neljänneksellä yhden hankinnan takia.
Kunnassa, jossa on satatuhatta autoa, sama yksi hankinta ei näy missään.
Tästä seuraa, että **pienten kuntien osuudet ovat epäluotettavampia mutta
näyttävät aivan yhtä tarkoilta**. Kun kunnat laitetaan järjestykseen
sähköistymisasteen mukaan, kärkeen ja hännille valikoituvat systemaattisesti
pienimmät kunnat — eivät siksi, että ne olisivat erilaisia, vaan siksi, että
niissä satunnaisvaihtelu on suurinta.
Tämä ei ole pikkuseikka. Se on syy siihen, miksi lehdissä nähdään otsikoita
tyyliin "tässä ovat Suomen sähköisimmät kunnat" ja lista on täynnä pieniä
kuntia. Sama ilmiö tuottaa harhaisia listoja kouluvertailuissa,
rikostilastoissa ja terveyseroissa. Ilmiö on tilastotieteessä hyvin tunnettu ja
sen korjaaminen on rutiinia — mutta vain jos sen tekee.
### Ratkaisu: hierarkkinen malli
Korjaus tunnetaan nimellä osittainen yhdistäminen (*partial pooling*). Ajatus on
seuraava.
Meillä on kaksi äärivaihtoehtoa. Voimme käyttää kunnan omaa havaittua osuutta
sellaisenaan — mikä on tarkka suurissa kunnissa ja epäluotettava pienissä. Tai
voimme olettaa kaikki kunnat samanlaisiksi ja käyttää koko maan tasoa — mikä on
vakaa mutta hukkaa kaiken aidon vaihtelun.
Hierarkkinen malli tekee näiden välimuodon ja painottaa sen automaattisesti
oikein. Suuressa kunnassa havainto saa lähes täyden painon. Pienessä kunnassa
arviota vedetään kohti koko maan tasoa sitä enemmän, mitä vähemmän havaintoja
on. Vetoa kutsutaan kutistamiseksi (*shrinkage*).
Malli ei siis oleta pieniä kuntia keskimääräisiksi. Se sanoo: tästä kunnasta on
niin vähän tietoa, että paras arvaus on lähempänä yleistä tasoa kuin havaittu
poikkeama antaisi ymmärtää. Jos kunnasta kertyy lisää havaintoja ja poikkeama
osoittautuu pysyväksi, malli seuraa perässä.
```{r}
#| label: brms-malli
#| echo: true
malli_path <- file.path(data_dir, "malli_sahkoistyminen.qs")

if (!file.exists(malli_path)) {
  malli <- brm(
    sahko | trials(kaikki) ~ 1 + (1 | kunta),
    data = kunnat,
    family = binomial(),
    prior = c(
      prior(normal(-3, 1.5), class = "Intercept"),
      prior(exponential(2), class = "sd")
    ),
    # Vakiotermi ja satunnaisvaikutukset ovat hierarkkisessa mallissa
    # vahvasti kytköksissä toisiinsa, mikä hidastaa ketjujen sekoittumista.
    # Ongelma ei ole mallissa vaan geometriassa, ja se ratkeaa vedoilla.
    chains = 4, iter = 8000, warmup = 2000, cores = 4,
    seed = 42, refresh = 0
  )
  qs2::qs_save(malli, malli_path)
} else {
  malli <- qs2::qs_read(malli_path)
}

# Rhat kertoo, ovatko ketjut päätyneet samaan paikkaan. Efektiivinen otoskoko
# kertoo, montako riippumatonta vetoa niistä on saatu. Jälkimmäinen on tässä
# ratkaisevampi, koska tulokset raportoidaan 95 %:n väleinä ja jakauman
# häntien arviointi vaatii selvästi enemmän vetoja kuin keskiarvon.
diagnostiikka <- summary(malli)
ess_kiinteat <- min(diagnostiikka$fixed$Bulk_ESS, diagnostiikka$fixed$Tail_ESS)
ess_satunnaiset <- min(diagnostiikka$random$kunta$Bulk_ESS,
                       diagnostiikka$random$kunta$Tail_ESS)

rhatit <- brms::rhat(malli)
rhatit <- rhatit[!names(rhatit) %in% c("lp__", "lprior")]
pahin_rhat <- max(rhatit, na.rm = TRUE)

if (pahin_rhat >= 1.01 || min(ess_kiinteat, ess_satunnaiset) < 400) {
  message("Korkein Rhat: ", round(pahin_rhat, 4),
          " (", names(which.max(rhatit)), ")",
          " – pienin ESS: ", round(min(ess_kiinteat, ess_satunnaiset)))
}

stopifnot(
  "Ketjut eivät päätyneet samaan paikkaan (Rhat >= 1,01)" = pahin_rhat < 1.01,
  "Efektiivinen otoskoko liian pieni häntien arviointiin" =
    min(ess_kiinteat, ess_satunnaiset) >= 400
)

ennusteet <- kunnat |>
  mutate(kaikki_alkup = kaikki, kaikki = 1) |>
  add_epred_draws(malli, ndraws = 2000) |>
  group_by(kunta) |>
  summarise(
    arvio = median(.epred),
    ala = quantile(.epred, 0.025),
    yla = quantile(.epred, 0.975),
    .groups = "drop"
  ) |>
  left_join(select(kunnat, kunta, kaikki, sahko, phev, osuus_sahko), by = "kunta") |>
  mutate(
    kutistuma = osuus_sahko - arvio,
    valin_leveys = yla - ala
  )

stopifnot(
  "Ennusteita ei tullut jokaiselle kunnalle" = nrow(ennusteet) == nrow(kunnat),
  "Arvio jakauman ulkopuolella" = all(between(ennusteet$arvio, 0, 1))
)
```
**Priorien perustelu.** Mallille pitää kertoa, mitä pidetään uskottavana ennen
kuin aineistoa katsotaan. Vakiotermin prioriksi on asetettu jakauma, joka
vastaa suunnilleen muutaman prosentin sähköistymisastetta — väljä, mutta sulkee
pois mahdottomuudet kuten 90 prosentin osuuden. Kuntien välisen vaihtelun
prioriksi on asetettu jakauma, joka sallii merkittävät erot mutta ei oleta niitä
etukäteen. Kummassakin tapauksessa aineisto on niin laaja, että priorien
vaikutus lopputulokseen jää pieneksi.
```{r}
#| label: kuva-shrinkage
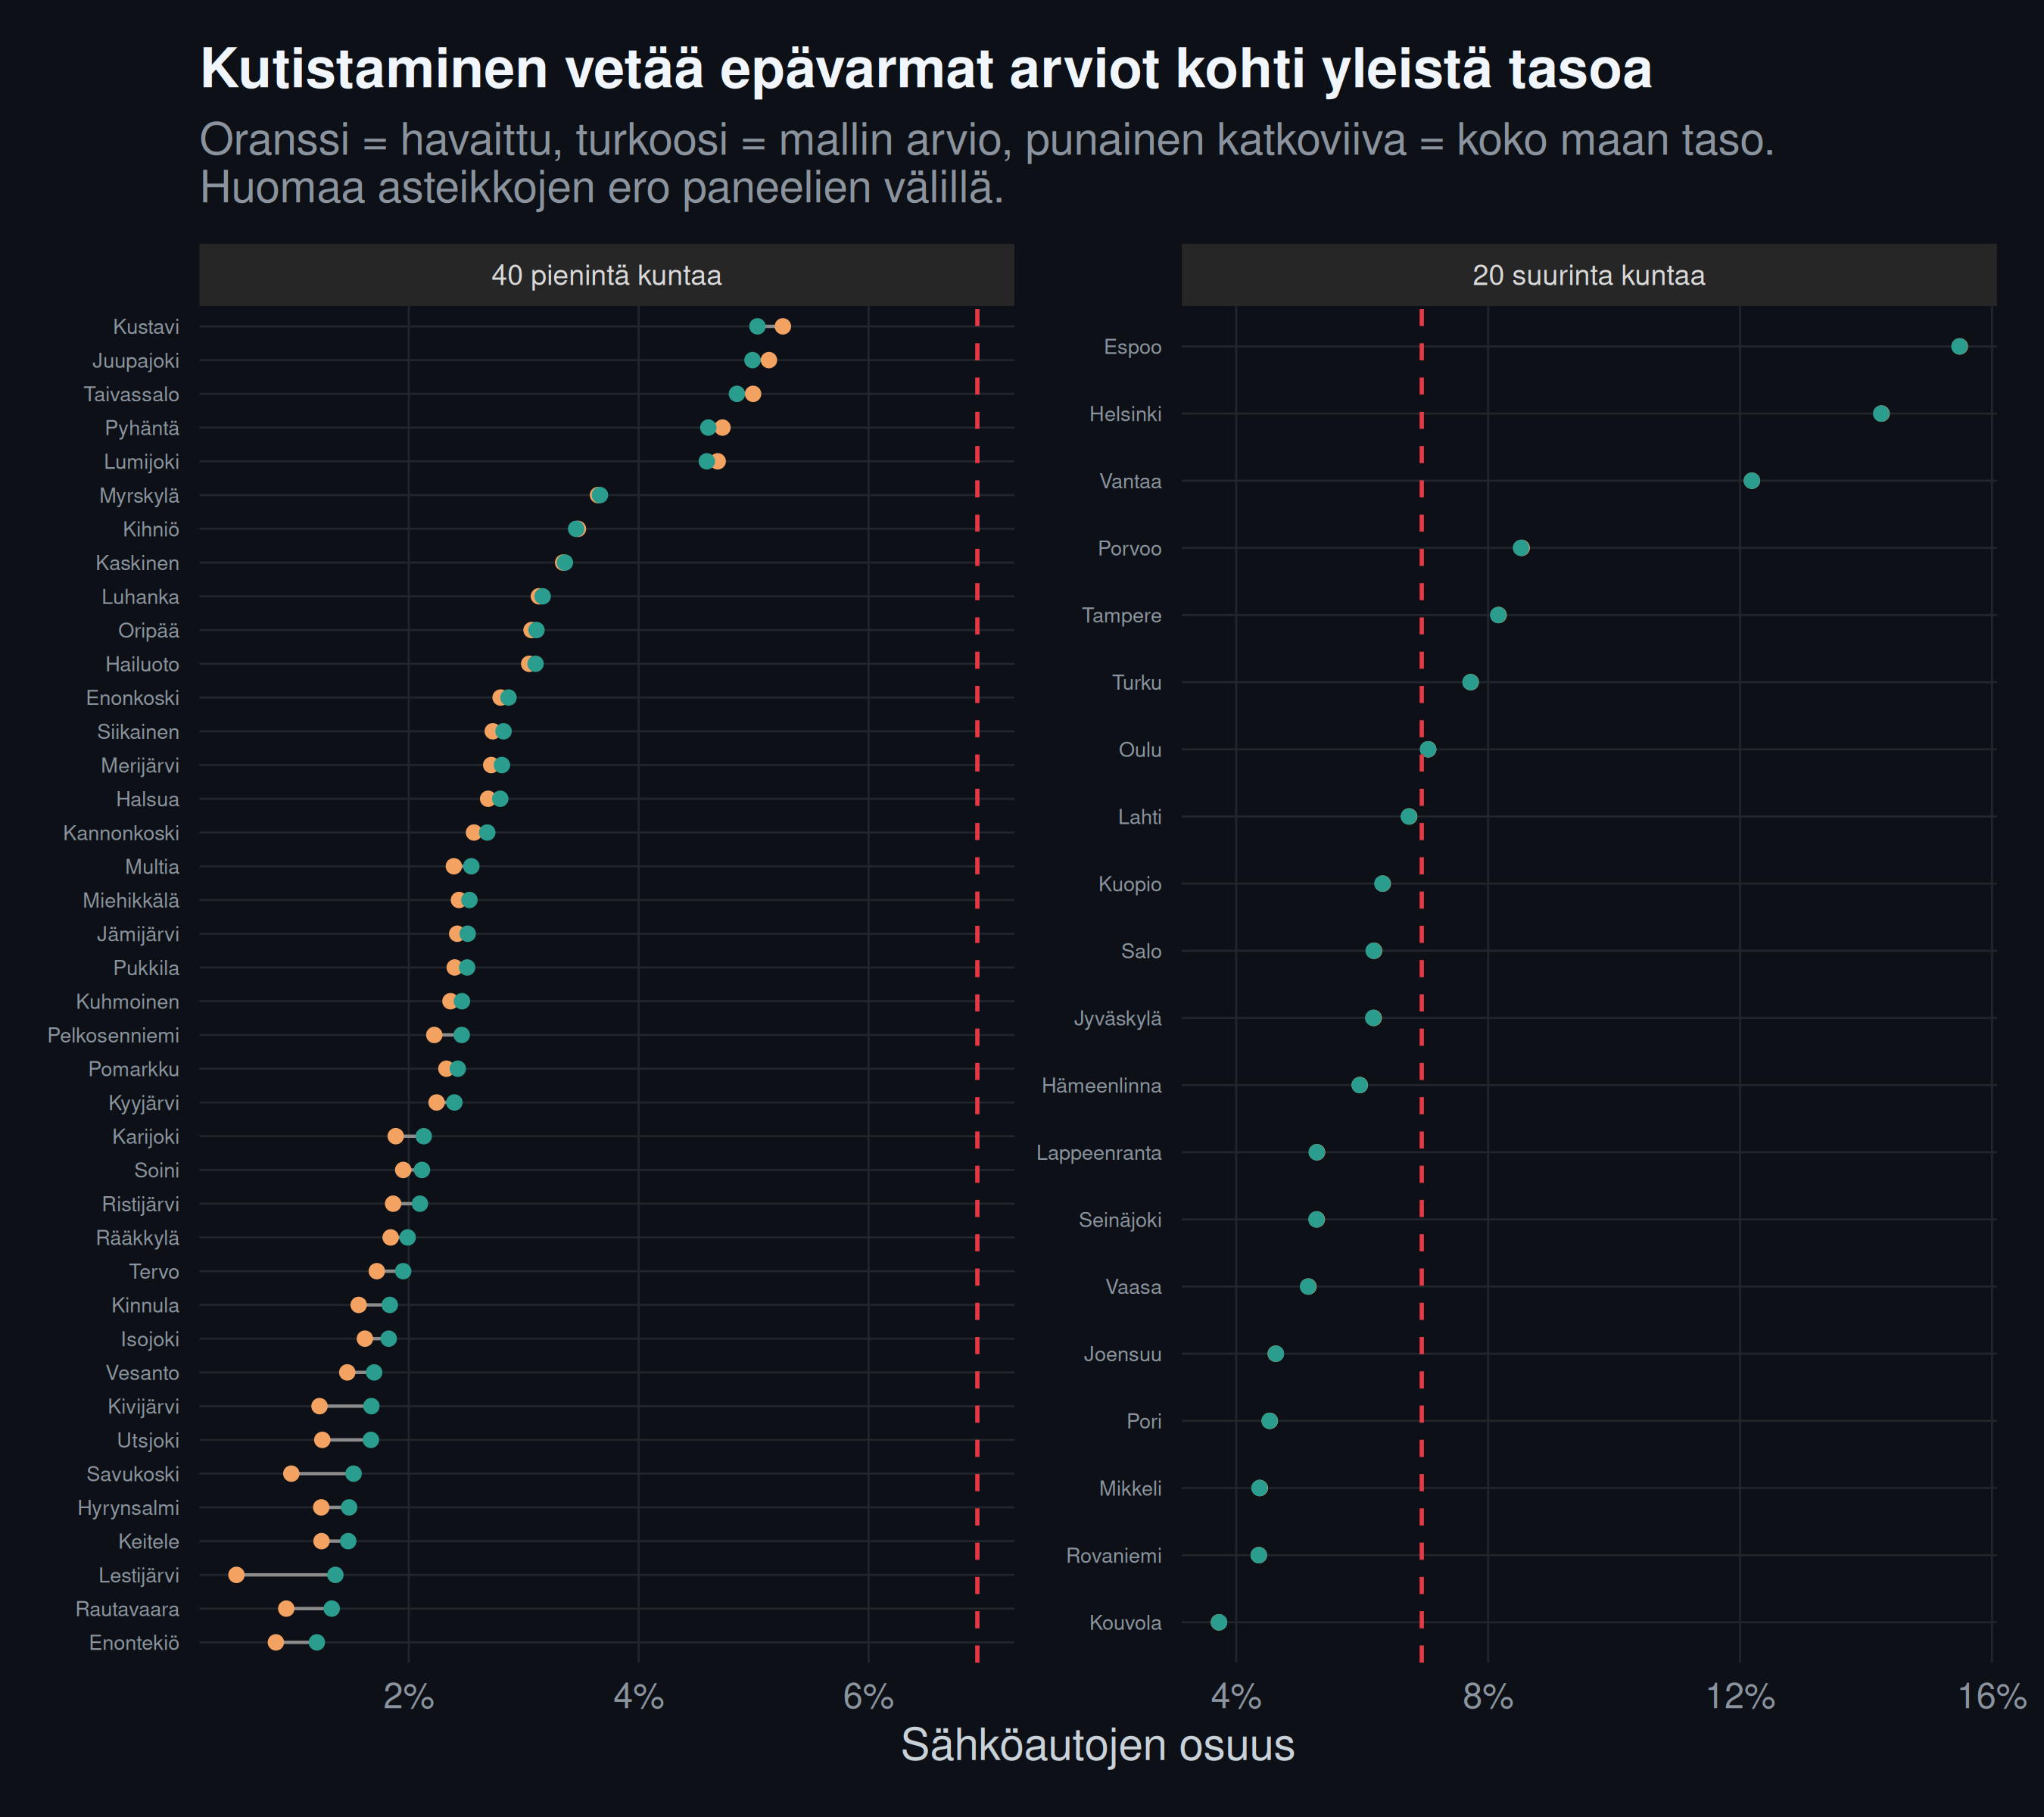
#| fig-cap: "Havaittu ja korjattu sähköistymisaste. Nuoli näyttää, kuinka paljon mallin arvio poikkeaa raa'asta havainnosta. Paneeleilla on eri asteikot, koska suurten kuntien osuudet ovat moninkertaisia."
#| fig-height: 8
shrinkage_data <- bind_rows(
ennusteet |> slice_min(kaikki, n = 40) |> mutate(ryhma = "40 pienintä kuntaa"),
ennusteet |> slice_max(kaikki, n = 20) |> mutate(ryhma = "20 suurinta kuntaa")
) |>
mutate(
ryhma = factor(ryhma, levels = c("40 pienintä kuntaa", "20 suurinta kuntaa")),
kunta = fct_reorder(kunta, arvio)
)
ggplot(shrinkage_data, aes(y = kunta)) +
geom_segment(aes(x = osuus_sahko, xend = arvio, yend = kunta),
colour = "grey55", linewidth = 0.5,
arrow = arrow(length = unit(0.07, "cm"), type = "closed")) +
geom_point(aes(x = osuus_sahko), colour = pal["oranssi"], size = 1.6) +
geom_point(aes(x = arvio), colour = pal["turkoosi"], size = 1.6) +
geom_vline(xintercept = koko_maa, colour = pal["punainen"], linetype = 2) +
facet_wrap(~ryhma, scales = "free", ncol = 2) +
scale_x_continuous(labels = percent) +
labs(x = "Sähköautojen osuus", y = NULL,
title = "Kutistaminen vetää epävarmat arviot kohti yleistä tasoa",
subtitle = paste("Oranssi = havaittu, turkoosi = mallin arvio,",
"punainen katkoviiva = koko maan taso.",
"\nHuomaa asteikkojen ero paneelien välillä.")) +
theme(axis.text.y = element_text(size = 6.5))
```
**Miten kuvaa luetaan.** Jokainen rivi on kunta, ja rivillä on kaksi pistettä.
Oranssi on suoraan aineistosta laskettu osuus. Turkoosi on mallin korjattu
arvio. Harmaa nuoli näyttää siirtymän suunnan ja pituuden.
Paneelien x-asteikot ovat eri, koska suurten kuntien osuudet ovat
moninkertaisia pieniin verrattuna. Yhteisellä asteikolla pienten kuntien
siirtymät puristuisivat näkymättömiin — mikä olisi juuri väärin päin, sillä ne
ovat kuvan tarkoitus.
Oikeanpuoleisessa paneelissa pisteet ovat useimmiten päällekkäin. Se ei ole
virhe vaan tulos: **suurissa kunnissa korjausta ei tarvita**, koska havaintoja
on niin paljon. Vasemmalla nuolet ovat pitkiä ja osoittavat kohti punaista
katkoviivaa.
Korjaus ei ole mielivaltainen. Sen suuruus määräytyy kahdesta asiasta: kuinka
paljon aineistoa kunnasta on ja kuinka paljon kunnat oikeasti eroavat
toisistaan. Molemmat estimoidaan aineistosta, ei valita käsin.
```{r}
#| label: kuva-kutistuma
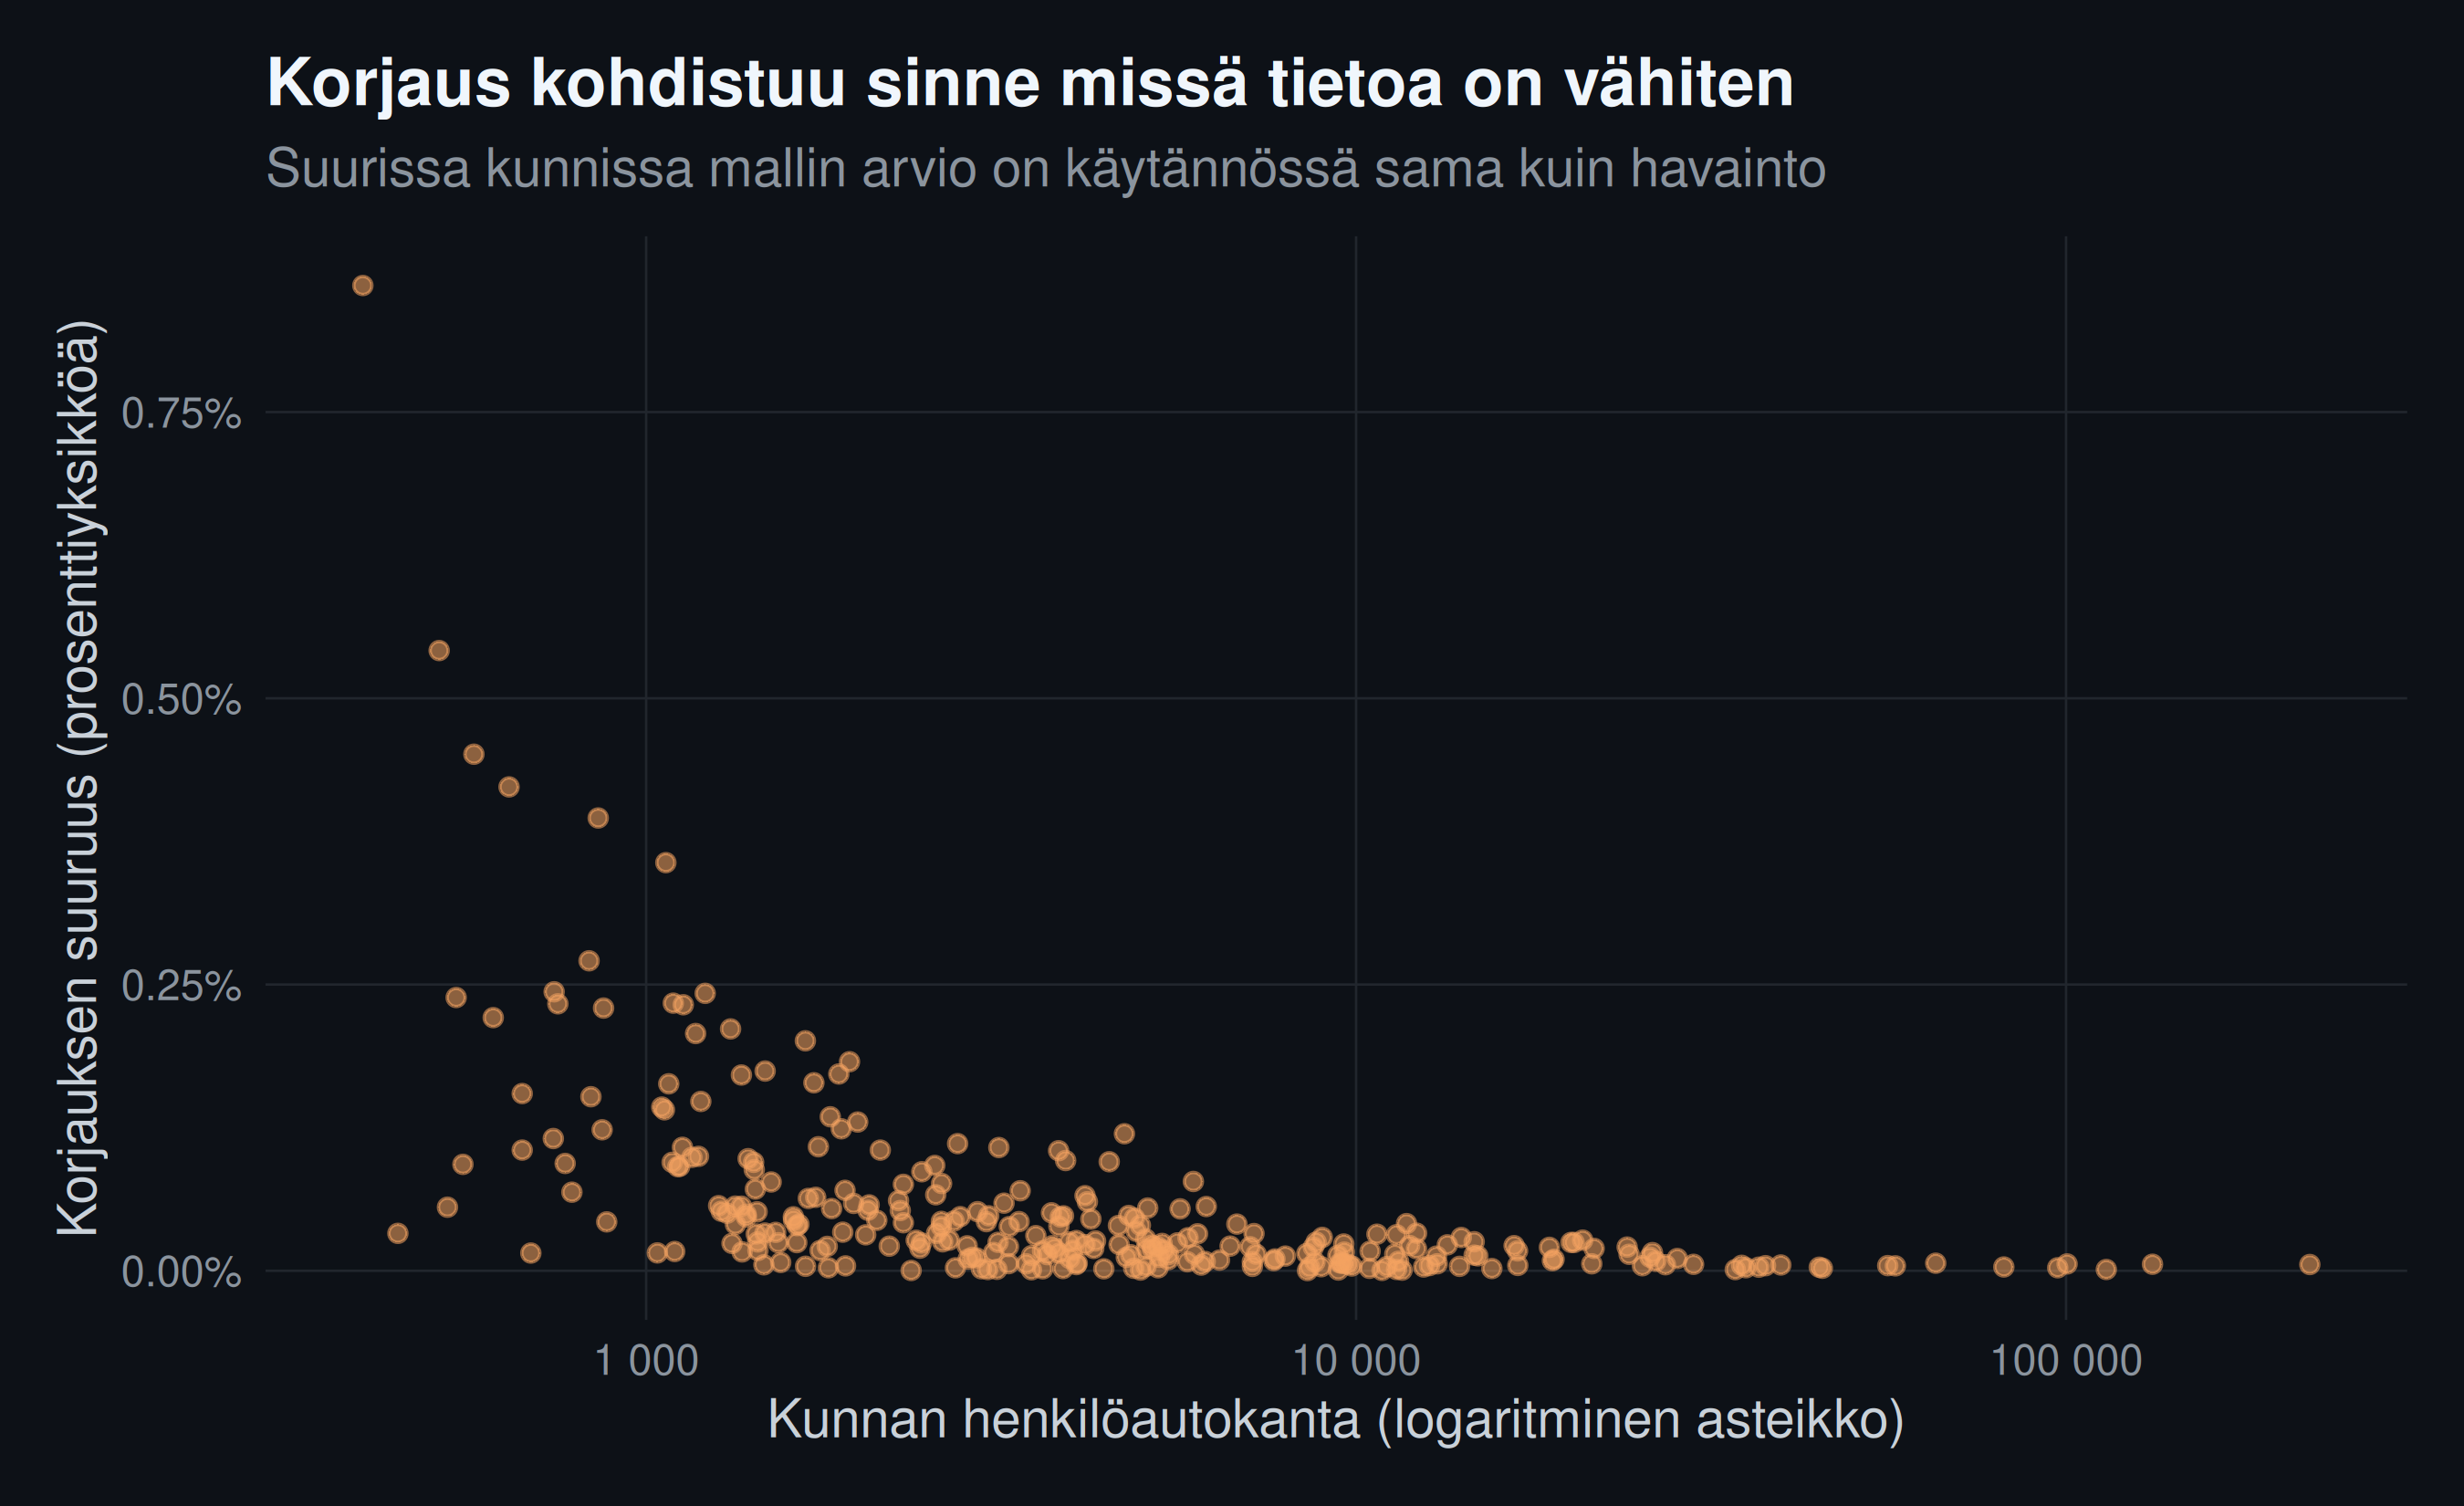
#| fig-cap: "Korjauksen suuruus kunnan koon mukaan."
ennusteet |>
ggplot(aes(kaikki, abs(kutistuma))) +
geom_point(colour = pal["oranssi"], alpha = 0.55, size = 1.8) +
scale_x_log10(labels = label_number(big.mark = " ")) +
scale_y_continuous(labels = percent) +
labs(x = "Kunnan henkilöautokanta (logaritminen asteikko)",
y = "Korjauksen suuruus (prosenttiyksikköä)",
title = "Korjaus kohdistuu sinne missä tietoa on vähiten",
subtitle = "Suurissa kunnissa mallin arvio on käytännössä sama kuin havainto")
```
Tämä kuva näyttää saman asian tiiviimmin. Vaaka-akselilla on kunnan koko,
pystyakselilla se, kuinka monta prosenttiyksikköä mallin arvio poikkeaa
havainnosta. Käyrä laskee jyrkästi: mitä enemmän kunnasta on havaintoja, sitä
vähemmän mallilla on korjattavaa.
Menetelmä ei siis "tasoita" aineistoa eikä piilota eroja. Se puuttuu vain
niihin lukuihin, joiden takana on liian vähän tietoa.
```{r}
#| label: karkilistat
#| echo: true
karki_raaka <- ennusteet |> slice_max(osuus_sahko, n = 10)
karki_korjattu <- ennusteet |> slice_max(arvio, n = 10)

paallekkaisyys <- length(intersect(karki_raaka$kunta, karki_korjattu$kunta))
mediaanikoko_raaka <- median(karki_raaka$kaikki)
mediaanikoko_korjattu <- median(karki_korjattu$kaikki)
```
Kahden kärkilistan vertailu kertoo ilmiön suuruuden konkreettisesti. Raa'an
osuuden mukaisen kymmenen kärjen mediaanikoko on
`r format(mediaanikoko_raaka, big.mark = " ")` autoa; korjatun listan
`r format(mediaanikoko_korjattu, big.mark = " ")`. Listoilla on yhteisiä kuntia
`r paallekkaisyys` kymmenestä.
Jos julkaisisin pelkän ensimmäisen listan, se olisi tilastollisesti
harhaanjohtava mutta näyttäisi täsmälliseltä. Tämä on tavallisimpia tapoja
tuottaa väärää tietoa oikeasta datasta.
```{r}
#| label: kuva-epavarmuus
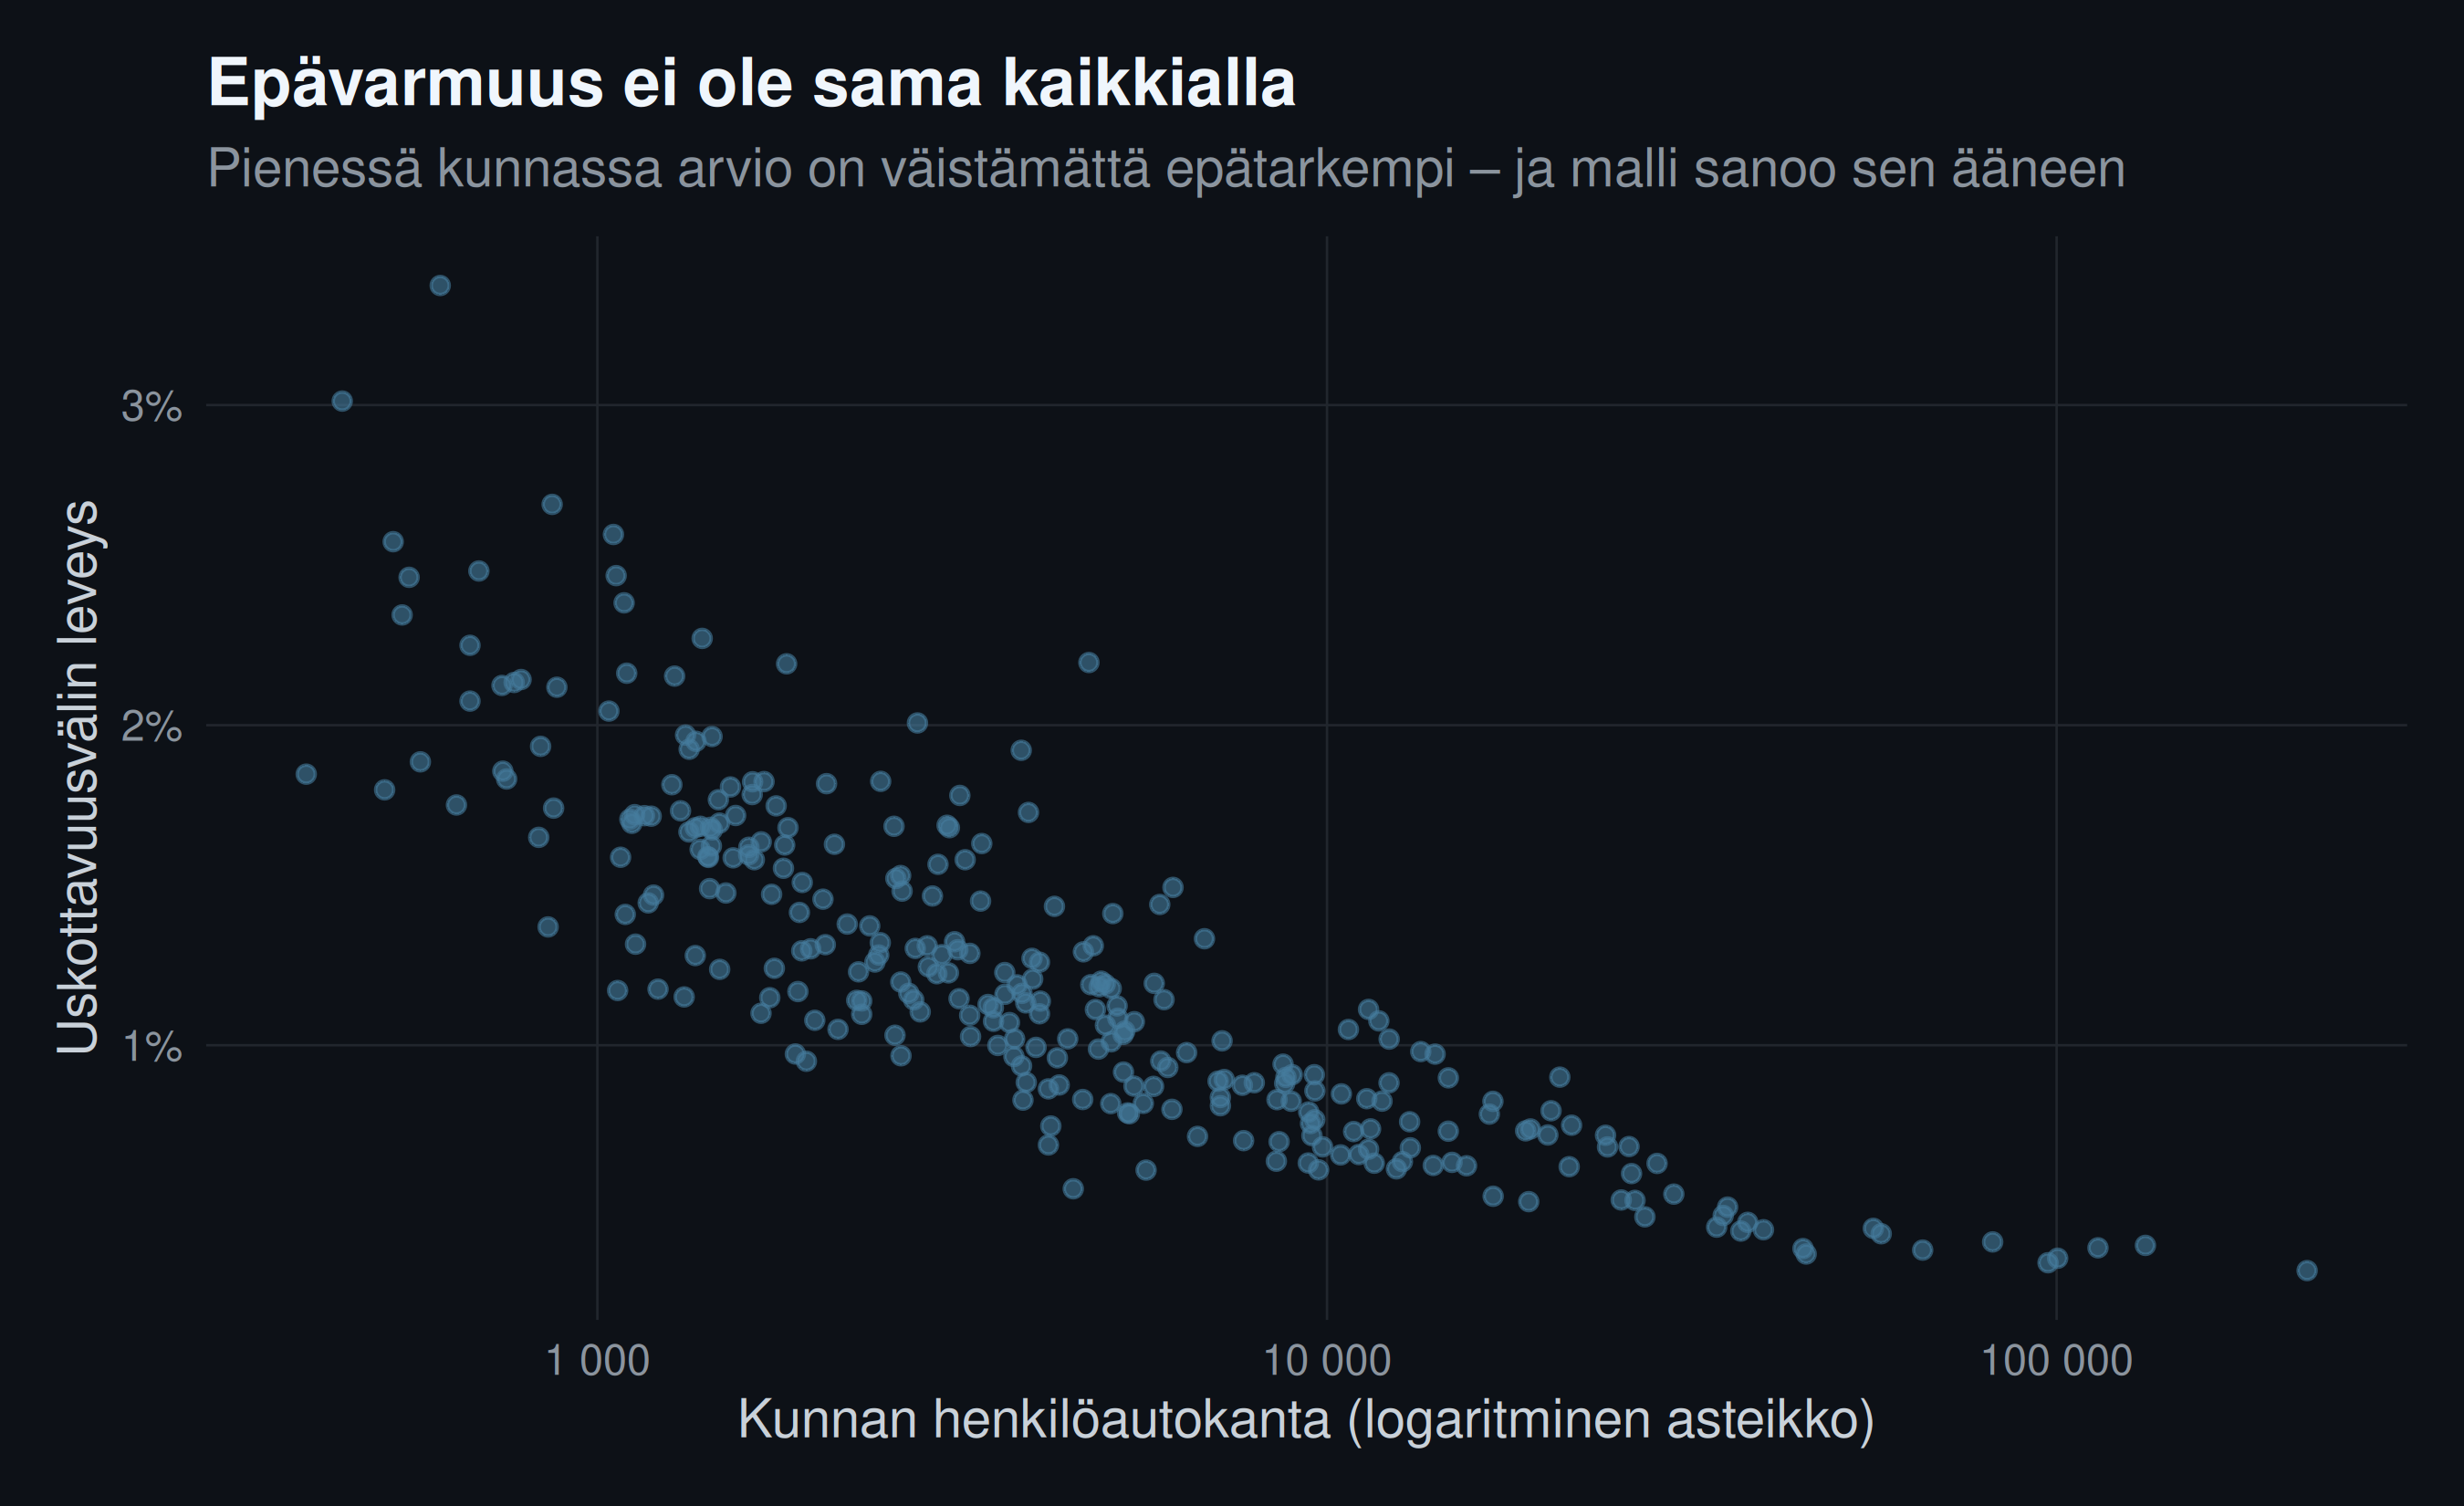
#| fig-cap: "Arvion epävarmuus kunnan koon mukaan."
ennusteet |>
ggplot(aes(kaikki, valin_leveys)) +
geom_point(colour = pal["sininen"], alpha = 0.6, size = 1.8) +
scale_x_log10(labels = label_number(big.mark = " ")) +
scale_y_continuous(labels = percent) +
labs(x = "Kunnan henkilöautokanta (logaritminen asteikko)",
y = "Uskottavuusvälin leveys",
title = "Epävarmuus ei ole sama kaikkialla",
subtitle = "Pienessä kunnassa arvio on väistämättä epätarkempi – ja malli sanoo sen ääneen")
```
Tämä kuva on syy siihen, miksi käytän bayesläistä mallia enkä pelkkää
kutistuskaavaa. Malli ei anna vain korjattua pistearviota vaan jokaiselle
kunnalle oman epävarmuusvälin. Kun arvio Helsingin sähköistymisasteesta on
tarkka ja arvio pienestä kunnasta epätarkka, se näkyy tuloksessa suoraan eikä
jää lukijan arvattavaksi.
## Puolet latauspaikan tarvitsijoista ei ole sähköautoja
Tähän asti olen puhunut täyssähköautoista. Ne eivät kuitenkaan ole ainoita
autoja, jotka kytketään latauspistokkeeseen.
```{r}
#| label: hybridit
#| echo: true
hybridit <- kunnat |>
  summarise(
    sahko = sum(sahko), phev = sum(phev),
    ladattavia = sahko + phev,
    phev_osuus = phev / ladattavia
  )

suhde_kunnittain <- kunnat |>
  filter(sahko >= 20) |>
  mutate(phev_per_sahko = phev / sahko)

suhde_tunnusluvut <- suhde_kunnittain |>
  summarise(
    mediaani = median(phev_per_sahko),
    q10 = quantile(phev_per_sahko, 0.1),
    q90 = quantile(phev_per_sahko, 0.9)
  )
```
Ladattavia hybridejä on Suomessa
`r format(hybridit$phev, big.mark = " ")` ja täyssähköautoja
`r format(hybridit$sahko, big.mark = " ")`. Ladattavista autoista siis
`r percent(hybridit$phev_osuus, accuracy = 1)` on hybridejä.
```{r}
#| label: kuva-hybridit
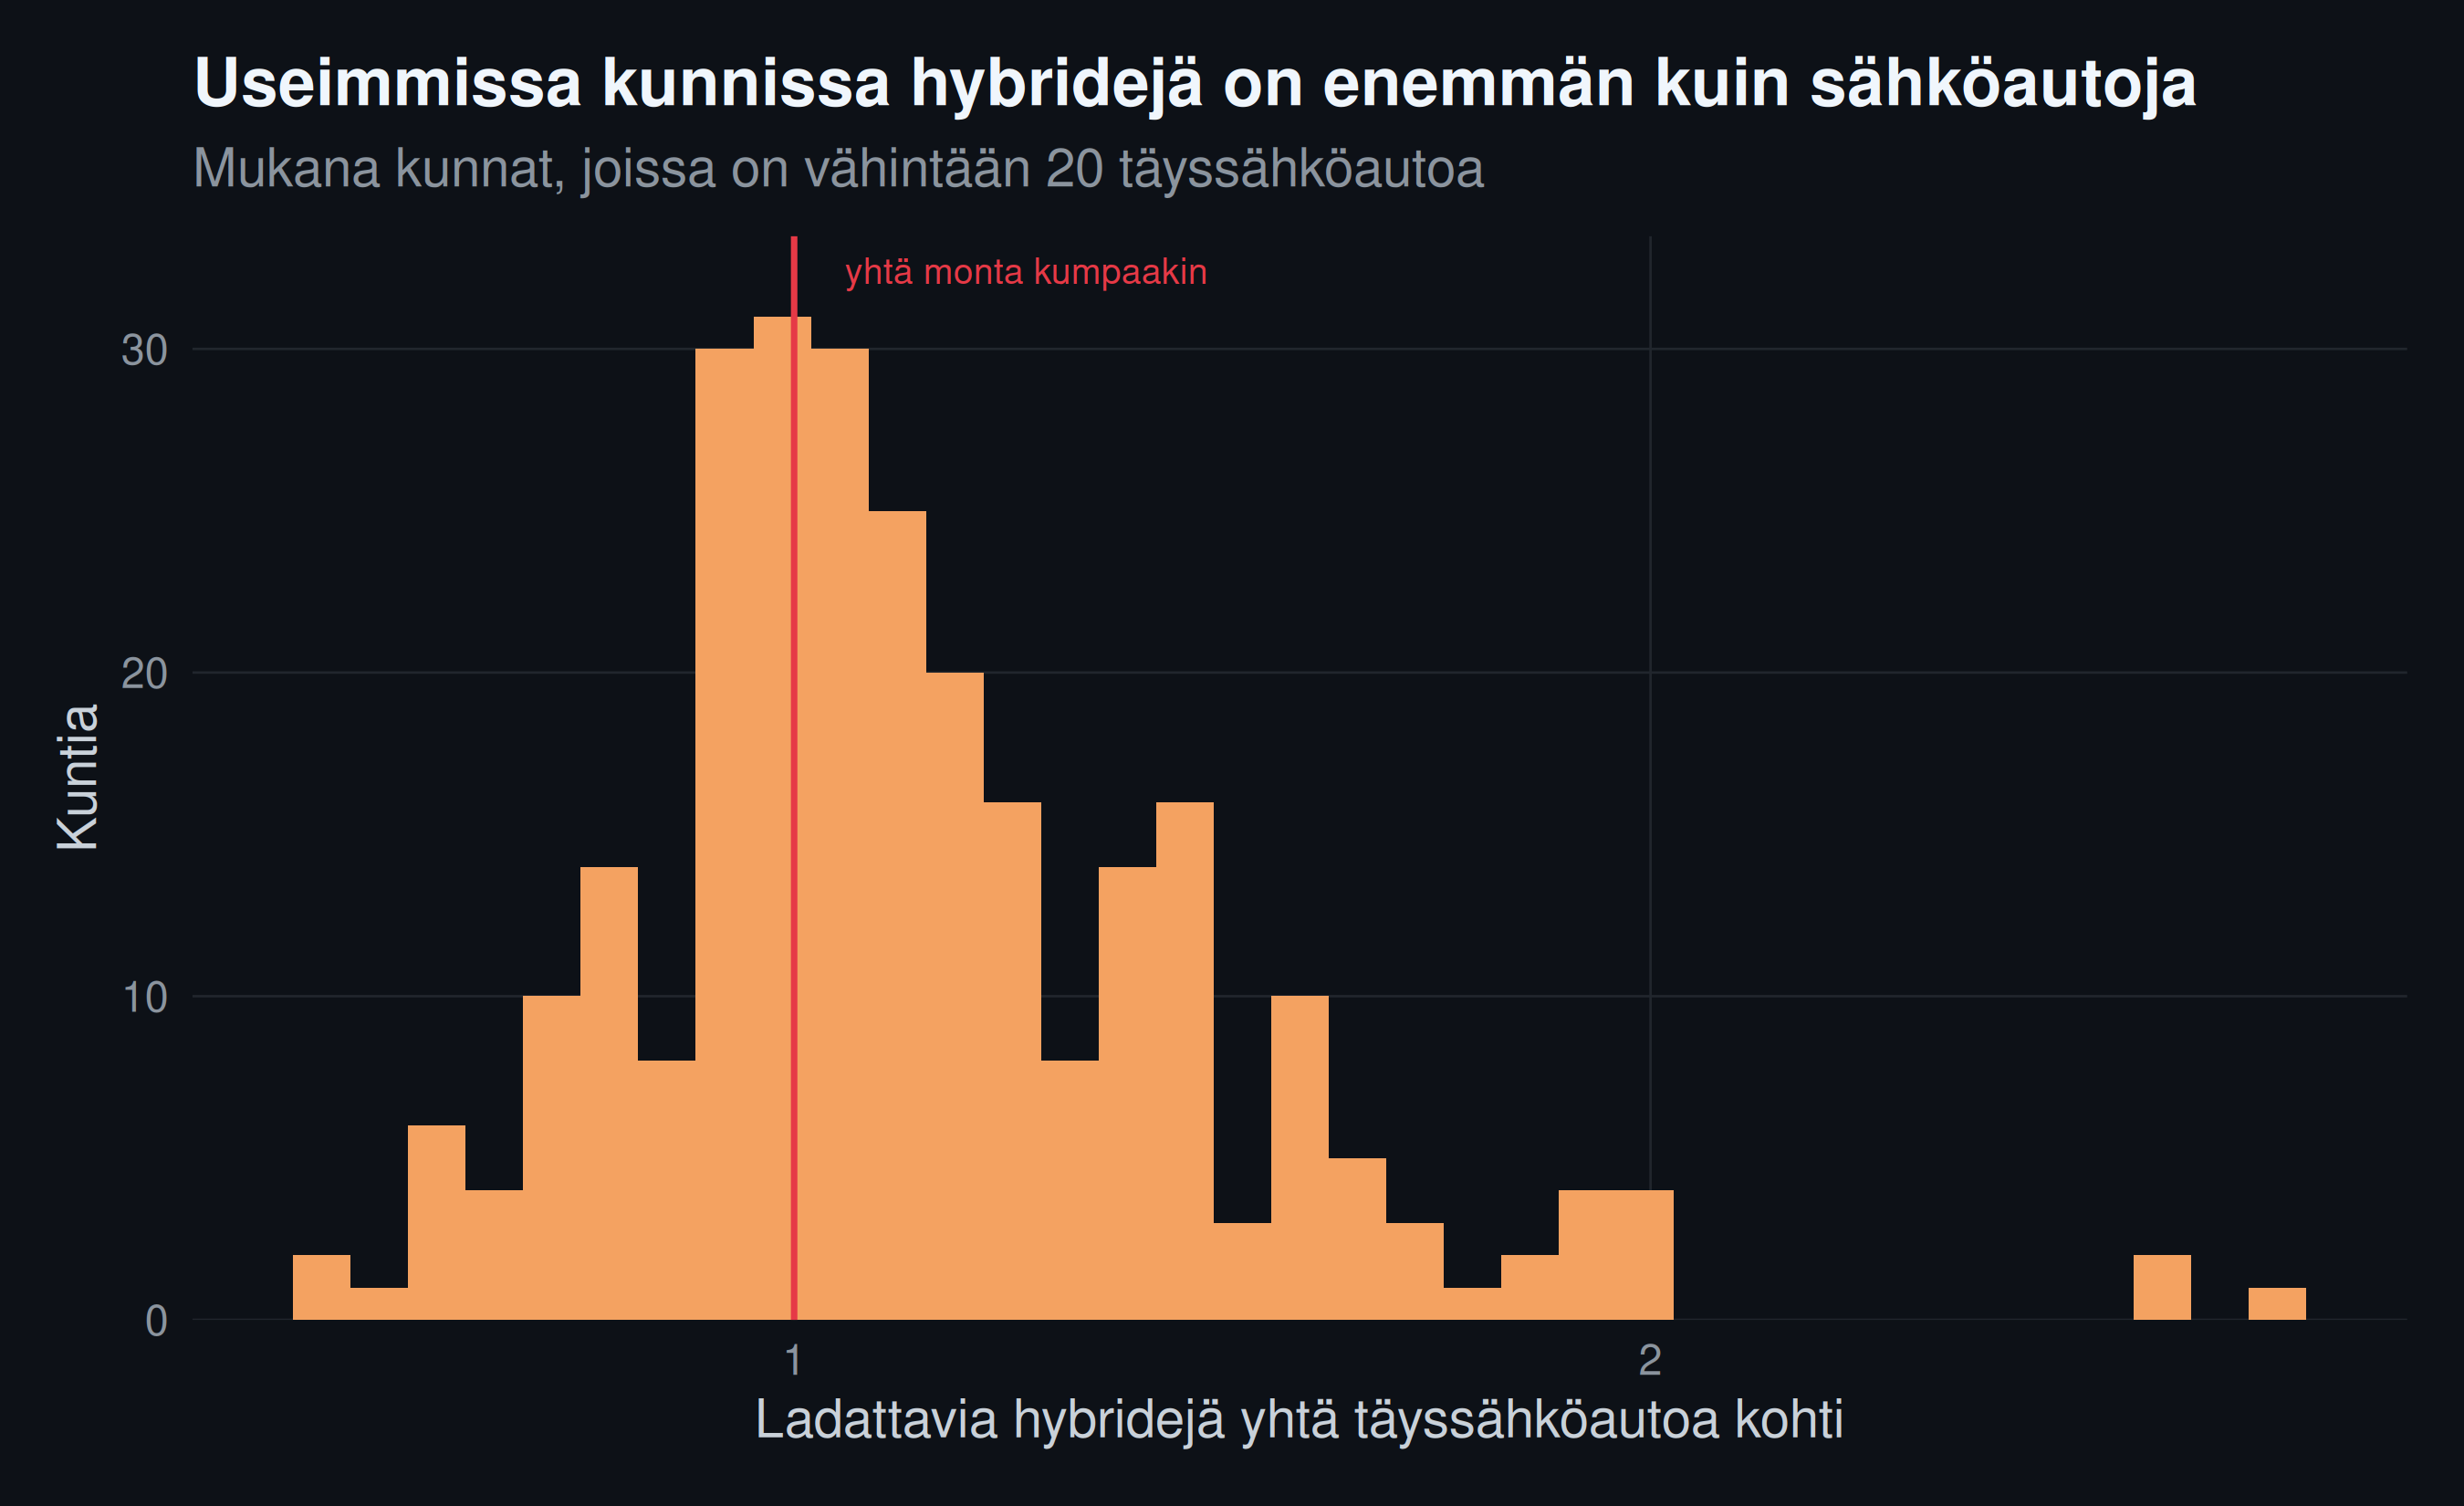
#| fig-cap: "Ladattavien hybridien ja täyssähköautojen suhde kunnittain."
suhde_kunnittain |>
ggplot(aes(phev_per_sahko)) +
geom_histogram(bins = 35, fill = pal["oranssi"], colour = NA) +
geom_vline(xintercept = 1, colour = pal["punainen"], linewidth = 0.8) +
annotate("text", x = 1, y = Inf, hjust = -0.08, vjust = 1.8,
label = " yhtä monta kumpaakin",
colour = pal["punainen"], size = 3.3) +
scale_y_continuous(expand = expansion(mult = c(0, 0.08))) +
labs(x = "Ladattavia hybridejä yhtä täyssähköautoa kohti", y = "Kuntia",
title = "Useimmissa kunnissa hybridejä on enemmän kuin sähköautoja",
subtitle = "Mukana kunnat, joissa on vähintään 20 täyssähköautoa")
```
**Miten kuvaa luetaan.** Vaaka-akselilla on luku, joka kertoo montako ladattavaa
hybridiä kunnassa on jokaista täyssähköautoa kohti. Arvo 1 tarkoittaa, että
niitä on yhtä monta. Arvo 2 tarkoittaa, että hybridejä on kaksinkertainen määrä.
Pystyakselilta luetaan, montako kuntaa osuu kullekin välille.
Mediaanikunnassa hybridejä on
`r format(round(suhde_tunnusluvut$mediaani, 2), decimal.mark = ",")` jokaista
täyssähköautoa kohti.
**Miksi tällä on väliä latausverkolle.** Ladattava hybridi ei kuormita verkkoa
samalla tavalla kuin täyssähköauto. Sen akku on pieni, tyypillisesti alle
viidennes täyssähköauton akusta, eikä se yleensä osaa pikalatausta lainkaan.
Hybridi siis kilpailee samoista hitaista vaihtovirtapistokkeista kaupungissa
mutta ei juuri koskaan pikalatureista valtatien varressa.
Tämä tarkoittaa, että **latausverkon kuormitus jakautuu eri tavalla kuin
autokanta.** Kaupungin AC-pistokkeiden kysyntää arvioitaessa hybridit on
laskettava mukaan; pikalatausverkon mitoituksessa ne voi jättää lähes kokonaan
pois. Yksi luku "ladattavia autoja per pistoke" sekoittaa nämä kaksi eri
kysymystä yhdeksi harhaanjohtavaksi suhdeluvuksi.
Käytän jatkossa täyssähköautoja, koska tämän sarjan kysymys on verkoston
toimivuus pitkillä matkoilla. Se on valinta, ja se pitää sanoa ääneen — toiseen
kysymykseen vastattaisiin toisella luvulla.
## Latauspistokkeet suhteessa autokantaan
Nyt voidaan yhdistää kaksi aineistoa: kuinka monta latauspistoketta kunnassa on
suhteessa siellä oleviin sähköautoihin.
```{r}
#| label: yhdista
#| echo: true
# Latausaineiston kuntakenttä on vapaata tekstiä ja sisältää kaupunginosia
# ("Vierumäki", "Nummela"), ruotsinkielisiä nimiä ("Jakobstad"), aksentittomia
# muotoja ("Jyvaskyla") ja tyhjää ("-", "N/A"). Nimipohjainen liitos ei siis
# toimi. Asemat sijoitetaan kuntiin koordinaattien perusteella.
lau_path <- file.path(data_dir, "kunnat_lau.qs")

if (!file.exists(lau_path)) {
  kunnat_sf <- giscoR::gisco_get_lau(country = "Finland", year = "2021") |>
    st_transform(3067) |>
    select(kunta_geo = LAU_NAME)
  qs2::qs_save(kunnat_sf, lau_path)
} else {
  kunnat_sf <- qs2::qs_read(lau_path)
}

# Koordinaattijärjestelmä tallentuu sf-objektiin WKT-merkkijonona, jonka
# asennettu PROJ-kirjasto muodostaa. Eri ympäristöissä sama EPSG-koodi
# tuottaa hieman eri merkkijonon, ja sf vertaa merkkijonoja. Siksi CRS
# asetetaan uudelleen lukemisen jälkeen: silloin molemmat objektit saavat
# saman ajoympäristön oman esityksen.
st_crs(kunnat_sf) <- 3067

stopifnot(
  "Kuntageometria on tyhjä" = nrow(kunnat_sf) > 0,
  "Kuntia on odottamaton määrä" = between(nrow(kunnat_sf), 290, 320)
)

asemat_sf <- asemat |>
  filter(!is.na(lat), !is.na(lon)) |>
  st_as_sf(coords = c("lon", "lat"), crs = 4326) |>
  st_transform(3067)

stopifnot(
  "Koordinaattijärjestelmät eivät täsmää" =
    st_crs(asemat_sf) == st_crs(kunnat_sf)
)

asema_kunta <- st_join(asemat_sf, kunnat_sf, join = st_within) |>
  st_drop_geometry() |>
  select(avain, kunta_geo)

osuus_kunnaton <- mean(is.na(asema_kunta$kunta_geo))

stopifnot(
  "Yli 3 % asemista jäi kuntarajojen ulkopuolelle" = osuus_kunnaton < 0.03
)

pistokkeet_kunnittain <- liitokset |>
  left_join(asema_kunta, by = "avain") |>
  filter(!is.na(kunta_geo)) |>
  group_by(kunta = kunta_geo) |>
  summarise(
    pistokkeita = n(),
    kw = sum(teho_kw, na.rm = TRUE),
    hpc = sum(teho_kw >= 150, na.rm = TRUE),
    .groups = "drop"
  )

# Kuntageometria kuvaa vuoden 2021 tilannetta, autokanta vuotta 2026.
# Välissä on tapahtunut kuntaliitoksia, joten osa geometrian kunnista ei
# ole enää olemassa. Ne siirretään nykyiseen kuntaansa. Ilman tätä niiden
# latauspisteet katoaisivat aineistosta hiljaisesti.
kuntaliitokset <- tibble::tribble(
  ~vanha,       ~uusi,
  "Honkajoki",  "Kankaanpää",    # liitos 1.1.2021
  "Pertunmaa",  "Mäntyharju"     # liitos 1.1.2025
)

# Ahvenanmaan kunnat puuttuvat autokannasta erillisrekisterin vuoksi.
# Ne poistetaan, jottei synny kuntia joissa on latureita mutta ei autoja.
ahvenanmaa <- c("Maarianhamina - Mariehamn", "Jomala", "Finström",
                "Eckerö", "Kökar", "Lemland", "Saltvik", "Sund",
                "Hammarland", "Geta", "Föglö", "Vårdö", "Brändö",
                "Kumlinge", "Sottunga", "Lumparland")

pistokkeet_kunnittain <- pistokkeet_kunnittain |>
  left_join(kuntaliitokset, by = c("kunta" = "vanha")) |>
  mutate(kunta = coalesce(uusi, kunta)) |>
  select(-uusi) |>
  group_by(kunta) |>
  summarise(across(c(pistokkeita, kw, hpc), sum), .groups = "drop")

pistokkeet_ahvenanmaa <- pistokkeet_kunnittain |>
  filter(kunta %in% ahvenanmaa) |>
  summarise(n = sum(pistokkeita)) |> pull(n)

pistokkeet_kunnittain <- pistokkeet_kunnittain |>
  filter(!kunta %in% ahvenanmaa)

# Kaikki jäljelle jäävät kunnat pitää löytyä autokannasta. Jos ei löydy,
# kyseessä on kuntaliitos jota ei ole kirjattu yllä olevaan taulukkoon.
tuntemattomat <- setdiff(pistokkeet_kunnittain$kunta, kunnat$kunta)

stopifnot(
  "Tuntemattomia kuntia – tarkista kuntaliitostaulukko" =
    length(tuntemattomat) == 0
)

yhdistetty <- ennusteet |>
  left_join(pistokkeet_kunnittain, by = "kunta") |>
  replace_na(list(pistokkeita = 0, kw = 0, hpc = 0)) |>
  mutate(
    sahkoautoja = sahko,
    autoja_per_pistoke = if_else(pistokkeita > 0,
                                 sahkoautoja / pistokkeita, NA_real_),
    ilman_pistoketta = pistokkeita == 0
  )

stopifnot(
  "Yhdistetty aineisto puuttuu kuntia" = nrow(yhdistetty) == nrow(ennusteet),
  "Pistokkeita katosi liitoksessa" =
    sum(yhdistetty$pistokkeita) == sum(pistokkeet_kunnittain$pistokkeita)
)

kuntia_ilman <- sum(yhdistetty$ilman_pistoketta)
autoja_ilman_kunnissa <- sum(yhdistetty$sahkoautoja[yhdistetty$ilman_pistoketta])
```
### Miksi kuntaa ei voi lukea kuntakentästä
Latausasemien rekisterissä on kenttä nimeltä *city*. Sen pitäisi kertoa, missä
kunnassa asema on. Se ei kerro.
Kentässä on kaupunginosia ja taajamia — Vierumäki, Nummela, Iittala, Kausala,
Nikkilä — jotka eivät ole kuntia. Siellä on ruotsinkielisiä nimiä kuten
Jakobstad, vaikka autokannan tilastossa sama kunta on Pietarsaari. Siellä on
aksentittomia muotoja kuten Jamsa ja Jyvaskyla. Ja siellä on merkintöjä "-" ja
"N/A", jotka tarkoittavat että kenttä on jätetty täyttämättä.
Tämä ei ole kenenkään virhe. Operaattori täyttää kenttään postiosoitteen
mukaisen paikannimen, ja postiosoitteessa lukee Vierumäki eikä Heinola.
Ratkaisu ei ole korjata nimiä käsin. Se olisi loputon urakka ja tuottaisi
virheitä. Ratkaisu on käyttää tietoa, joka rekisterissä on luotettavaa:
koordinaatteja. Kun asema sijoitetaan kuntarajojen sisään sen sijainnin
perusteella, kuntakenttää ei tarvita lainkaan.
Näin liitettynä `r percent(1 - osuus_kunnaton, accuracy = 0.1)` asemista löytää
kuntansa. Loput ovat todennäköisesti aivan rannikolla tai rajalla, missä
karkeapiirteinen kuntageometria ja aseman koordinaatti eivät osu yhteen.
::: {.callout-warning}
## Kaksi rajausta, jotka koordinaattiliitos paljasti
**Kuntajako muuttuu.** Käyttämäni kuntageometria kuvaa vuoden 2021 tilannetta,
autokanta vuotta 2026. Välissä on tapahtunut kuntaliitoksia: Pertunmaa yhdistyi
Mäntyharjuun vuoden 2025 alussa ja Honkajoki Kankaanpäähän 2021.
Geometriassa nämä ovat yhä olemassa, autokannassa eivät. Jos asiaa ei
huomaisi, niiden latauspisteet katoaisivat aineistosta hiljaisesti — ja
Pertunmaan tapauksessa se tarkoittaisi 24 pistoketta, joista 18 on
suurtehulatureita. Kyse on Kuortin kylän latausasemasta valtatie 5:n varrella,
eli juuri sellaisesta pikalatauspisteestä, joka on verkoston kannalta
merkittävä.
Siirrän nämä nykyisiin kuntiinsa eksplisiittisellä taulukolla. Se on
työläämpää kuin uudemman geometrian etsiminen, mutta läpinäkyvämpää:
taulukosta näkee mitä on tehty ja miksi.
**Ahvenanmaa.** Maakunnassa on `r pistokkeet_ahvenanmaa` latauspistoketta,
mutta se puuttuu autokannan tilastosta kokonaan erillisrekisterin vuoksi. Jos
näitä ei poistettaisi, aineistoon syntyisi kuntia, joissa on latureita mutta
ei yhtään sähköautoa — ja ne näyttäisivät tilastossa erinomaisesti
varustelluilta. Ahvenanmaan latausverkkoa ei siis käsitellä tässä sarjassa, ja
syy on aineiston rajaus eikä valinta.
:::
Kuntia, joissa ei ole yhtään rekisteröityä julkista latauspistoketta, on
**`r kuntia_ilman`**. Niissä on yhteensä
`r format(autoja_ilman_kunnissa, big.mark = " ")` täyssähköautoa.
Luku vaatii heti kaksi varausta. Aineisto kattaa vain kansalliseen rekisteriin
ilmoitetut julkiset latauspisteet — kotilatauslaitteet eivät ole mukana,
eivätkä taloyhtiöiden omat laturit. Ja kunnan raja ei ole latausverkon kannalta
merkityksellinen: naapurikunnan laturi voi olla lähempänä kuin oman kunnan
keskusta.
Kuntataso onkin tässä väliaikainen ratkaisu, joka riittää kokonaiskuvaan mutta
ei yksittäisen autoilijan tilanteen arviointiin. Tarkempi tarkastelu vaatii
todelliset ajoetäisyydet tieverkkoa pitkin.
```{r}
#| label: kuva-suhde
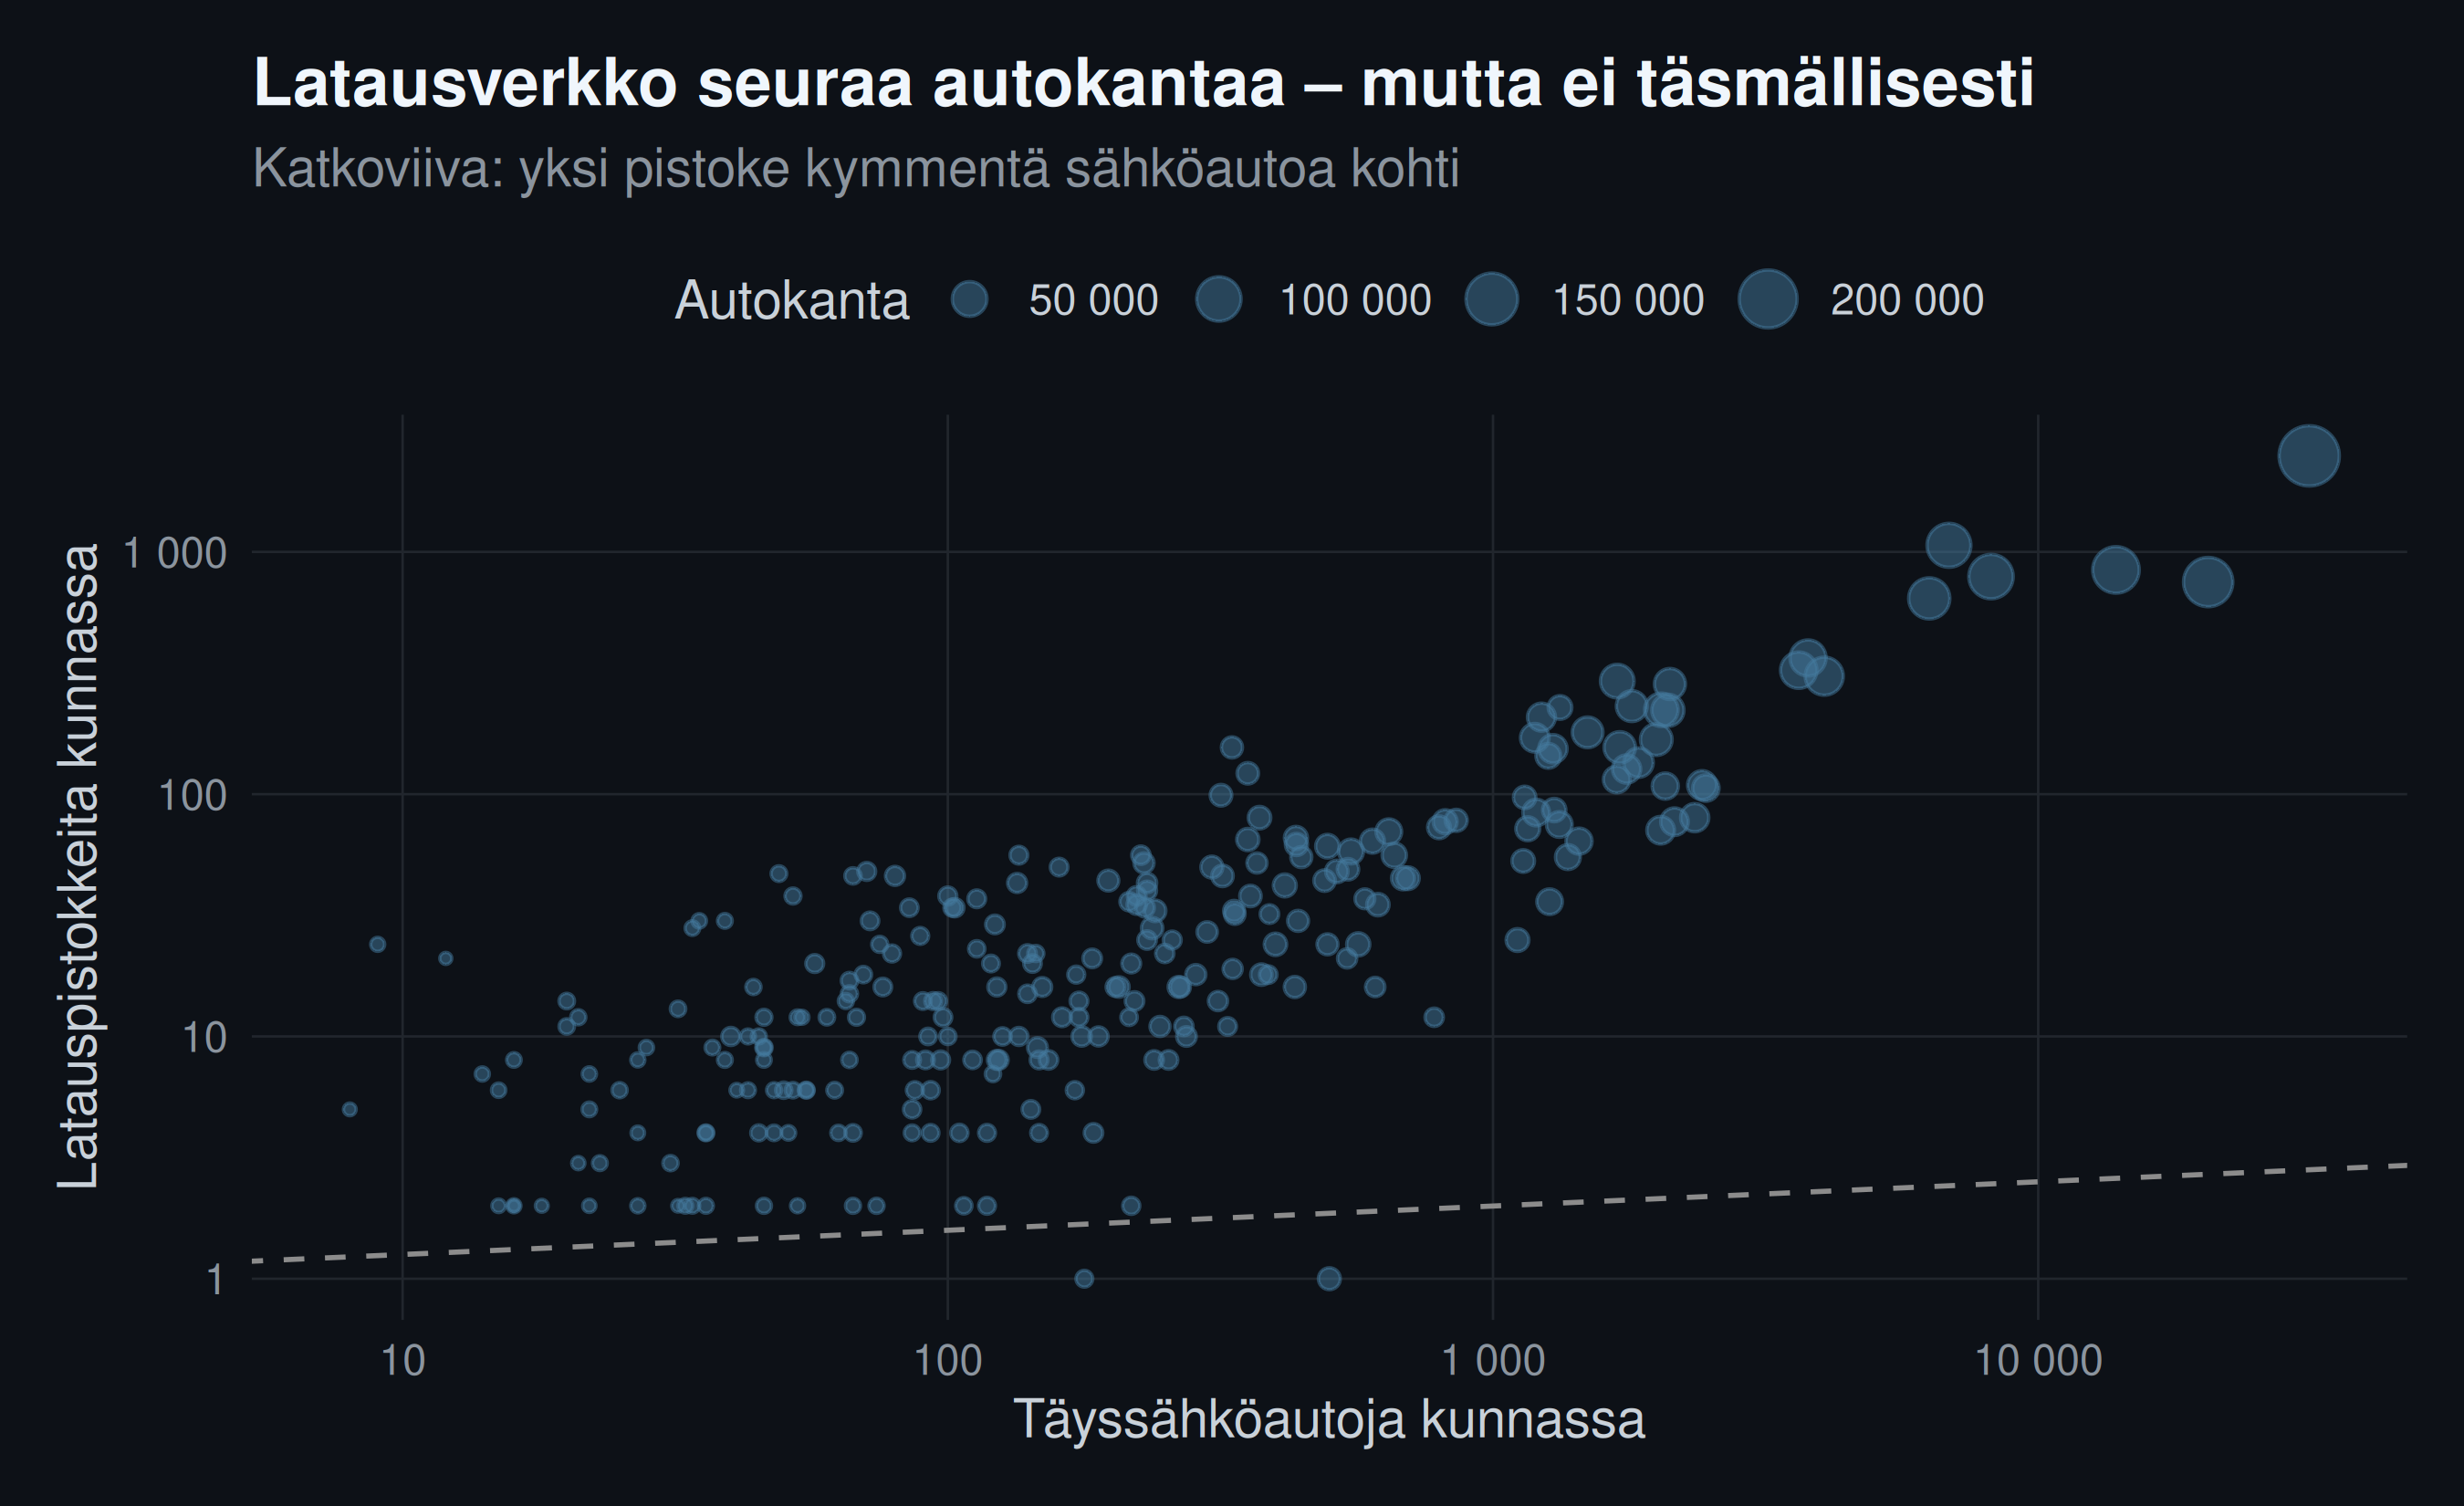
#| fig-cap: "Latauspistokkeet ja sähköautot kunnittain."
yhdistetty |>
filter(pistokkeita > 0, sahkoautoja > 0) |>
ggplot(aes(sahkoautoja, pistokkeita)) +
geom_abline(slope = 1/10, intercept = 0, colour = "grey55", linetype = 2) +
geom_point(aes(size = kaikki), colour = pal["sininen"], alpha = 0.5) +
scale_x_log10(labels = label_number(big.mark = " ")) +
scale_y_log10(labels = label_number(big.mark = " ")) +
scale_size_continuous(range = c(1, 7), labels = label_number(big.mark = " ")) +
labs(x = "Täyssähköautoja kunnassa", y = "Latauspistokkeita kunnassa",
size = "Autokanta",
title = "Latausverkko seuraa autokantaa – mutta ei täsmällisesti",
subtitle = "Katkoviiva: yksi pistoke kymmentä sähköautoa kohti")
```
**Miten kuvaa luetaan.** Molemmat akselit ovat logaritmisia, koska sekä autojen
että pistokkeiden määrät vaihtelevat yksittäisistä tuhansiin. Jokainen piste on
kunta, ja pisteen koko kertoo kunnan koko autokannan.
Katkoviiva kuvaa tilannetta, jossa kunnassa on yksi latauspistoke jokaista
kymmentä sähköautoa kohti. Viiva ei ole tavoite eikä normi — se on lukemisen
apuväline, joka tekee poikkeamat näkyviksi. Viivan yläpuolella pistokkeita on
suhteessa enemmän, alapuolella vähemmän.
### Tilastollinen testi: onko kuntakoolla väliä?
```{r}
#| label: testi
#| echo: true
testidata <- yhdistetty |>
  filter(sahkoautoja >= 10, pistokkeita > 0) |>
  mutate(kokoluokka = cut(kaikki,
                          breaks = quantile(kaikki, c(0, 1/3, 2/3, 1)),
                          labels = c("Pieni", "Keskikokoinen", "Suuri"),
                          include.lowest = TRUE))

stopifnot(
  "Kokoluokkia ei muodostunut kolmea" = n_distinct(testidata$kokoluokka) == 3,
  "Liian vähän kuntia testiin" = nrow(testidata) >= 30
)

# Vertailtava suure on vino ja alhaalta nollaan rajattu, joten
# normaalijakaumaan nojaavat testit eivät sovi.
kw_testi <- kruskal.test(autoja_per_pistoke ~ kokoluokka, data = testidata)

n_tot <- nrow(testidata)
epsilon2 <- unname(kw_testi$statistic) / ((n_tot^2 - 1) / (n_tot + 1))

parivertailu <- testidata |>
  filter(kokoluokka %in% c("Pieni", "Suuri")) |> droplevels()
wt <- wilcox.test(autoja_per_pistoke ~ kokoluokka, data = parivertailu,
                  conf.int = TRUE, exact = FALSE)
n1 <- sum(parivertailu$kokoluokka == "Pieni")
n2 <- sum(parivertailu$kokoluokka == "Suuri")
rank_biserial <- 1 - (2 * unname(wt$statistic)) / (n1 * n2)

mediaanit <- testidata |>
  group_by(kokoluokka) |>
  summarise(mediaani = median(autoja_per_pistoke), n = n(), .groups = "drop")
```
Kruskal–Wallis-testi antaa p-arvoksi
`r if (kw_testi$p.value < 0.001) "alle 0,001" else format(round(kw_testi$p.value, 4), decimal.mark = ",")`
ja efektikooksi (epsilon-neliö)
`r format(round(epsilon2, 3), decimal.mark = ",")`. Pienimpien ja suurimpien
kuntien vertailu antaa rank-biseriaaliseksi korrelaatioksi
`r format(round(rank_biserial, 3), decimal.mark = ",")`.
**Miksi juuri nämä testit.** Vertailtava suure — sähköautoja latauspistoketta
kohti — on vino: useimmissa kunnissa luku on pieni, muutamassa hyvin suuri.
Lisäksi se ei voi olla negatiivinen. Keskiarvojen vertailuun tarkoitetut testit,
kuten varianssianalyysi, olettavat suunnilleen symmetristä jakaumaa, eikä se
päde tässä.
Kruskal–Wallis-testi ei vertaa keskiarvoja vaan järjestyslukuja. Se asettaa
kaikki kunnat suuruusjärjestykseen ja katsoo, kasautuvatko jonkin kokoluokan
kunnat järjestyksen toiseen päähän. Menetelmä ei oleta jakauman muodosta
mitään, mikä on tässä välttämätöntä.
**Miksi efektikoko on pakollinen.** P-arvo kertoo vain, selittääkö sattuma
havaitun eron. Riittävän suuressa aineistossa mitättömänkin pieni ero tuottaa
pienen p-arvon. Epsilon-neliö kertoo, kuinka suuri osa järjestyksen vaihtelusta
selittyy kuntakoolla; loput selittyy muilla tekijöillä. Rank-biseriaalinen
korrelaatio puolestaan kertoo suoraan, kuinka todennäköisesti satunnaisesti
valittu pieni kunta on järjestyksessä eri puolella kuin satunnaisesti valittu
suuri kunta.
Näiden raportoiminen yhdessä on olennaista, koska pelkkä p-arvo antaisi
vaikutelman suuresta löydöksestä silloinkin kun ero on käytännössä
merkityksetön.
::: {.callout-important}
## Varaus, jota ei voi ohittaa
Kunnat eivät ole toisistaan riippumattomia havaintoja. Vierekkäiset kunnat
muistuttavat toisiaan enemmän kuin kaukana toisistaan sijaitsevat, koska
työssäkäyntialueet, tulotasot ja liikenneyhteydet eivät noudata kuntarajoja.
Tämä tarkoittaa, että testien oletus riippumattomista havainnoista ei täysin
päde, ja p-arvot ovat todellista pienempiä — eli tulos näyttää varmemmalta kuin
on. Ilmiön nimi on spatiaalinen autokorrelaatio.
Sen mittaaminen vaatii tiedon siitä, mitkä kunnat ovat toistensa naapureita, eli
kuntien geometrian. Ilman sitä voin todeta ongelman olemassaolon mutta en sen
suuruutta. Raportoin siksi efektikoot, jotka eivät kärsi tästä samalla tavalla,
ja suhtaudun p-arvoihin varauksella.
Tämä on yleinen ja usein vaiettu ongelma kaikessa aluevertailussa: kun kunnat,
maakunnat tai postinumeroalueet laitetaan tilastolliseen testiin toisistaan
riippumattomina, tulos on järjestelmällisesti liian varma.
:::
::: {.callout-note}
## Faktalaatikko: kumpi tuli ensin, auto vai laturi?
Latausverkkoa ja sähköautokantaa vertailtaessa törmätään taloustieteen
klassiseen ongelmaan. Latureita rakennetaan sinne, missä on sähköautoja, ja
sähköautoja hankitaan sinne, missä on latureita. Kumpi vaikuttaa kumpaan?
Kysymystä kutsutaan endogeenisuudeksi, ja se tekee yksinkertaisesta
korrelaatiosta harhaanjohtavan. Jos havaitaan, että laturimäärä ja autokanta
kulkevat käsi kädessä, siitä ei voi päätellä että laturien rakentaminen lisäisi
autoja — yhteys voi kulkea kokonaan toiseen suuntaan.
*Li ym. (2017)* ratkaisi ongelman käyttämällä välinemuuttujaa: alueen
ruokakauppojen määrää. Ajatus on, että kauppojen pysäköintialueet tarjoavat
luontevia paikkoja latureille, mutta kauppojen määrä ei itsessään vaikuta
siihen, kannattaako sähköauto ostaa. Näin latureiden määrään saadaan vaihtelua,
joka ei johdu sähköautojen määrästä. He päätyivät joustoon noin 0,8 — eli
prosentin lisäys latureissa kasvattaisi rekisteröintejä 0,8 prosenttia.
*Springel (2021, American Economic Journal: Economic Policy)* toisti asetelman
Norjan aineistolla ja päätyi selvästi pienempään keskeiseen arvioon, noin 0,22.
Ero ei ole ristiriita vaan seuraus verkon kehitysvaiheesta: kun Springelin
aineistosta valitaan vastaava verkkotiheys kuin Li ym:n aineistossa, jousto
nousee noin tasolle 0,54.
**Mitä tästä seuraa tälle analyysille.** Tässä osassa esitetyt havainnot ovat
kuvailevia. Ne kertovat, missä laturit ja autot ovat suhteessa toisiinsa, mutta
eivät sitä, mitä tapahtuisi jos latureita rakennettaisiin lisää. Se on eri
kysymys ja vaatii eri menetelmän.
**Ja mitä tästä seuraa päättäjälle.** Latausaseman rakentamisen vaikutus riippuu
siitä, kuinka paljon asemia jo on. Harvassa verkossa yksi lisäasema vaikuttaa
paljon, tiheässä vähän. Sama euro tuottaa eri tuloksen eri paikassa, ja tämä on
mitattavissa oleva suure eikä mielipide.
:::
## Vaihtoehtoiset skenaariot
Havaittu tilanne on vain yksi mahdollinen. Sitä kannattaa verrata vaihtoehtoihin,
koska vasta vertailu kertoo, onko nykytilanne hyvä vai huono.
Rakennan kolme vaihtoehtoista maailmaa, joissa kaikissa on **täsmälleen sama
määrä pistokkeita** kuin todellisuudessa. Vain sijoittelu muuttuu. Tämä on
olennaista: skenaariot eivät vaadi lisärahaa, vaan kertovat mitä nykyisellä
määrällä olisi mahdollista saavuttaa toisella jaolla.
```{r}
#| label: counterfactual
#| echo: true
kok_pistokkeet <- sum(yhdistetty$pistokkeita)
kok_sahkoautot <- sum(yhdistetty$sahkoautoja)
n_kuntia <- nrow(yhdistetty)

skenaariot <- yhdistetty |>
  transmute(
    kunta, sahkoautoja,
    `Todellinen sijoittelu` = pistokkeita,
    `A: sähköautojen suhteessa` = kok_pistokkeet * sahkoautoja / kok_sahkoautot,
    `B: pohja jokaiseen kuntaan` = 4 +
      (kok_pistokkeet - 4 * n_kuntia) * sahkoautoja / kok_sahkoautot,
    `C: tasan kunnittain` = kok_pistokkeet / n_kuntia
  ) |>
  pivot_longer(-c(kunta, sahkoautoja), names_to = "skenaario",
               values_to = "pistokkeita") |>
  filter(sahkoautoja > 0) |>
  mutate(suhde = sahkoautoja / pmax(pistokkeita, 0.5))

stopifnot(
  "Skenaarion pistokemäärä poikkeaa todellisesta yli 1 %" =
    skenaariot |> group_by(skenaario) |>
      summarise(s = sum(pistokkeita), .groups = "drop") |>
      pull(s) |> (\(x) all(abs(x / kok_pistokkeet - 1) < 0.01))()
)

# Painotettu mediaani: jokainen sähköauto saa saman painon, ei jokainen
# kunta. Kysymys on autoilijan kokemuksesta, ei kuntien keskiarvosta.
w_mediaani <- function(x, w, p = 0.5) {
  o <- order(x); x <- x[o]; w <- w[o]
  x[which(cumsum(w) / sum(w) >= p)[1]]
}

vertailu <- skenaariot |>
  group_by(skenaario) |>
  summarise(
    mediaani_auto = w_mediaani(suhde, sahkoautoja),
    huonoin_kymmenys = w_mediaani(suhde, sahkoautoja, 0.9),
    osuus_yli_50 = sum(sahkoautoja[suhde > 50]) / sum(sahkoautoja),
    .groups = "drop"
  ) |>
  arrange(mediaani_auto)
```
```{r}
#| label: kuva-skenaariot
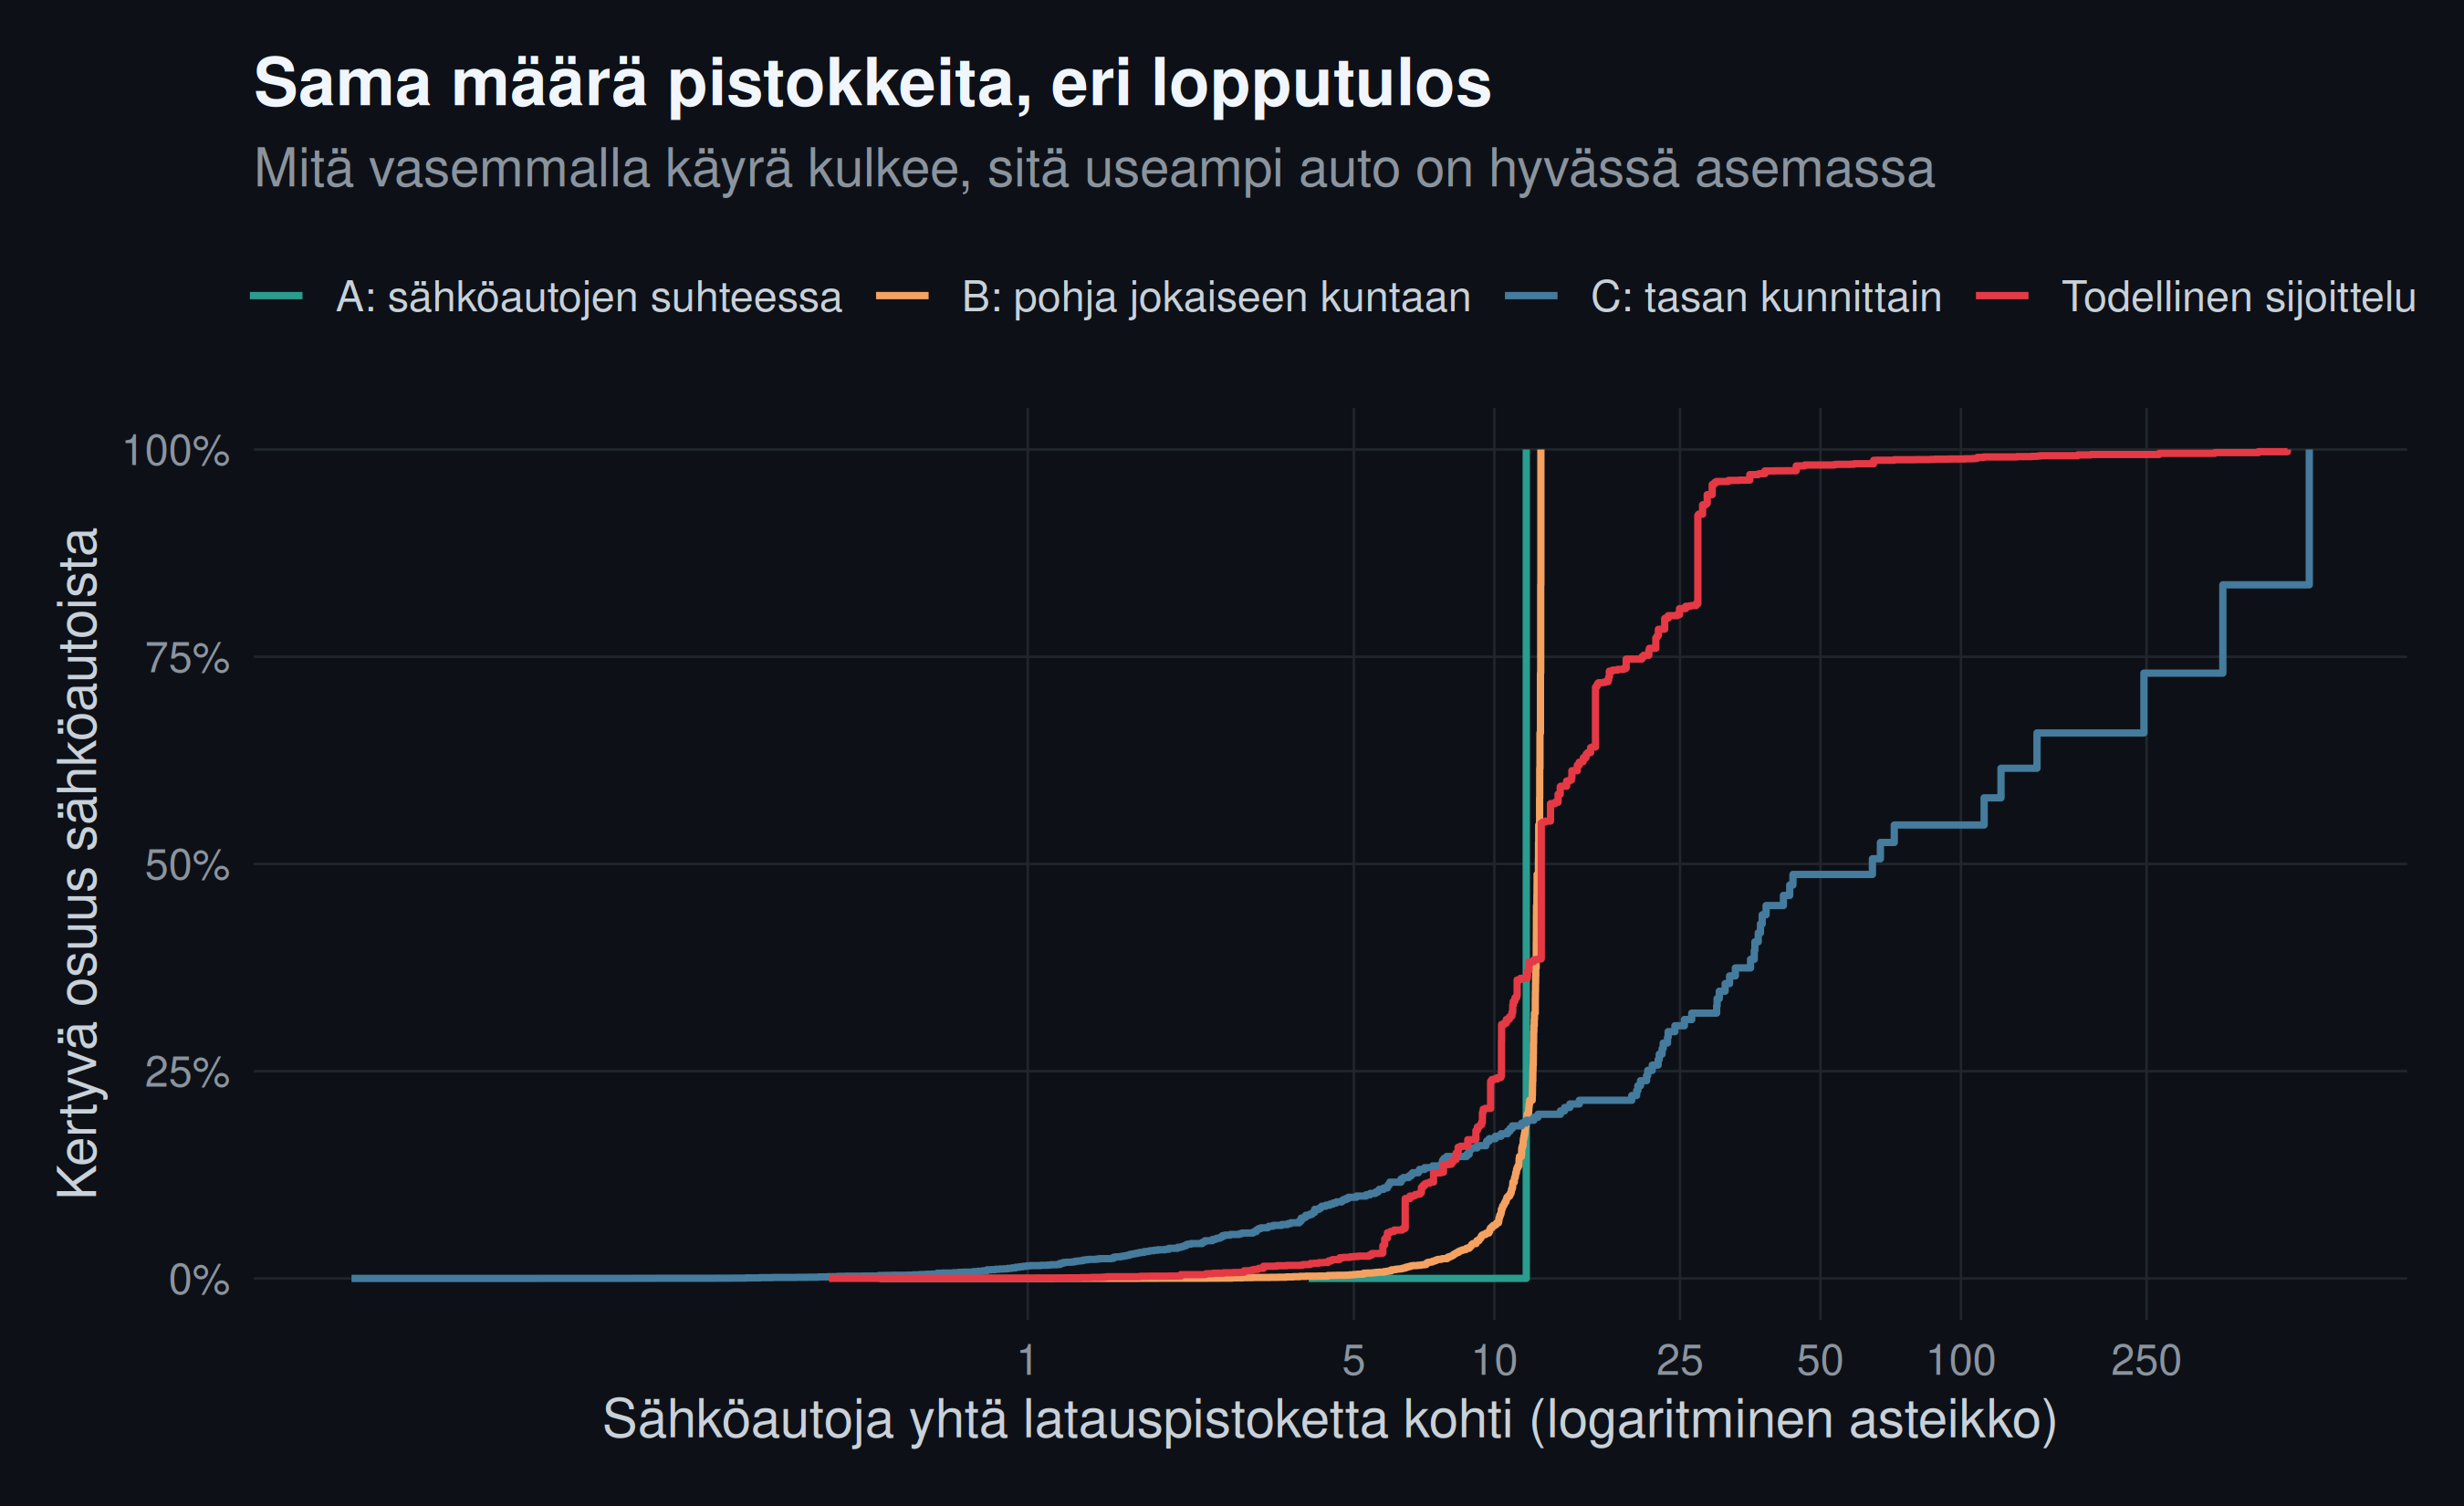
#| fig-cap: "Kuinka moni sähköauto jakaa latauspistokkeensa kuinka monen muun kanssa, neljässä eri maailmassa."
skenaariot |>
arrange(suhde) |>
group_by(skenaario) |>
mutate(kum_osuus = cumsum(sahkoautoja) / sum(sahkoautoja)) |>
ungroup() |>
ggplot(aes(suhde, kum_osuus, colour = skenaario)) +
geom_step(linewidth = 0.9) +
scale_x_log10(breaks = c(1, 5, 10, 25, 50, 100, 250),
labels = c("1", "5", "10", "25", "50", "100", "250")) +
scale_y_continuous(labels = percent) +
scale_colour_manual(values = c(
"Todellinen sijoittelu" = unname(pal["punainen"]),
"A: sähköautojen suhteessa" = unname(pal["turkoosi"]),
"B: pohja jokaiseen kuntaan" = unname(pal["oranssi"]),
"C: tasan kunnittain" = unname(pal["sininen"]))) +
labs(x = "Sähköautoja yhtä latauspistoketta kohti (logaritminen asteikko)",
y = "Kertyvä osuus sähköautoista", colour = NULL,
title = "Sama määrä pistokkeita, eri lopputulos",
subtitle = "Mitä vasemmalla käyrä kulkee, sitä useampi auto on hyvässä asemassa")
```
**Miten kuvaa luetaan.** Vaaka-akselilla on luku, joka kertoo montako
sähköautoa jakaa yhden latauspistokkeen kunnassa. Pieni luku on hyvä.
Pystyakselilta luetaan, kuinka suuri osa kaikista sähköautoista on tuota lukua
paremmassa tai yhtä hyvässä asemassa.
Jos käyrä nousee jyrkästi vasemmalla, useimmilla autoilla on tilaa. Jos se
kulkee loivana oikealle, iso osa autoista jakaa pistokkeensa monen kanssa.
Kuva on tehty **sähköautojen näkökulmasta, ei kuntien.** Ero on tärkeä. Jos
laskisin kuntien keskiarvon, jokainen pieni kunta painaisi yhtä paljon kuin
Helsinki, ja tulos kuvaisi kuntia eikä autoilijoita. Nyt jokainen auto painaa
saman verran, ja luku vastaa kysymykseen "mitä satunnainen suomalainen
sähköauto kohtaa".
Vertailukohdat ovat samalla logiikalla painotettuja: mediaanisähköauto jakaa
pistokkeensa `r round(vertailu$mediaani_auto[vertailu$skenaario == "Todellinen sijoittelu"])`
auton kanssa, ja huonoimmassa kymmenyksessä luku on
`r round(vertailu$huonoin_kymmenys[vertailu$skenaario == "Todellinen sijoittelu"])`.
Vertailun opetus on käsitteellinen. Kun latausverkon puutteista puhutaan,
oletetaan yleensä että ratkaisu on rakentaa lisää. Skenaariovertailu erottaa
kaksi kysymystä toisistaan: onko pistokkeita liian vähän, vai ovatko ne
väärissä paikoissa? Nämä vaativat eri toimenpiteitä, ja vain toinen maksaa
rahaa.
Skenaario B on kiinnostavin, koska se vastaa yleisintä poliittista tavoitetta:
jokaiseen kuntaan vähintään jotain. Sen hinta näkyy käyrässä suoraan — pohjan
rakentaminen on pois sieltä, missä käyttöä olisi eniten. Kysymys ei ole siitä,
kumpi on oikein, vaan siitä että valinta tehdään näkyvästi eikä vahingossa.
::: {.callout-note}
## Faktalaatikko: julkisen verkon merkitys riippuu kotilatauksesta
Julkisen latausverkon tarve ei ole sama kaikille. Omakotitalossa asuva, joka
lataa autonsa yöllä kotona, käyttää julkista verkkoa lähinnä pitkillä matkoilla.
Kerrostalossa ilman omaa latauspaikkaa asuva on siitä täysin riippuvainen.
Latauskäyttäytymistä koskeva tutkimuskirjallisuus on tunnistanut tämän
puutteeksi omassa metodologiassaan. *Transportation Research Part D* -lehdessä
julkaistussa katsauksessa huomautetaan, että tarjontapuolen tutkimukset — eli
ne, jotka mallintavat mihin latureita kannattaisi sijoittaa — nojaavat usein
yksinkertaistaviin oletuksiin latauskäyttäytymisestä ja jättävät koti- ja
työpaikkalatauksen huomiotta.
**Mitä tästä seuraa.** Kuntakohtainen luku "sähköautoja per julkinen pistoke" ei
ole vertailukelpoinen kuntien välillä, jos asumismuoto eroaa. Kunnassa, jossa
asutaan omakotitaloissa, sata autoa yhtä julkista pistoketta kohti voi olla
täysin riittävä. Tiiviisti rakennetussa kaupungissa sama suhde tarkoittaa jonoa.
Tämä on syy siihen, miksi en esitä tässä kuntien paremmuusjärjestystä
pistokesuhteen mukaan. Luku on tulkittava vain yhdessä asumismuodon kanssa, ja
ilman sitä lista olisi näennäisen täsmällinen mutta harhaanjohtava. Tässä on
esimerkki siitä, että analyysin rajaaminen on itsessään tulos: joskus oikea
vastaus on, ettei kysymykseen voi vielä vastata käytettävissä olevalla
aineistolla.
:::
## Mitä jää käteen
**Kansallinen keskiarvo ei kuvaa yhtäkään kuntaa.** Sähköistymisaste vaihtelee
kunnittain moninkertaisesti, ja vaihtelu on systemaattista.
**Kaupunkimaisuus ei selitä eroa.** Pääkaupunkiseutu erottuu selvästi muista
suurista kaupungeista, joten kaupunki–maaseutu-jaottelun perusteella tehty
kohdennus osuisi väärin.
**Ladattavat hybridit kuormittavat verkkoa eri tavalla.** Ne kilpailevat
kaupungin hitaista pistokkeista mutta eivät pikalatureista. Yksi suhdeluku ei
riitä kuvaamaan molempia.
**Pienten yksiköiden luvut ovat epäluotettavampia mutta näyttävät yhtä
tarkoilta.** Ilman kutistamista kärkilistat täyttyvät pienistä kunnista, joissa
satunnaisvaihtelu on suurinta.
**Sijoittelu on eri kysymys kuin määrä.** Skenaariovertailu erottaa nämä
toisistaan, ja vain toinen ratkeaa rahalla.
**Kuvaileva havainto ei ole syy-seuraussuhde.** Se, että laturit ja autot ovat
samoissa kunnissa, ei kerro kumpi vaikuttaa kumpaan.
**Ja analyysin rajaaminen on tulos.** Kuntataso ja julkisten pistokkeiden
laskenta eivät riitä kertomaan, kuka oikeasti jää latausverkon ulkopuolelle.
Siihen tarvitaan todelliset ajoetäisyydet tieverkkoa pitkin — ja se on
seuraavan osan aihe.
---
## Mitä tästä on hyötyä yrityksellesi
**Lopeta pienten yksiköiden vertaaminen suoraan.** Jos vertaat myymälöitä,
tiimejä, toimipisteitä tai asiakassegmenttejä keskenään, pienimmät heittelevät
eniten. Ilman korjausta parhaat ja huonoimmat sijat menevät järjestelmällisesti
pienimmille yksiköille, ja niiden perusteella tehdyt palkitsemis- tai
puuttumispäätökset kohdistuvat väärin.
Tämä on yksi konkreettisimmista tavoista, joilla tilastotiede tuottaa suoraa
rahallista hyötyä: se estää reagoimasta kohinaan. Jokainen turha
kehittämisprojekti, joka käynnistetään yhden neljänneksen poikkeaman takia, on
puhdasta kustannusta — ja sen välttäminen on muutaman rivin työ.
**Erota määrä ja sijoittelu.** Kun jokin ei riitä, ensimmäinen reaktio on
hankkia lisää. Usein sama määrä toisin jaettuna riittäisi. Skenaariovertailu,
jossa kokonaismäärä pidetään vakiona ja jakoa muutetaan, vastaa tähän ja on
halpa tehdä. Sovella varastoihin, henkilöstöön, laitteisiin, huoltoverkostoon
tai markkinointibudjettiin.
**Kysy aina, mihin suuntaan syy-yhteys kulkee.** Jos myynti ja markkinointikulut
korreloivat alueittain, se ei kerro kumpi aiheuttaa kumman — markkinointia
kohdistetaan alueille, joilla myydään. Tämän tunnistaminen ei vaadi
ekonometrian tohtorintutkintoa, vaan sen kysymistä ääneen ennen kuin päätös
tehdään. Useimmiten vastaaminen vaatii kokeen: satunnaista kohdennus osittain ja
katso mitä tapahtuu.
**Vaadi epävarmuus mukaan raportteihin.** Tässä osassa jokainen kuntakohtainen
arvio sai oman vaihteluvälinsä. Kun johtoryhmälle esitetään yksikkökohtaisia
lukuja ilman vaihteluväliä, esitys antaa ymmärtää että kaikki luvut ovat yhtä
luotettavia. Ne eivät ole, ja ero on usein kertaluokkia.
**Tarkista, ovatko aineistot samalta ajanhetkeltä.** Tämän postauksen
hankalin virhe ei ollut nimissä vaan ajassa: kuntageometria oli vuodelta 2021
ja autokanta vuodelta 2026, ja välissä kaksi kuntaa oli lakannut olemasta.
Liitos onnistui teknisesti täydellisesti, ja tulos olisi ollut väärä.
Sama pätee kaikkiin organisaatiorakenteisiin. Kustannuspaikat yhdistyvät,
tuoteryhmät nimetään uudelleen, myyntialueet piirretään uusiksi. Jos vertaat
tämän vuoden lukuja viime vuoden rakenteeseen, osa datasta katoaa
huomaamatta — eikä mikään järjestelmä huomauta siitä. Kysy aina, minkä hetken
rakennetta kumpikin aineisto kuvaa.
**Älä liitä nimillä, jos voit liittää tunnisteilla tai sijainnilla.** Tämän
postauksen liitos kahden aineiston välillä epäonnistui aluksi, koska
latausrekisterin kuntakenttä sisälsi kaupunginosia ja ruotsinkielisiä nimiä.
Ratkaisu ei ollut korjata nimiä vaan käyttää koordinaatteja, jotka olivat
samassa aineistossa ja luotettavia.
Sama tilanne toistuu jatkuvasti: asiakkaiden nimet, tuotenimikkeet,
osoitteet. Nimipohjainen liitos tuottaa aina osumaprosentin, joka näyttää
hyväksyttävältä — ja jokainen puuttuva osuma katoaa hiljaisesti. Kysy aina,
onko aineistossa jokin kenttä, joka on syntynyt koneellisesti eikä käsin
kirjoitettuna. Yleensä on.
**Tarkista, mittaako luokittelusi sitä mitä luulet.** Kaupunki–maaseutu-jako
näyttäisi luontevalta tavalta segmentoida latausinfran tarve, mutta se ei
tavoita ilmiötä: kaksi samankokoista kaupunkia voi erota lähes
kaksinkertaisesti. Sama pätee useimpiin valmiisiin segmentointeihin — toimiala,
yrityskoko, ikäryhmä. Ne ovat käteviä ja usein vääriä. Testaa segmentointi
ennen kuin rakennat sen varaan: jos segmentin sisäinen vaihtelu on yhtä suuri
kuin segmenttien välinen, segmentti ei kerro mitään.
**Erota datan hakeminen ja datan käyttäminen.** Tämän postauksen työläin vaihe
ei ollut analyysi vaan rajapinnan taivuttelu. Ratkaisu on tehdä haku kerran,
tallentaa tulos tiedostoon ja rakentaa kaikki analyysi tiedoston varaan. Silloin
rajapinnan rikkoutuminen ei kaada analyysia eikä estä sen toistamista
puolen vuoden päästä.
Sama koskee organisaatiosi sisäisiä integraatioita. Jos raportti hakee dataa
suoraan lähdejärjestelmästä joka ajolla, se on yhtä luotettava kuin heikoin
lenkki ketjussa — ja lähdejärjestelmää ylläpitää joku, joka ei ole luvannut
sinulle mitään.
**Ja lue alaviitteet.** Tässä käytetty aineisto ei sisällä Ahvenanmaata. Se
lukee taulun alaviitteessä. Vastaava rajaus on lähes jokaisessa virallisessa
tilastossa, ja se on tavallisimpia syitä siihen, miksi kaksi raporttia samasta
asiasta antaa eri luvun — ja miksi niistä kiistellään kokouksessa, jossa
kummallakaan osapuolella ei ole alaviitettä mukanaan.
Jos organisaatiossasi vertaillaan erikokoisia yksiköitä keskenään, tai jos
resurssien riittävyydestä keskustellaan ilman että sijoittelua on koskaan
laskettu vaihtoehtoisesti, siinä on työtä odottamassa. Teen tätä vuokrattavana
Head of Datana ja projektikohtaisesti — hinnasto ja yhteystiedot löytyvät
[sivustolta](https://kristianvepsalainen.com).
---
*Aineistot: Traficomin tilastotietokanta (liikennekäytössä olevat henkilöautot,
taulu 010_kanta_tau_101) ja Fintraffic AFIR / Digitraffic. Tutkimuslähteet: Li
ym. (2017), Springel (2021). Koodi on kokonaisuudessaan tässä postauksessa.
Maailma on jakauma.*