---
title: "Puolet sähköautoilijoista ei tarvitse julkista latausverkkoa lainkaan"
subtitle: "Latausverkko jakaumana, osa 6: kotilataus, postinumerotason saavutettavuus ja se kenelle puute oikeasti sattuu"
description: |
Julkisen latausverkon riittävyyttä mitataan autoja per pistoke. Luku
olettaa, että kaikki autot tarvitsevat julkista laturia. Omakotitalossa
asuva ei tarvitse. Lasketaan uudelleen niin, että kotilatausmahdollisuus
otetaan huomioon.
date: 2026-10-06
categories: [avoin data, latausverkko, saavutettavuus, Paavo, eriarvoisuus]
---
```{r}
#| label: setup
#| include: false
#| cache: false
library(here)
library(tidyverse)
library(sf)
library(dodgr)
library(spdep)
library(ggrepel)
library(ggdist)
library(patchwork)
library(qs2)
library(scales)
select <- dplyr::select
filter <- dplyr::filter
count <- dplyr::count
source(here("R", "theme_kristian.R"))
knitr::opts_chunk$set(
echo = FALSE, warning = FALSE, message = FALSE,
fig.width = 9, fig.height = 5.5, dpi = 150
)
theme_set(theme_kristian())
pal <- c(punainen = "#e63946", turkoosi = "#2a9d8f", oranssi = "#f4a261",
navy = "#1d3557", sininen = "#457b9d")
data_dir <- here("data", "latausverkko")
set.seed(42)
asemat <- qs2::qd_read(file.path(data_dir, "asemat.qs"))
liitokset <- qs2::qd_read(file.path(data_dir, "liitokset.qs"))
kunnat_sf <- qs2::qs_read(file.path(data_dir, "kunnat_lau.qs"))
tieverkko <- qs2::qs_read(file.path(data_dir, "tieverkko.qs"))
tieverkko <- tieverkko[tieverkko$component == 1, ]
```
## Mittari, joka olettaa liikaa
Latausverkon riittävyydestä puhuttaessa toistuu yksi suhdeluku: kuinka monta
sähköautoa on yhtä julkista latauspistettä kohti. Luku on helppo laskea ja
näennäisen selkeä.
Se olettaa, että jokainen sähköauto tarvitsee julkista laturia. Valtaosa ei
tarvitse.
Omakotitalossa asuva kytkee autonsa illalla pistorasiaan ja herää täyteen
akkuun. Hänelle julkinen verkko on tarpeen vain pitkillä matkoilla, ehkä
muutaman kerran vuodessa. Kerrostalossa ilman omaa latauspaikkaa asuvalle
julkinen verkko on ainoa vaihtoehto, ja hän tarvitsee sitä joka viikko.
Nämä kaksi ihmistä lasketaan tilastossa samaksi. Se tekee suhdeluvusta
harhaanjohtavan tavalla, joka ei ole satunnainen vaan systemaattinen:
mittari yliarvioi tarvetta siellä, missä asutaan väljästi, ja aliarvioi sitä
siellä, missä asutaan tiiviisti.
Tässä osassa lasken saavutettavuuden uudelleen postinumeroalueittain ja
painotan sen asumismuodolla. Lopputulos on kartta siitä, missä julkisen
latausverkon puute oikeasti tuntuu.
## Aineisto: Paavo-postinumeroalueet
Tilastokeskuksen Paavo-aineisto kuvaa Suomen postinumeroalueita. Se sisältää
väkiluvun, koordinaatit, tulotason, koulutuksen ja — tämän osan kannalta
ratkaisevana — asuntojen jakautumisen pientaloihin ja kerrostaloihin.
Aineistossa on noin kolmetuhatta aluetta, mikä on kymmenkertainen tarkkuus
kuntatasoon verrattuna. Ero on merkittävä: kunta voi olla satojen
neliökilometrien kokoinen, ja sen sisällä tiivis keskusta ja harvaan asuttu
haja-asutusalue ovat latausverkon kannalta täysin eri maailmoja.
```{r}
#| label: paavo
#| echo: true
#| cache: false
paavo_path <- file.path(data_dir, "paavo.qs")

stopifnot(
  "Paavo-aineisto puuttuu. Hae se pxweb_interactive-funktiolla (ks. teksti)." =
    file.exists(paavo_path)
)

pno <- qs2::qs_read(paavo_path)

stopifnot(
  "Postinumeroaineisto on tyhjä" = nrow(pno) > 2500,
  "Vaadittuja sarakkeita puuttuu" =
    all(c("pno", "kunta", "asukkaat", "pientaloasunnot",
          "kerrostaloasunnot", "mediaanitulot") %in% names(pno)),
  "Koordinaattijärjestelmä ei ole TM35FIN" = st_crs(pno)$epsg == 3067
)
```
::: {.callout-note}
## Aineiston hakeminen
Paavo-aineisto haetaan Tilastokeskuksen tietokannasta. Helpoin tapa on
`pxweb`-paketin interaktiivinen valikko, joka rakentaa kyselyn puolestasi ja
tulostaa valmiin koodin:
```r
pxweb::pxweb_interactive("https://pxdata.stat.fi/PXWeb/api/v1/fi/Postinumeroalueittainen_avoin_tieto")
```
Valitse uusin vuosikerta ja kaikki muuttujat. Aineisto on pieni, joten
solurajoitus ei tule vastaan. Tallenna tulos tiedostoon ja lue se sieltä —
älä hae rajapinnasta joka ajolla.
:::
```{r}
#| label: kotilataus
#| echo: true
# Kotilatausmahdollisuus arvioidaan pientaloasuntojen osuudesta.
# Tämä on approksimaatio: kaikilla pientaloasujilla ei ole
# latausmahdollisuutta eikä kaikilta kerrostaloasujilta se puutu.
pno <- pno |>
  mutate(
    asuntoja = pientaloasunnot + kerrostaloasunnot,
    pientalo_osuus = if_else(asuntoja > 0, pientaloasunnot / asuntoja,
                             NA_real_)
  )

stopifnot(
  "Pientalo-osuus jakauman ulkopuolella" =
    all(between(pno$pientalo_osuus, 0, 1), na.rm = TRUE),
  "Pientalo-osuus puuttuu liian monelta alueelta" =
    mean(is.na(pno$pientalo_osuus)) < 0.10
)

koko_maa_pientalo <- weighted.mean(pno$pientalo_osuus, pno$asukkaat,
                                   na.rm = TRUE)

hajonta <- pno |>
  filter(!is.na(pientalo_osuus), asukkaat >= 100) |>
  summarise(
    q10 = quantile(pientalo_osuus, 0.1),
    q50 = quantile(pientalo_osuus, 0.5),
    q90 = quantile(pientalo_osuus, 0.9)
  )
```
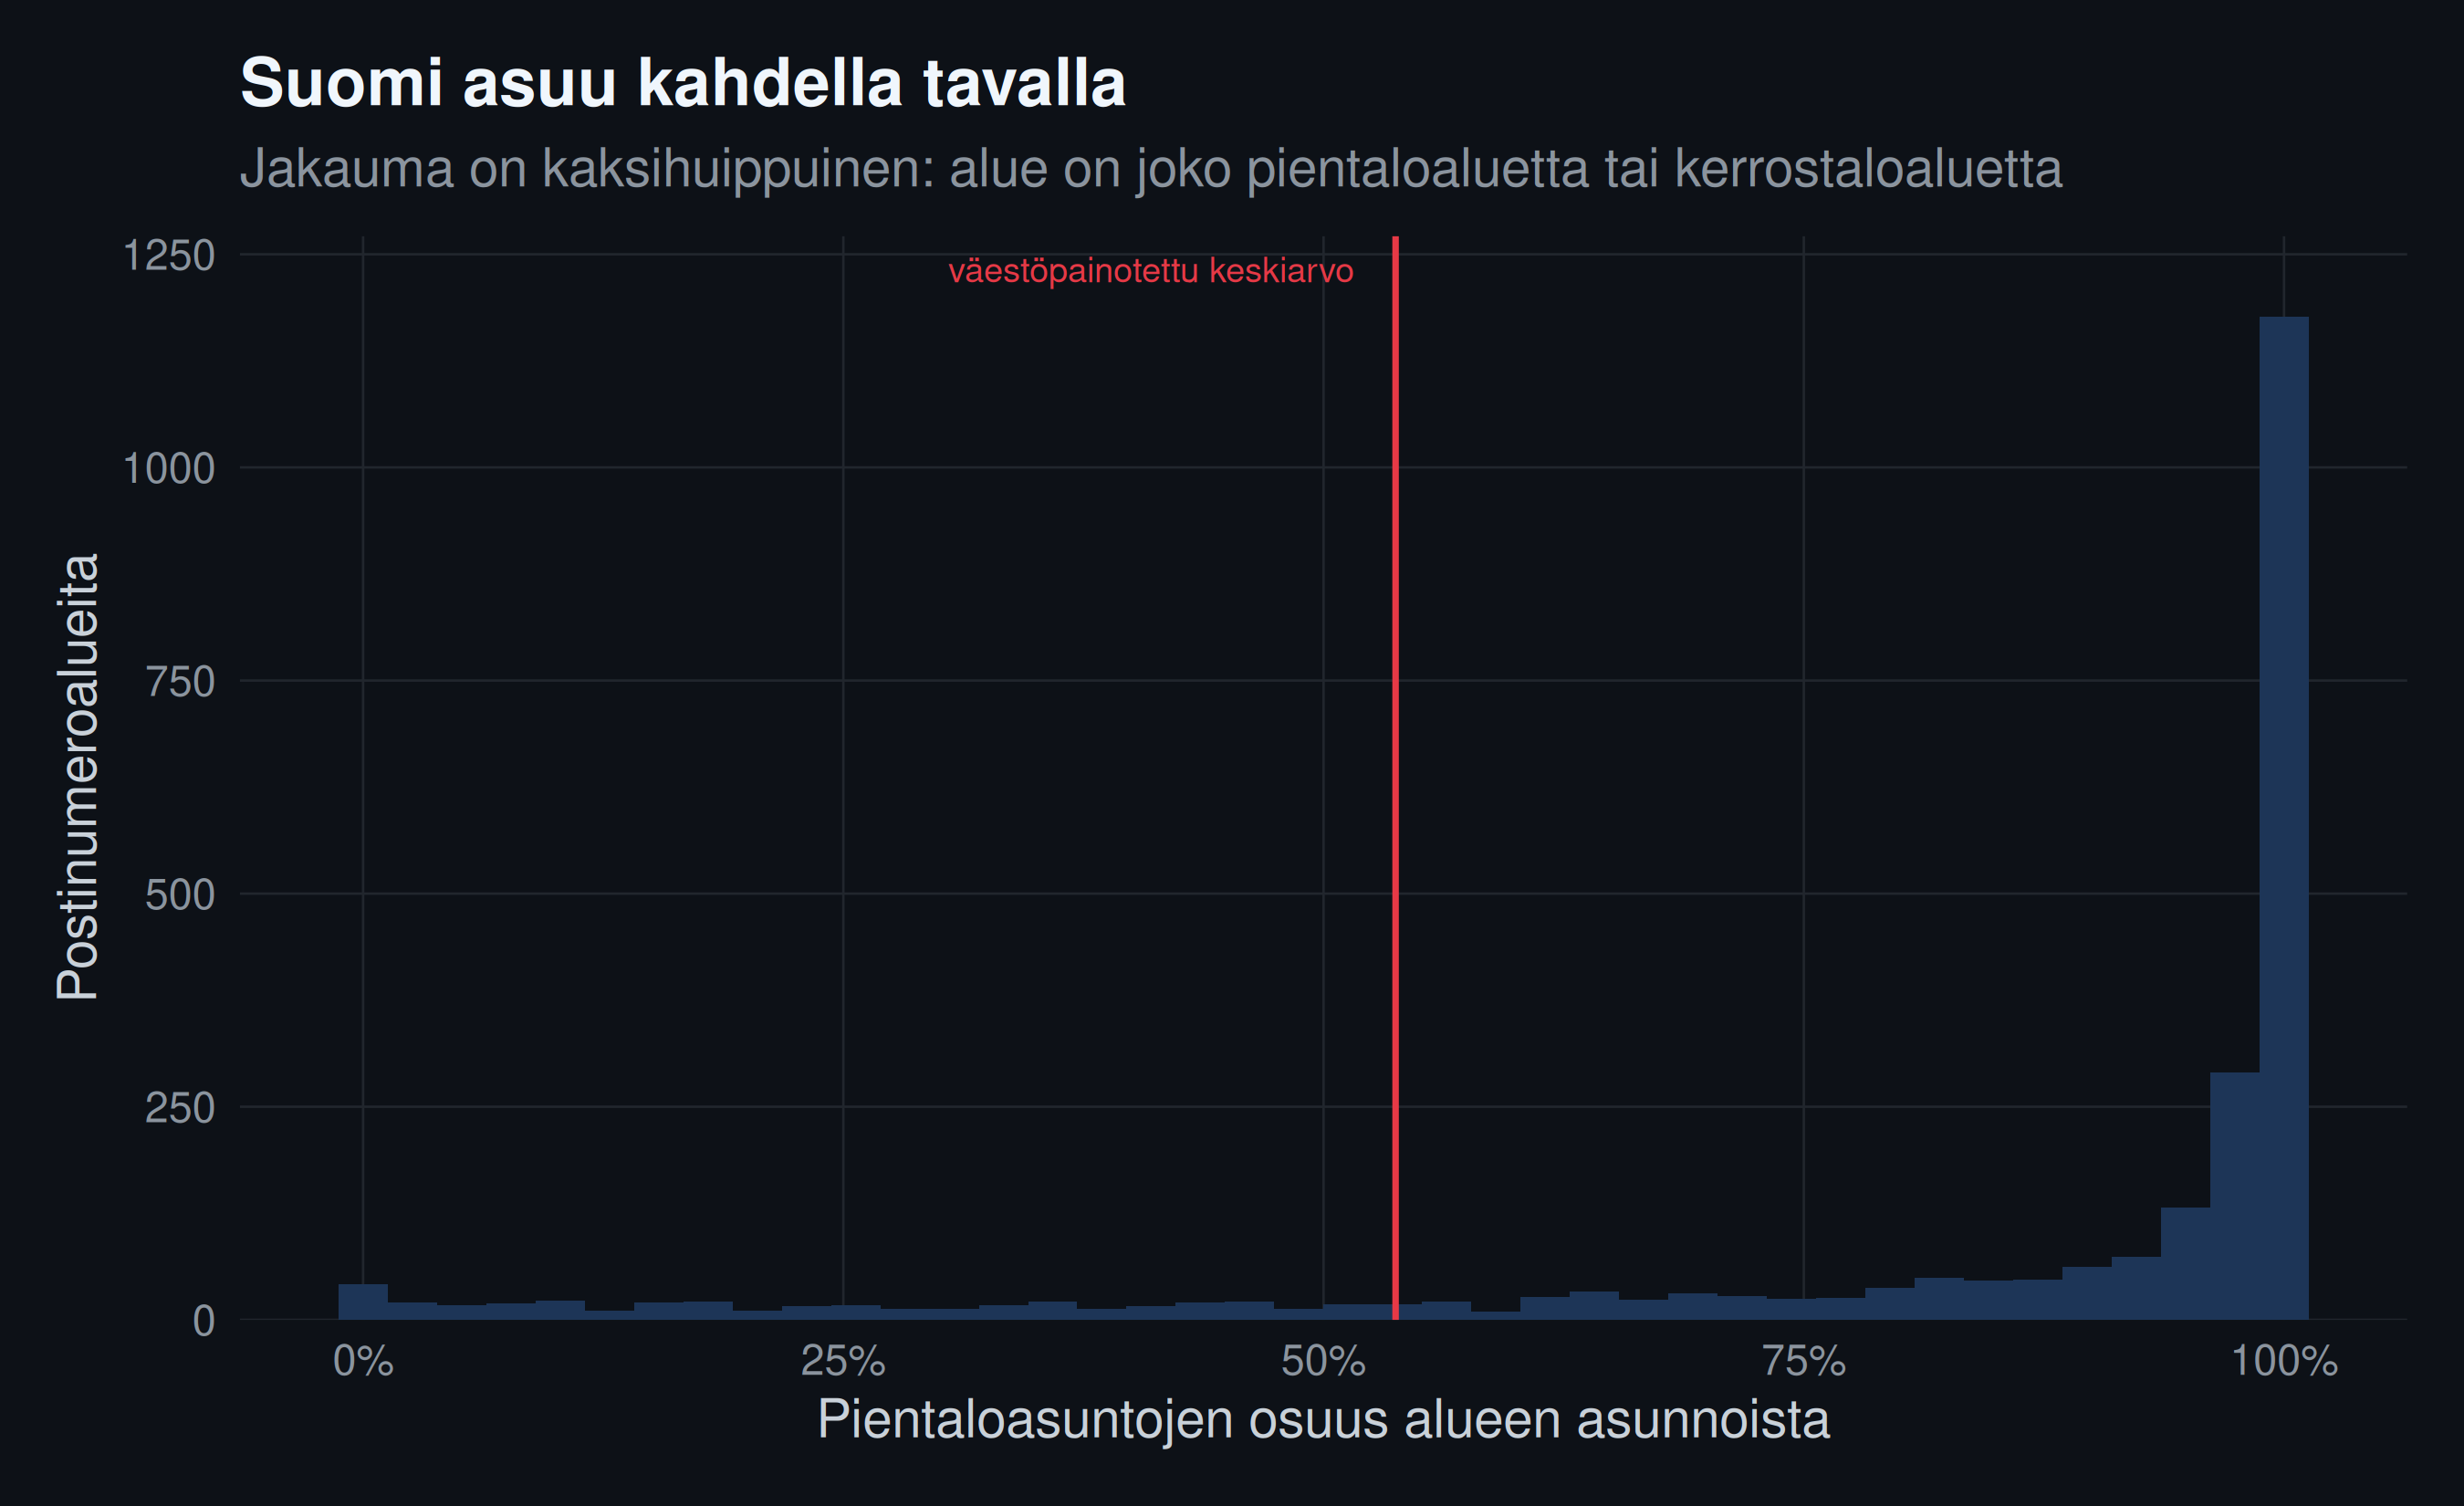
Koko maassa `r percent(koko_maa_pientalo, accuracy = 1)` asukkaista asuu
alueella, jonka asunnoista valtaosa on pientaloja. Alueiden välinen vaihtelu on
kuitenkin suurta: kymmenesosassa alueista pientalojen osuus on alle
`r percent(hajonta$q10, accuracy = 1)` ja kymmenesosassa yli
`r percent(hajonta$q90, accuracy = 1)`.
```{r}
#| label: kuva-pientalot
#| fig-cap: "Pientaloasuntojen osuus postinumeroalueittain."
pno |>
st_drop_geometry() |>
filter(!is.na(pientalo_osuus), asukkaat >= 100) |>
ggplot(aes(pientalo_osuus)) +
geom_histogram(bins = 40, fill = pal["navy"], colour = NA) +
geom_vline(xintercept = koko_maa_pientalo, colour = pal["punainen"],
linewidth = 0.8) +
annotate("text", x = koko_maa_pientalo, y = Inf, hjust = 1.05, vjust = 1.8,
label = "väestöpainotettu keskiarvo ", colour = pal["punainen"],
size = 3.2) +
scale_x_continuous(labels = percent) +
scale_y_continuous(expand = expansion(mult = c(0, 0.08))) +
labs(x = "Pientaloasuntojen osuus alueen asunnoista", y = "Postinumeroalueita",
title = "Suomi asuu kahdella tavalla",
subtitle = "Jakauma on kaksihuippuinen: alue on joko pientaloaluetta tai kerrostaloaluetta")
```
**Miten kuvaa luetaan.** Vaaka-akselilla on pientaloasuntojen osuus alueen
asunnoista. Pystyakselilta luetaan, kuinka moni postinumeroalue osuu kullekin
välille.
Jakauma ei ole yksihuippuinen vaan painottuu molempiin päihin. Alue on
tyypillisesti joko selvästi pientaloaluetta tai selvästi kerrostaloaluetta;
sekoittuneita alueita on vähemmän. Tämä on latausverkon kannalta olennaista,
koska se tarkoittaa että kotilatausmahdollisuus jakautuu jyrkästi eikä
tasaisesti.
::: {.callout-warning}
## Approksimaation rajat
Pientaloasuminen ei takaa latausmahdollisuutta eikä kerrostaloasuminen sulje
sitä pois. Rivitalossa voi olla autokatos ilman sähköä. Uudessa
kerrostaloyhtiössä voi olla latauspaikat jokaiselle. Vanhassa omakotitalossa
sähköpääkeskus ei välttämättä kestä latauskuormaa.
Käytän pientalo-osuutta silti, koska parempaa julkista tietoa
latauspistemäärästä asuinkiinteistöissä ei ole olemassa. Suunta on oikea ja
suuruusluokka uskottava, mutta yksittäisen alueen luku voi olla selvästi
pielessä.
Tämä on tyypillinen tilanne avoimen datan analyysissä: paras saatavilla oleva
muuttuja ei ole se muuttuja, jota haluttaisiin mitata. Vaihtoehdot ovat käyttää
sitä ja kertoa rajoite, tai olla laskematta mitään. Ensimmäinen on hyödyllisempi
kunhan jälkimmäinen osa tehdään.
:::
## Saavutettavuus postinumerotasolla
Nyt lasketaan ajoaika jokaisesta postinumeroalueesta lähimmälle
suurtehulaturille. Tämä on kymmenkertainen tarkkuus kuntatasoon verrattuna.
```{r}
#| label: hpc
#| echo: true
hpc <- liitokset |>
  filter(teho_kw >= 150) |>
  distinct(avain) |>
  left_join(asemat, by = "avain") |>
  filter(!is.na(lat), !is.na(lon))

# Kaikki julkiset latauspisteet, ei vain suurtehoiset: arjen
# latauksessa hitaampikin riittää.
kaikki_pisteet <- liitokset |>
  distinct(avain) |>
  left_join(asemat, by = "avain") |>
  filter(!is.na(lat), !is.na(lon))

stopifnot(
  "Suurtehulatureita ei löytynyt" = nrow(hpc) > 50,
  "Latauspisteitä ei löytynyt" = nrow(kaikki_pisteet) > 500
)
```
```{r}
#| label: ajoajat
#| echo: true
pno_ajat_path <- file.path(data_dir, "ajoajat_pno.qs")

if (!file.exists(pno_ajat_path)) {
  from <- pno |>
    st_transform(4326) |>
    st_coordinates() |>
    as_tibble() |>
    setNames(c("x", "y")) |>
    as.matrix()

  # Laskenta on raskas: noin 3 000 lähtöpistettä × satoja asemia.
  # Tulos tallennetaan, jotta se tehdään vain kerran.
  ajat_hpc <- dodgr_times(
    graph = tieverkko, from = from,
    to = as.matrix(select(hpc, x = lon, y = lat))
  )

  ajat_kaikki <- dodgr_times(
    graph = tieverkko, from = from,
    to = as.matrix(select(kaikki_pisteet, x = lon, y = lat))
  )

  stopifnot(
    "Aikamatriisin rivimäärä ei täsmää" = nrow(ajat_hpc) == nrow(pno)
  )

  saav <- tibble(
    pno = pno$pno,
    aika_hpc = apply(ajat_hpc, 1, \(r) min(r, na.rm = TRUE)) / 60,
    aika_mika_tahansa = apply(ajat_kaikki, 1, \(r) min(r, na.rm = TRUE)) / 60
  )

  qs2::qd_save(saav, pno_ajat_path)
} else {
  saav <- qs2::qd_read(pno_ajat_path)
}

alueet <- pno |>
  st_drop_geometry() |>
  left_join(saav, by = "pno") |>
  filter(is.finite(aika_hpc), asukkaat > 0)

osuus_kelvollisia <- nrow(alueet) / nrow(pno)

stopifnot(
  "Yli 10 % alueista jäi saavuttamattomiin" = osuus_kelvollisia > 0.90
)

# Väestöpainotetut tunnusluvut
w_kvantiili <- function(x, w, p) {
  o <- order(x); x <- x[o]; w <- w[o]
  x[which(cumsum(w) / sum(w) >= p)[1]]
}

vaesto_tunnusluvut <- alueet |>
  summarise(
    mediaani = w_kvantiili(aika_hpc, asukkaat, 0.5),
    q90 = w_kvantiili(aika_hpc, asukkaat, 0.9),
    yli_30min = sum(asukkaat[aika_hpc > 30]) / sum(asukkaat),
    yli_tunnin = sum(asukkaat[aika_hpc > 60]) / sum(asukkaat)
  )
```
Väestöpainotettu mediaani on `r round(vaesto_tunnusluvut$mediaani)` minuuttia:
puolet suomalaisista asuu alueella, josta lähimmälle suurtehulaturille pääsee
tässä ajassa. Yli tunnin päässä asuu
`r percent(vaesto_tunnusluvut$yli_tunnin, accuracy = 0.1)` väestöstä.
## Painotettu tarve: kuka oikeasti tarvitsee julkista verkkoa?
Nyt yhdistetään kaksi asiaa: kuinka kaukana julkinen laturi on ja kuinka
todennäköisesti alueen asukas tarvitsee sitä.
```{r}
#| label: tarve
#| echo: true
# Julkisen verkon tarve arvioidaan kerrostaloasumisen osuudesta.
# Kerrostaloasuja tarvitsee julkista latausta arjessa, pientaloasuja
# lähinnä matkoilla.
alueet <- alueet |>
  mutate(
    kerrostalo_osuus = 1 - pientalo_osuus,
    # Arkilatauksen tarpeessa olevat asukkaat
    tarvitsevat = asukkaat * kerrostalo_osuus,
    # Saavutettavuus arkilatauksen näkökulmasta: mikä tahansa
    # julkinen pistoke kelpaa, ei vain suurtehoinen
    aika_arki = aika_mika_tahansa
  ) |>
  filter(!is.na(tarvitsevat), is.finite(aika_arki))

tarve_tunnusluvut <- alueet |>
  summarise(
    tarvitsevia = sum(tarvitsevat),
    mediaani_kaikki = w_kvantiili(aika_arki, asukkaat, 0.5),
    mediaani_tarvitsevat = w_kvantiili(aika_arki, tarvitsevat, 0.5),
    yli_15min_kaikki = sum(asukkaat[aika_arki > 15]) / sum(asukkaat),
    yli_15min_tarvitsevat = sum(tarvitsevat[aika_arki > 15]) / sum(tarvitsevat)
  )
```
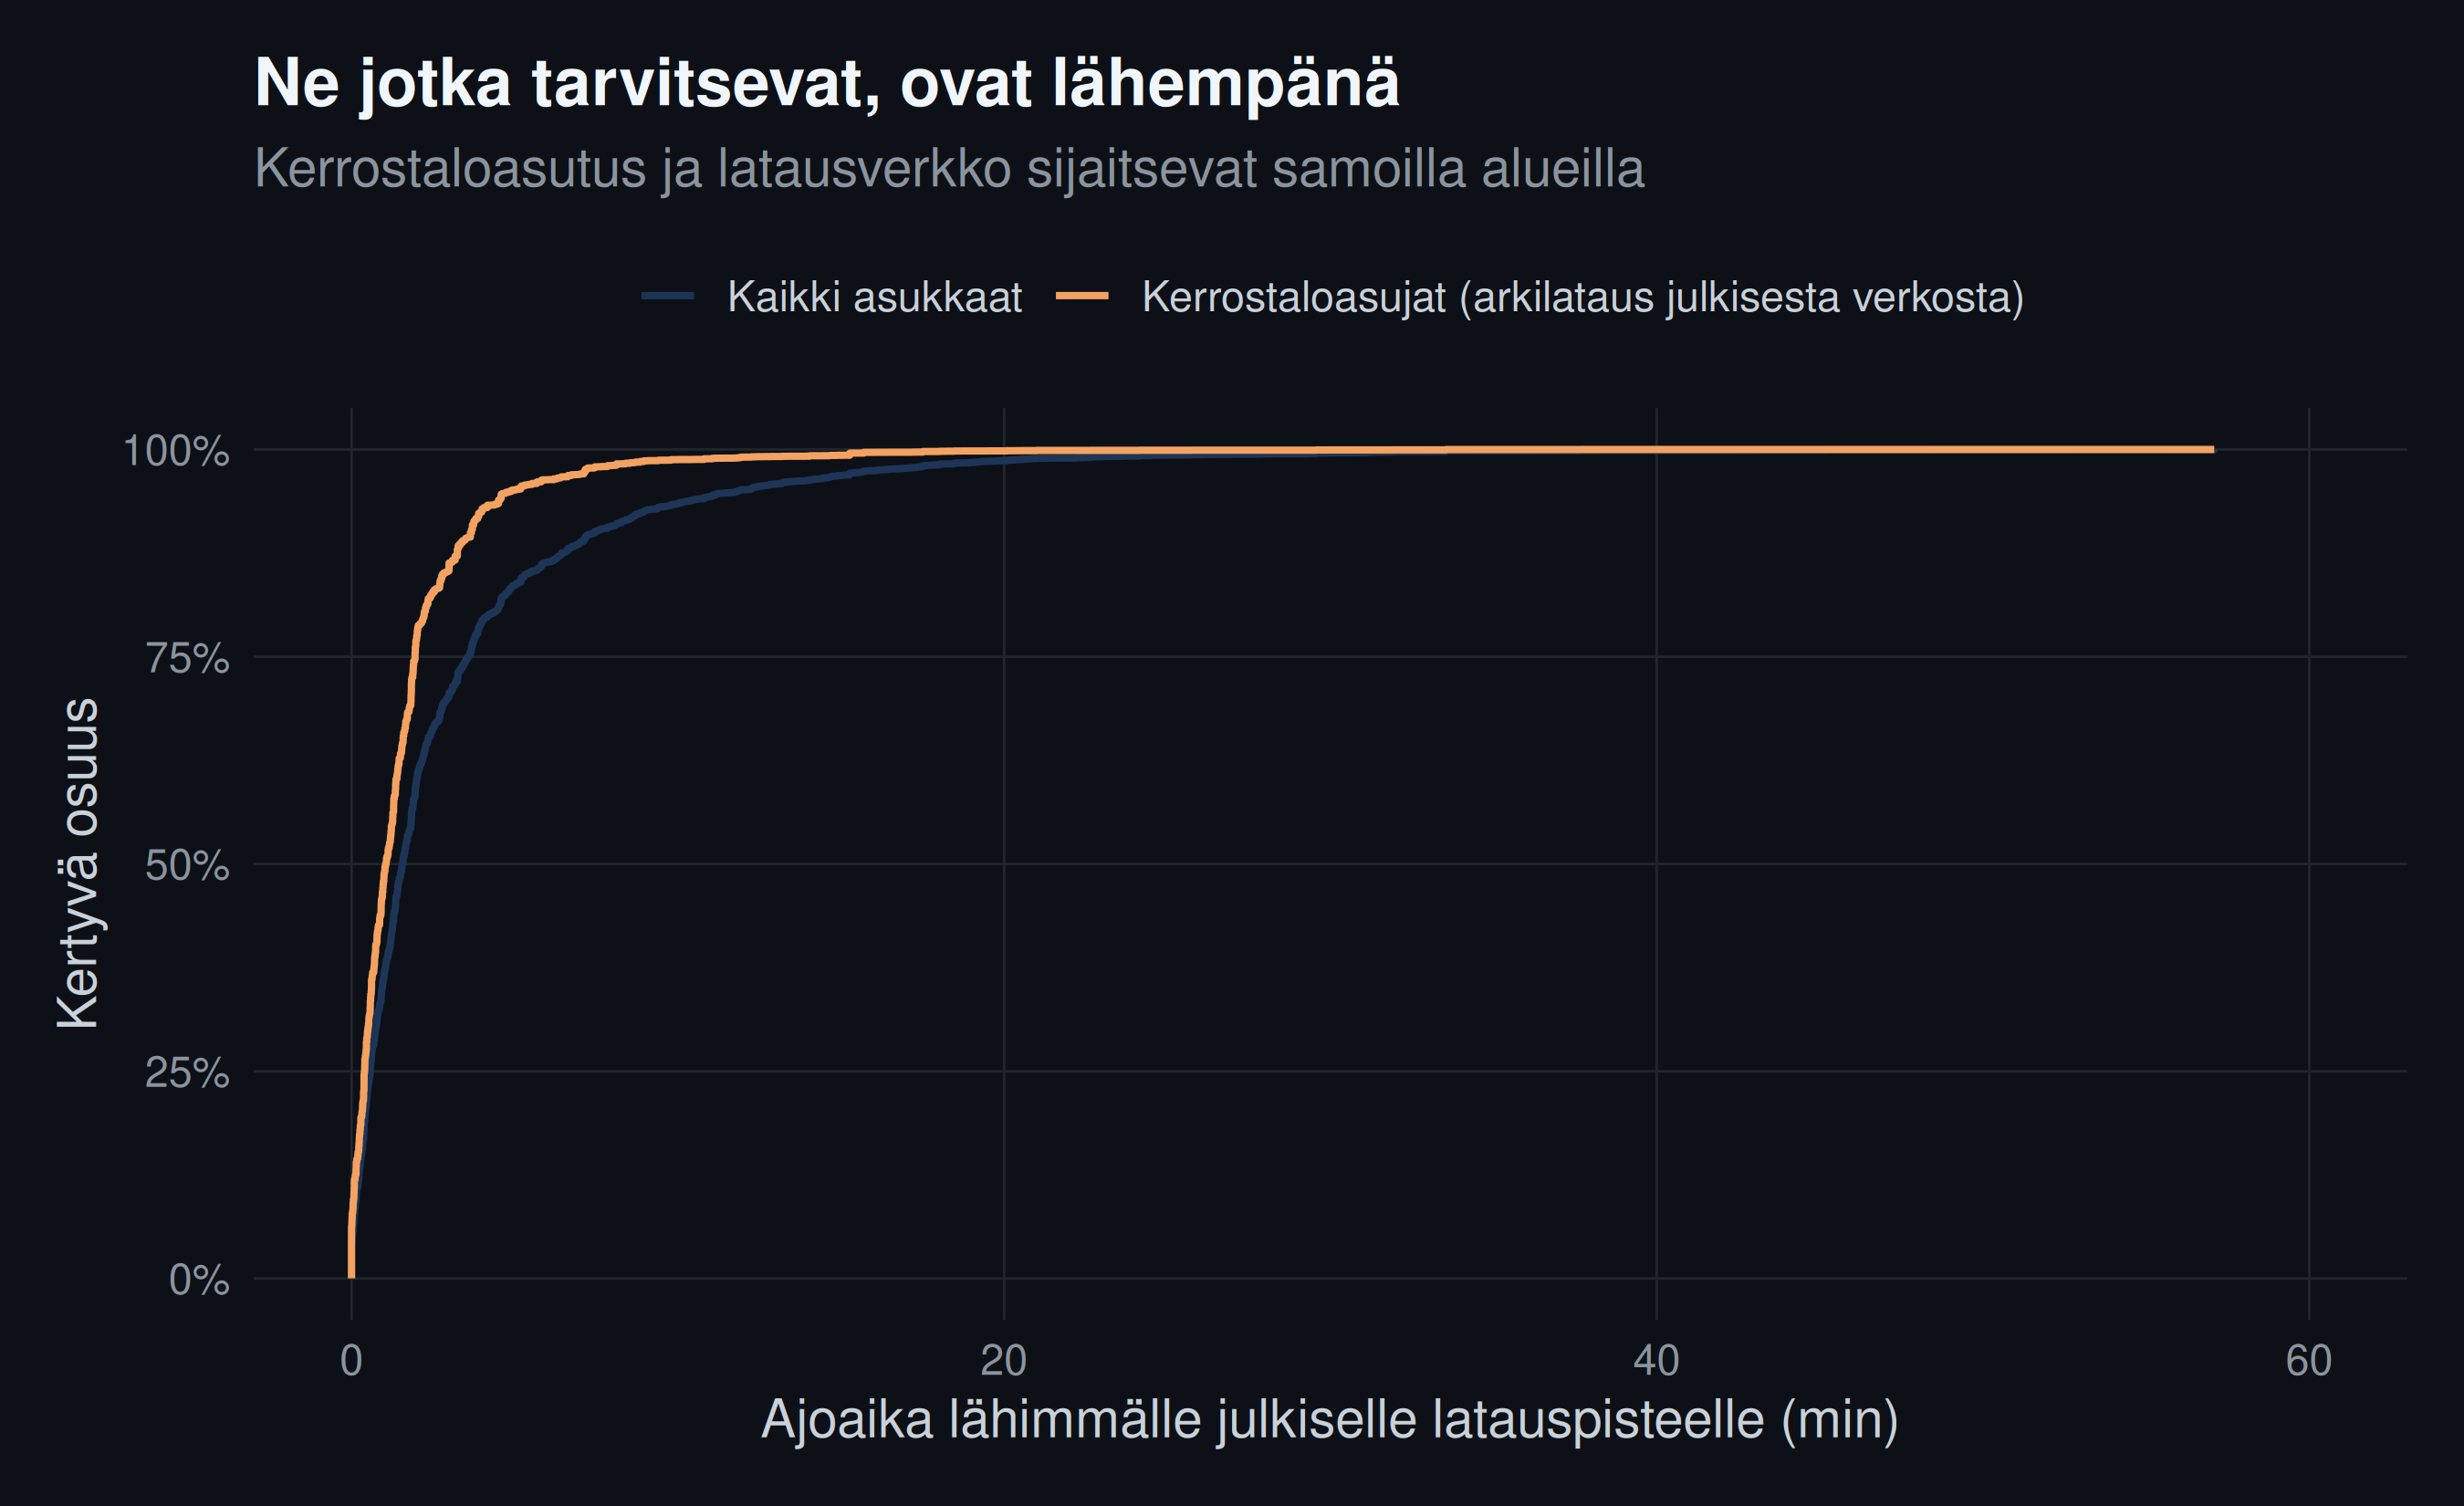
Ero on selvä ja kulkee odotettuun suuntaan. Koko väestöllä painotettuna
mediaanimatka lähimmälle julkiselle latauspisteelle on
`r round(tarve_tunnusluvut$mediaani_kaikki, 1)` minuuttia. Kun painotetaan
kerrostaloasumisen osuudella — eli niillä, jotka julkista verkkoa arjessa
tarvitsevat — luku on `r round(tarve_tunnusluvut$mediaani_tarvitsevat, 1)`
minuuttia.
```{r}
#| label: kuva-tarve
#| fig-cap: "Matka lähimmälle julkiselle latauspisteelle, kahdella eri painotuksella."
alueet |>
select(aika_arki, asukkaat, tarvitsevat) |>
pivot_longer(c(asukkaat, tarvitsevat), names_to = "painotus",
values_to = "paino") |>
mutate(painotus = recode(painotus,
asukkaat = "Kaikki asukkaat",
tarvitsevat = "Kerrostaloasujat (arkilataus julkisesta verkosta)")) |>
arrange(aika_arki) |>
group_by(painotus) |>
mutate(kum = cumsum(paino) / sum(paino)) |>
ungroup() |>
ggplot(aes(aika_arki, kum, colour = painotus)) +
geom_step(linewidth = 0.9) +
scale_x_continuous(limits = c(0, 60)) +
scale_y_continuous(labels = percent) +
scale_colour_manual(values = c(
"Kaikki asukkaat" = unname(pal["navy"]),
"Kerrostaloasujat (arkilataus julkisesta verkosta)" = unname(pal["oranssi"]))) +
labs(x = "Ajoaika lähimmälle julkiselle latauspisteelle (min)",
y = "Kertyvä osuus", colour = NULL,
title = "Ne jotka tarvitsevat, ovat lähempänä",
subtitle = "Kerrostaloasutus ja latausverkko sijaitsevat samoilla alueilla")
```
**Miten kuvaa luetaan.** Vaaka-akselilla on ajoaika lähimmälle julkiselle
latauspisteelle. Pystyakselilta luetaan, kuinka suuri osuus on tuota aikaa
lähempänä.
Tummansininen käyrä painottaa kaikkia asukkaita tasaisesti. Oranssi painottaa
kerrostaloasujia, jotka tarvitsevat julkista verkkoa arjessa.
Oranssi kulkee ylempänä, mikä tarkoittaa että tarvitsijat ovat keskimäärin
lähempänä latauspisteitä. Se on hyvä uutinen ja odotettu: sekä kerrostalot että
latausasemat sijaitsevat taajamissa.
**Mutta se on myös varoitus.** Jos latausverkon riittävyyttä mitataan
painottamatta, tulos näyttää huonommalta kuin tilanne on. Ja jos mittari
näyttää huonommalta kuin tilanne on, siihen reagoidaan rakentamalla lisää
sinne, missä tarvetta on vähiten — koska juuri siellä mittari näyttää
pahimmalta.
```{r}
#| label: kuva-nelikentta
#| fig-cap: "Postinumeroalueet kotilatausmahdollisuuden ja julkisen verkon saavutettavuuden mukaan."
alueet |>
filter(asukkaat >= 200) |>
ggplot(aes(pientalo_osuus, aika_arki)) +
geom_hline(yintercept = 15, colour = "grey50", linetype = 2) +
geom_vline(xintercept = 0.5, colour = "grey50", linetype = 2) +
geom_point(aes(size = asukkaat), colour = pal["turkoosi"], alpha = 0.35) +
scale_x_continuous(labels = percent) +
scale_y_continuous(limits = c(0, 60)) +
scale_size_continuous(range = c(0.5, 6), guide = "none") +
annotate("label", x = 0.18, y = 52,
label = "Kerrostaloja, laturi kaukana\n= kriittisin alue",
fill = "#1a1f2e", colour = pal["punainen"], size = 3, label.size = 0) +
annotate("label", x = 0.82, y = 52,
label = "Pientaloja, laturi kaukana\n= lataa kotona",
fill = "#1a1f2e", colour = "grey70", size = 3, label.size = 0) +
labs(x = "Pientaloasuntojen osuus", y = "Ajoaika lähimmälle latauspisteelle (min)",
title = "Sama etäisyys tarkoittaa eri asiaa eri alueilla",
subtitle = "Pallon koko: alueen asukasluku")
```
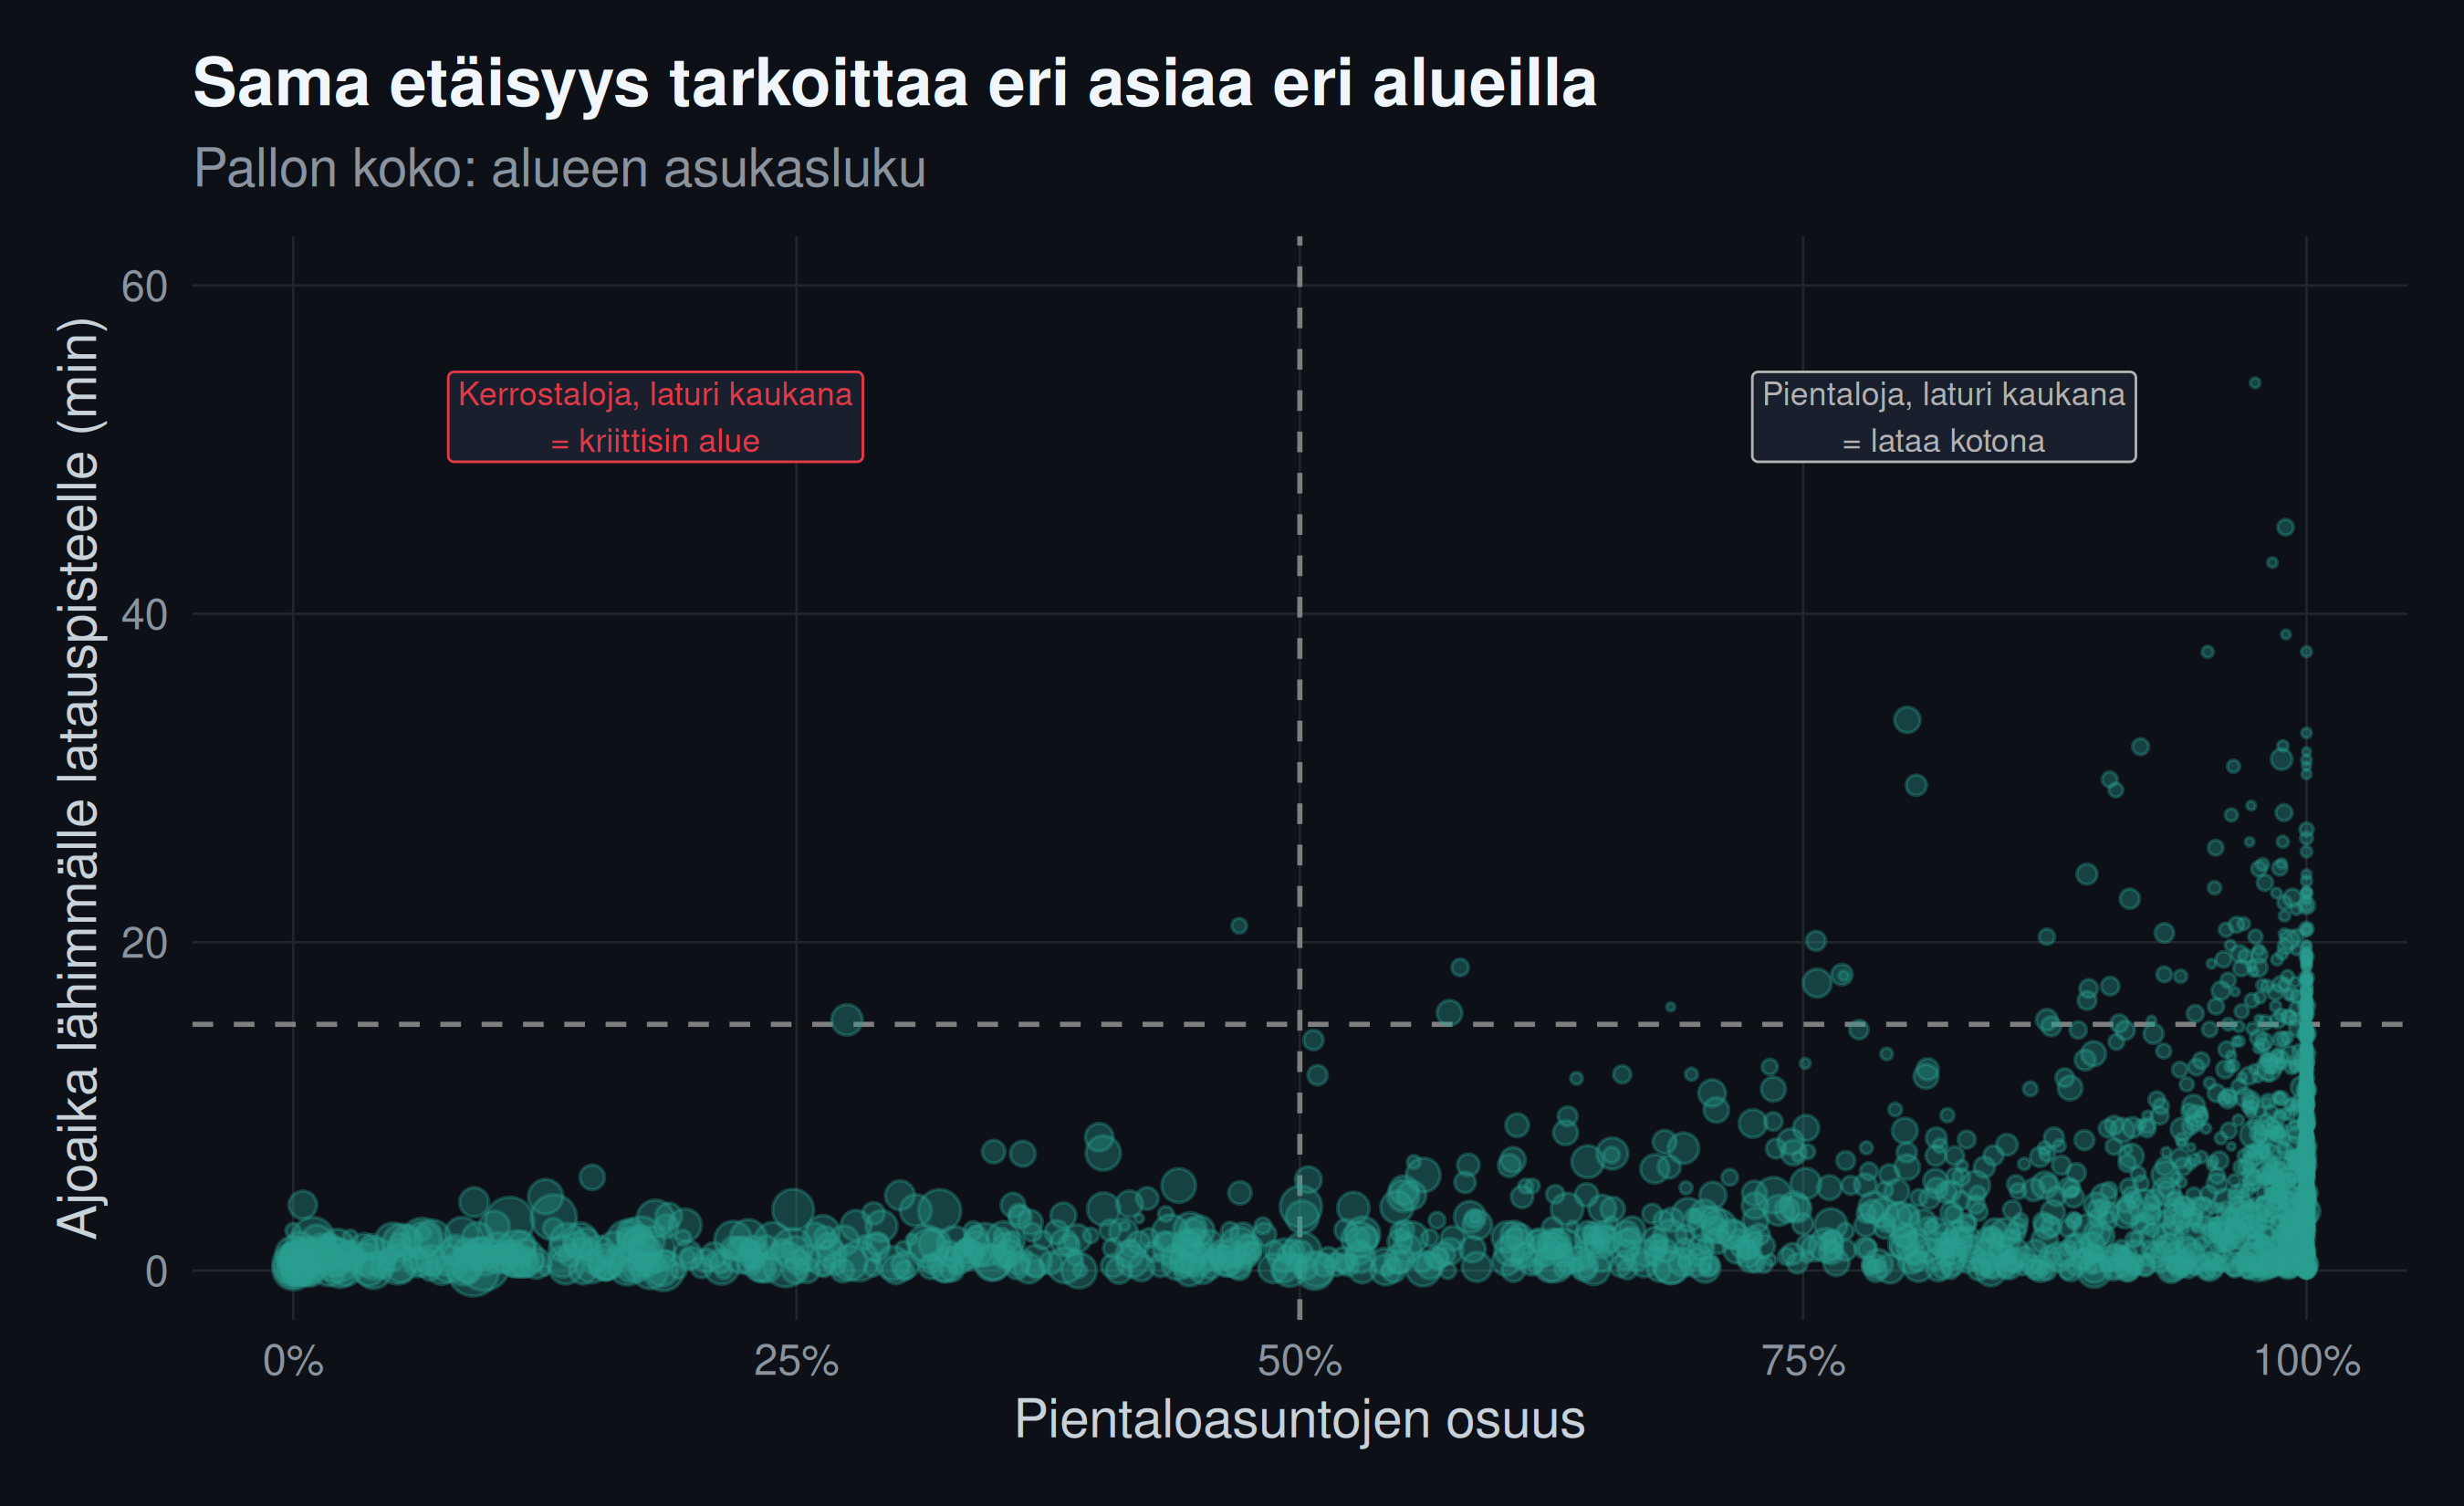
**Miten kuvaa luetaan.** Jokainen pallo on postinumeroalue, ja pallon koko
kertoo asukasluvun.
Vaaka-akselilla on pientaloasuntojen osuus: oikealla asutaan omakotitaloissa,
vasemmalla kerrostaloissa. Pystyakselilla on matka lähimmälle julkiselle
latauspisteelle: ylhäällä laturi on kaukana.
Kuvan neljä lohkoa tarkoittavat eri asioita. Vasen yläkulma on kriittisin: siellä
asutaan kerrostaloissa eikä lähellä ole julkista latauspistettä. Oikea yläkulma
näyttää tilastossa yhtä huonolta, mutta siellä lataaminen tapahtuu kotona eikä
puute juuri tunnu.
Jos latausinvestointeja kohdennetaan pelkän etäisyyden perusteella, ne
jakautuvat molempiin yläkulmiin. Vain toisessa niistä on todellinen tarve.
## Onko latausverkko tulosidonnainen?
Paavo sisältää alueiden tulotason, mikä avaa kysymyksen jota ei Suomessa
tietääkseni ole julkisesti laskettu: onko latausverkon saavutettavuus
sidoksissa alueen varallisuuteen?
```{r}
#| label: tulot
#| echo: true
tulo_data <- alueet |>
  filter(!is.na(mediaanitulot), mediaanitulot > 0, asukkaat >= 200)

# Järjestyskorrelaatio, koska sekä tulot että ajoajat ovat vinoja
kor_tulot <- cor.test(tulo_data$mediaanitulot, tulo_data$aika_arki,
                      method = "spearman", exact = FALSE)

# Tuloviidennekset ja niiden saavutettavuus
viidennekset <- tulo_data |>
  mutate(tuloluokka = cut(mediaanitulot,
                          breaks = quantile(mediaanitulot, seq(0, 1, 0.2)),
                          labels = c("Pienituloisin viidennes", "2.", "3.", "4.",
                                     "Suurituloisin viidennes"),
                          include.lowest = TRUE))

kw_tulot <- kruskal.test(aika_arki ~ tuloluokka, data = viidennekset)
n_tot <- nrow(viidennekset)
epsilon2_tulot <- unname(kw_tulot$statistic) / ((n_tot^2 - 1) / (n_tot + 1))

viidennes_yhteenveto <- viidennekset |>
  group_by(tuloluokka) |>
  summarise(
    mediaani_aika = median(aika_arki),
    pientalo = weighted.mean(pientalo_osuus, asukkaat, na.rm = TRUE),
    .groups = "drop"
  )
```
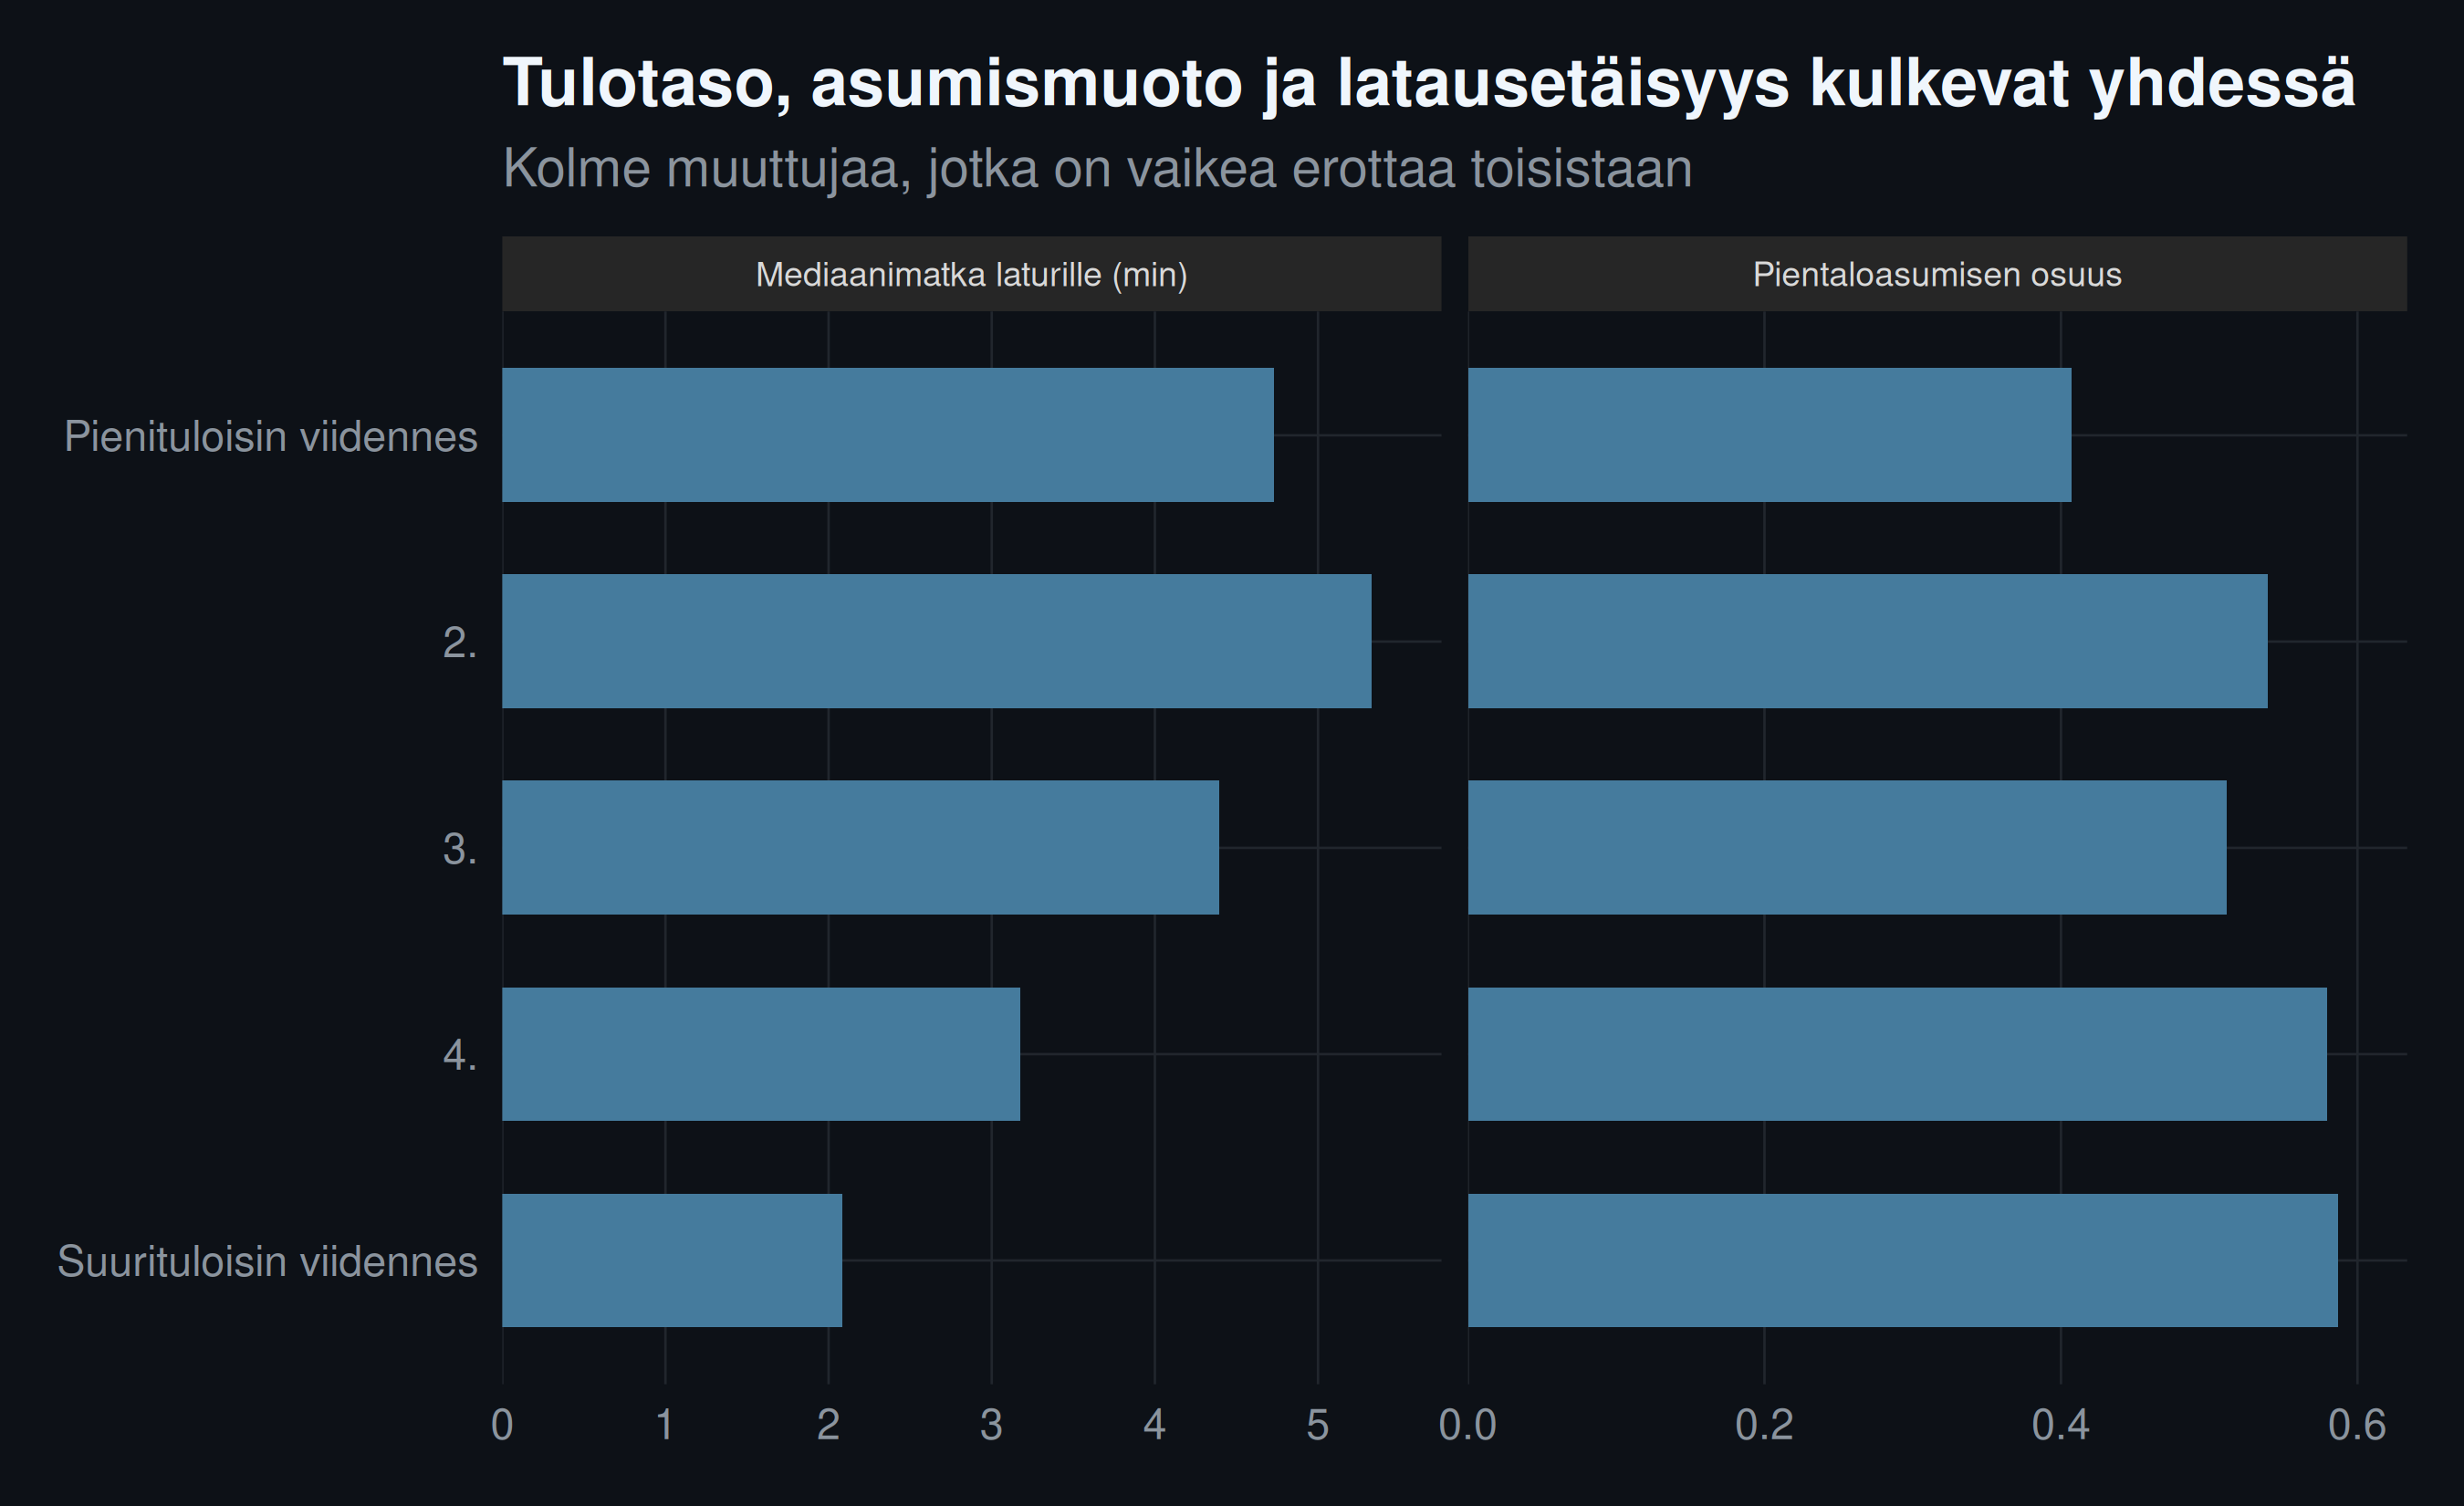
Tulotason ja latausetäisyyden järjestyskorrelaatio on
`r format(round(unname(kor_tulot$estimate), 3), decimal.mark = ",")`.
Tuloviidennesten välinen ero on Kruskal–Wallis-testillä p-arvoltaan
`r if (kw_tulot$p.value < 0.001) "alle 0,001" else format(round(kw_tulot$p.value, 4), decimal.mark = ",")`
ja efektikooltaan `r format(round(epsilon2_tulot, 3), decimal.mark = ",")`.
```{r}
#| label: kuva-tulot
#| fig-cap: "Latausetäisyys ja pientaloasuminen tuloviidenneksittäin."
viidennes_yhteenveto |>
select(tuloluokka, `Mediaanimatka laturille (min)` = mediaani_aika,
`Pientaloasumisen osuus` = pientalo) |>
pivot_longer(-tuloluokka) |>
ggplot(aes(value, fct_rev(tuloluokka))) +
geom_col(fill = pal["sininen"], width = 0.65) +
facet_wrap(~name, scales = "free_x") +
scale_x_continuous(expand = expansion(mult = c(0, 0.08))) +
labs(x = NULL, y = NULL,
title = "Tulotaso, asumismuoto ja latausetäisyys kulkevat yhdessä",
subtitle = "Kolme muuttujaa, jotka on vaikea erottaa toisistaan")
```
**Miksi tulosta ei pidä tulkita suoraan.** Kuva näyttää kolmen muuttujan
yhteyden, mutta se ei kerro mikä niistä vaikuttaa mihin. Suurituloisilla
alueilla asutaan useammin pientaloissa, pientaloalueet ovat harvemmin
rakennettuja, ja harvaan rakennetuilla alueilla on vähemmän julkisia
latauspisteitä.
Tämä on sekoittavan tekijän klassinen tapaus. Jos raportoisin pelkästään, että
suurituloisilla alueilla on pidempi matka laturille, se kuulostaisi
eriarvoisuudelta — vaikka kyse on siitä, että he lataavat kotona eivätkä
tarvitse julkista verkkoa.
Oikea kysymys on toinen: onko tulotasolla yhteyttä latausetäisyyteen **kun
asumismuoto pidetään vakiona**? Sitä ei voi lukea yllä olevasta kuvasta.
```{r}
#| label: osittainen
#| echo: true
# Osittaiskorrelaatio: tulojen ja latausetäisyyden yhteys sen jälkeen
# kun pientaloasumisen vaikutus on poistettu molemmista.
osittainen <- tulo_data |>
  filter(!is.na(pientalo_osuus)) |>
  mutate(
    j_tulot = rank(mediaanitulot),
    j_aika = rank(aika_arki),
    j_pientalo = rank(pientalo_osuus)
  )

res_tulot <- residuals(lm(j_tulot ~ j_pientalo, data = osittainen))
res_aika  <- residuals(lm(j_aika ~ j_pientalo, data = osittainen))

kor_osittainen <- cor.test(res_tulot, res_aika)
```
Osittaiskorrelaatio on
`r format(round(unname(kor_osittainen$estimate), 3), decimal.mark = ",")`.
**Mitä osittaiskorrelaatio tarkoittaa.** Se kertoo kahden asian yhteyden sen
jälkeen, kun kolmannen vaikutus on poistettu molemmista. Käytännössä: jos
verrataan keskenään vain samanlaisia asuinalueita, näkyykö tulotason vaikutus
enää?
Menetelmä on yksinkertainen. Ensin selitetään sekä tulot että latausetäisyys
asumismuodolla ja otetaan talteen se osa, jota asumismuoto ei selittänyt.
Sitten katsotaan, korreloivatko nuo selittämättömät osat keskenään.
Jos osittaiskorrelaatio on selvästi pienempi kuin alkuperäinen, yhteys selittyi
suurelta osin asumismuodolla. Jos se säilyy, tulotasolla on itsenäinen yhteys —
ja se olisi kiinnostava tulos, koska sitä ei voi selittää rakennuskannalla.
::: {.callout-note}
## Faktalaatikko: kuinka suuri osa latauksista tapahtuu kotona?
Latauskäyttäytymistä koskevassa tutkimuskirjallisuudessa toistuu havainto, että
valtaosa sähköauton latauksista tapahtuu kotona tai työpaikalla, ei julkisessa
verkossa. Osuudet vaihtelevat maittain ja tutkimuksittain, mutta suuruusluokka
on johdonmukainen: julkinen pikalataus on vähemmistö kaikista latauskerroista,
vaikka se on näkyvin osa infrastruktuuria.
*Transportation Research Part D* -lehdessä julkaistussa katsauksessa
huomautetaan, että latausinfran sijoittelua mallintavat tutkimukset nojaavat
usein yksinkertaistaviin oletuksiin latauskäyttäytymisestä ja jättävät koti- ja
työpaikkalatauksen huomiotta. Kyseessä on siis tunnistettu puute
tutkimuskirjallisuudessa itsessään, ei vain julkisessa keskustelussa.
**Mitä tästä seuraa.** Julkisen latausverkon mitoittaminen sähköautojen
kokonaismäärän perusteella yliarvioi tarvetta siellä, missä kotilataus on
mahdollista. Se ei tarkoita että julkista verkkoa tarvittaisiin vähemmän — se
tarkoittaa että sitä tarvitaan eri paikoissa kuin autokanta antaa ymmärtää.
**Ja mitä siitä seuraa politiikalle.** Taloyhtiöiden latausinfratuki ja julkisen
verkon rakentamistuki ovat osittain vaihtoehtoisia keinoja samaan ongelmaan.
Kumpi on tehokkaampi, riippuu alueen rakennuskannasta — ja se on laskettavissa
etukäteen postinumerotasolla.
:::
## Vaihtoehtoiset skenaariot
```{r}
#| label: counterfactual
#| echo: true
kok_pisteet <- nrow(kaikki_pisteet)

# Kolme kohdennusperiaatetta, kaikissa sama määrä uusia pisteitä.
# Kysymys ei ole määrästä vaan siitä, mihin ne osoitetaan.
uusia <- 500

kohdennus <- alueet |>
  filter(asukkaat >= 200, !is.na(pientalo_osuus)) |>
  mutate(
    # A: väkiluvun mukaan
    a_paino = asukkaat,
    # B: etäisyyden mukaan (huonoiten saavutettavat ensin)
    b_paino = asukkaat * aika_arki,
    # C: tarpeen mukaan (kerrostaloasujat, joilla on pitkä matka)
    c_paino = tarvitsevat * aika_arki
  ) |>
  mutate(across(ends_with("_paino"), \(p) uusia * p / sum(p, na.rm = TRUE),
                .names = "{.col}_pisteet"))

vertailu <- kohdennus |>
  summarise(
    across(ends_with("_pisteet"), \(p) {
      # Kuinka suuri osa uusista pisteistä menee alueille, joilla
      # kotilataus on jo mahdollista valtaosalle
      sum(p[pientalo_osuus > 0.7], na.rm = TRUE) / sum(p, na.rm = TRUE)
    })
  ) |>
  pivot_longer(everything(), names_to = "periaate",
               values_to = "osuus_pientaloalueille") |>
  mutate(periaate = recode(periaate,
    a_paino_pisteet = "A: väkiluvun mukaan",
    b_paino_pisteet = "B: etäisyyden mukaan",
    c_paino_pisteet = "C: tarpeen mukaan"))

stopifnot(
  "Osuudet eivät ole välillä 0–1" =
    all(between(vertailu$osuus_pientaloalueille, 0, 1))
)
```
```{r}
#| label: kuva-kohdennus
#| fig-cap: "Kuinka suuri osa uusista latauspisteistä päätyisi alueille, joilla kotilataus on jo mahdollista."
vertailu |>
mutate(periaate = fct_reorder(periaate, osuus_pientaloalueille)) |>
ggplot(aes(osuus_pientaloalueille, periaate)) +
geom_col(fill = pal["oranssi"], width = 0.6) +
geom_text(aes(label = percent(osuus_pientaloalueille, accuracy = 0.1)),
hjust = -0.15, colour = "grey85", size = 3.6) +
scale_x_continuous(labels = percent, limits = c(0, NA),
expand = expansion(mult = c(0, 0.15))) +
labs(x = "Osuus uusista pisteistä pientalovaltaisille alueille", y = NULL,
title = "Kohdennusperiaate ratkaisee, minne raha menee",
subtitle = "Sama määrä latauspisteitä, kolme eri jakoperustetta")
```
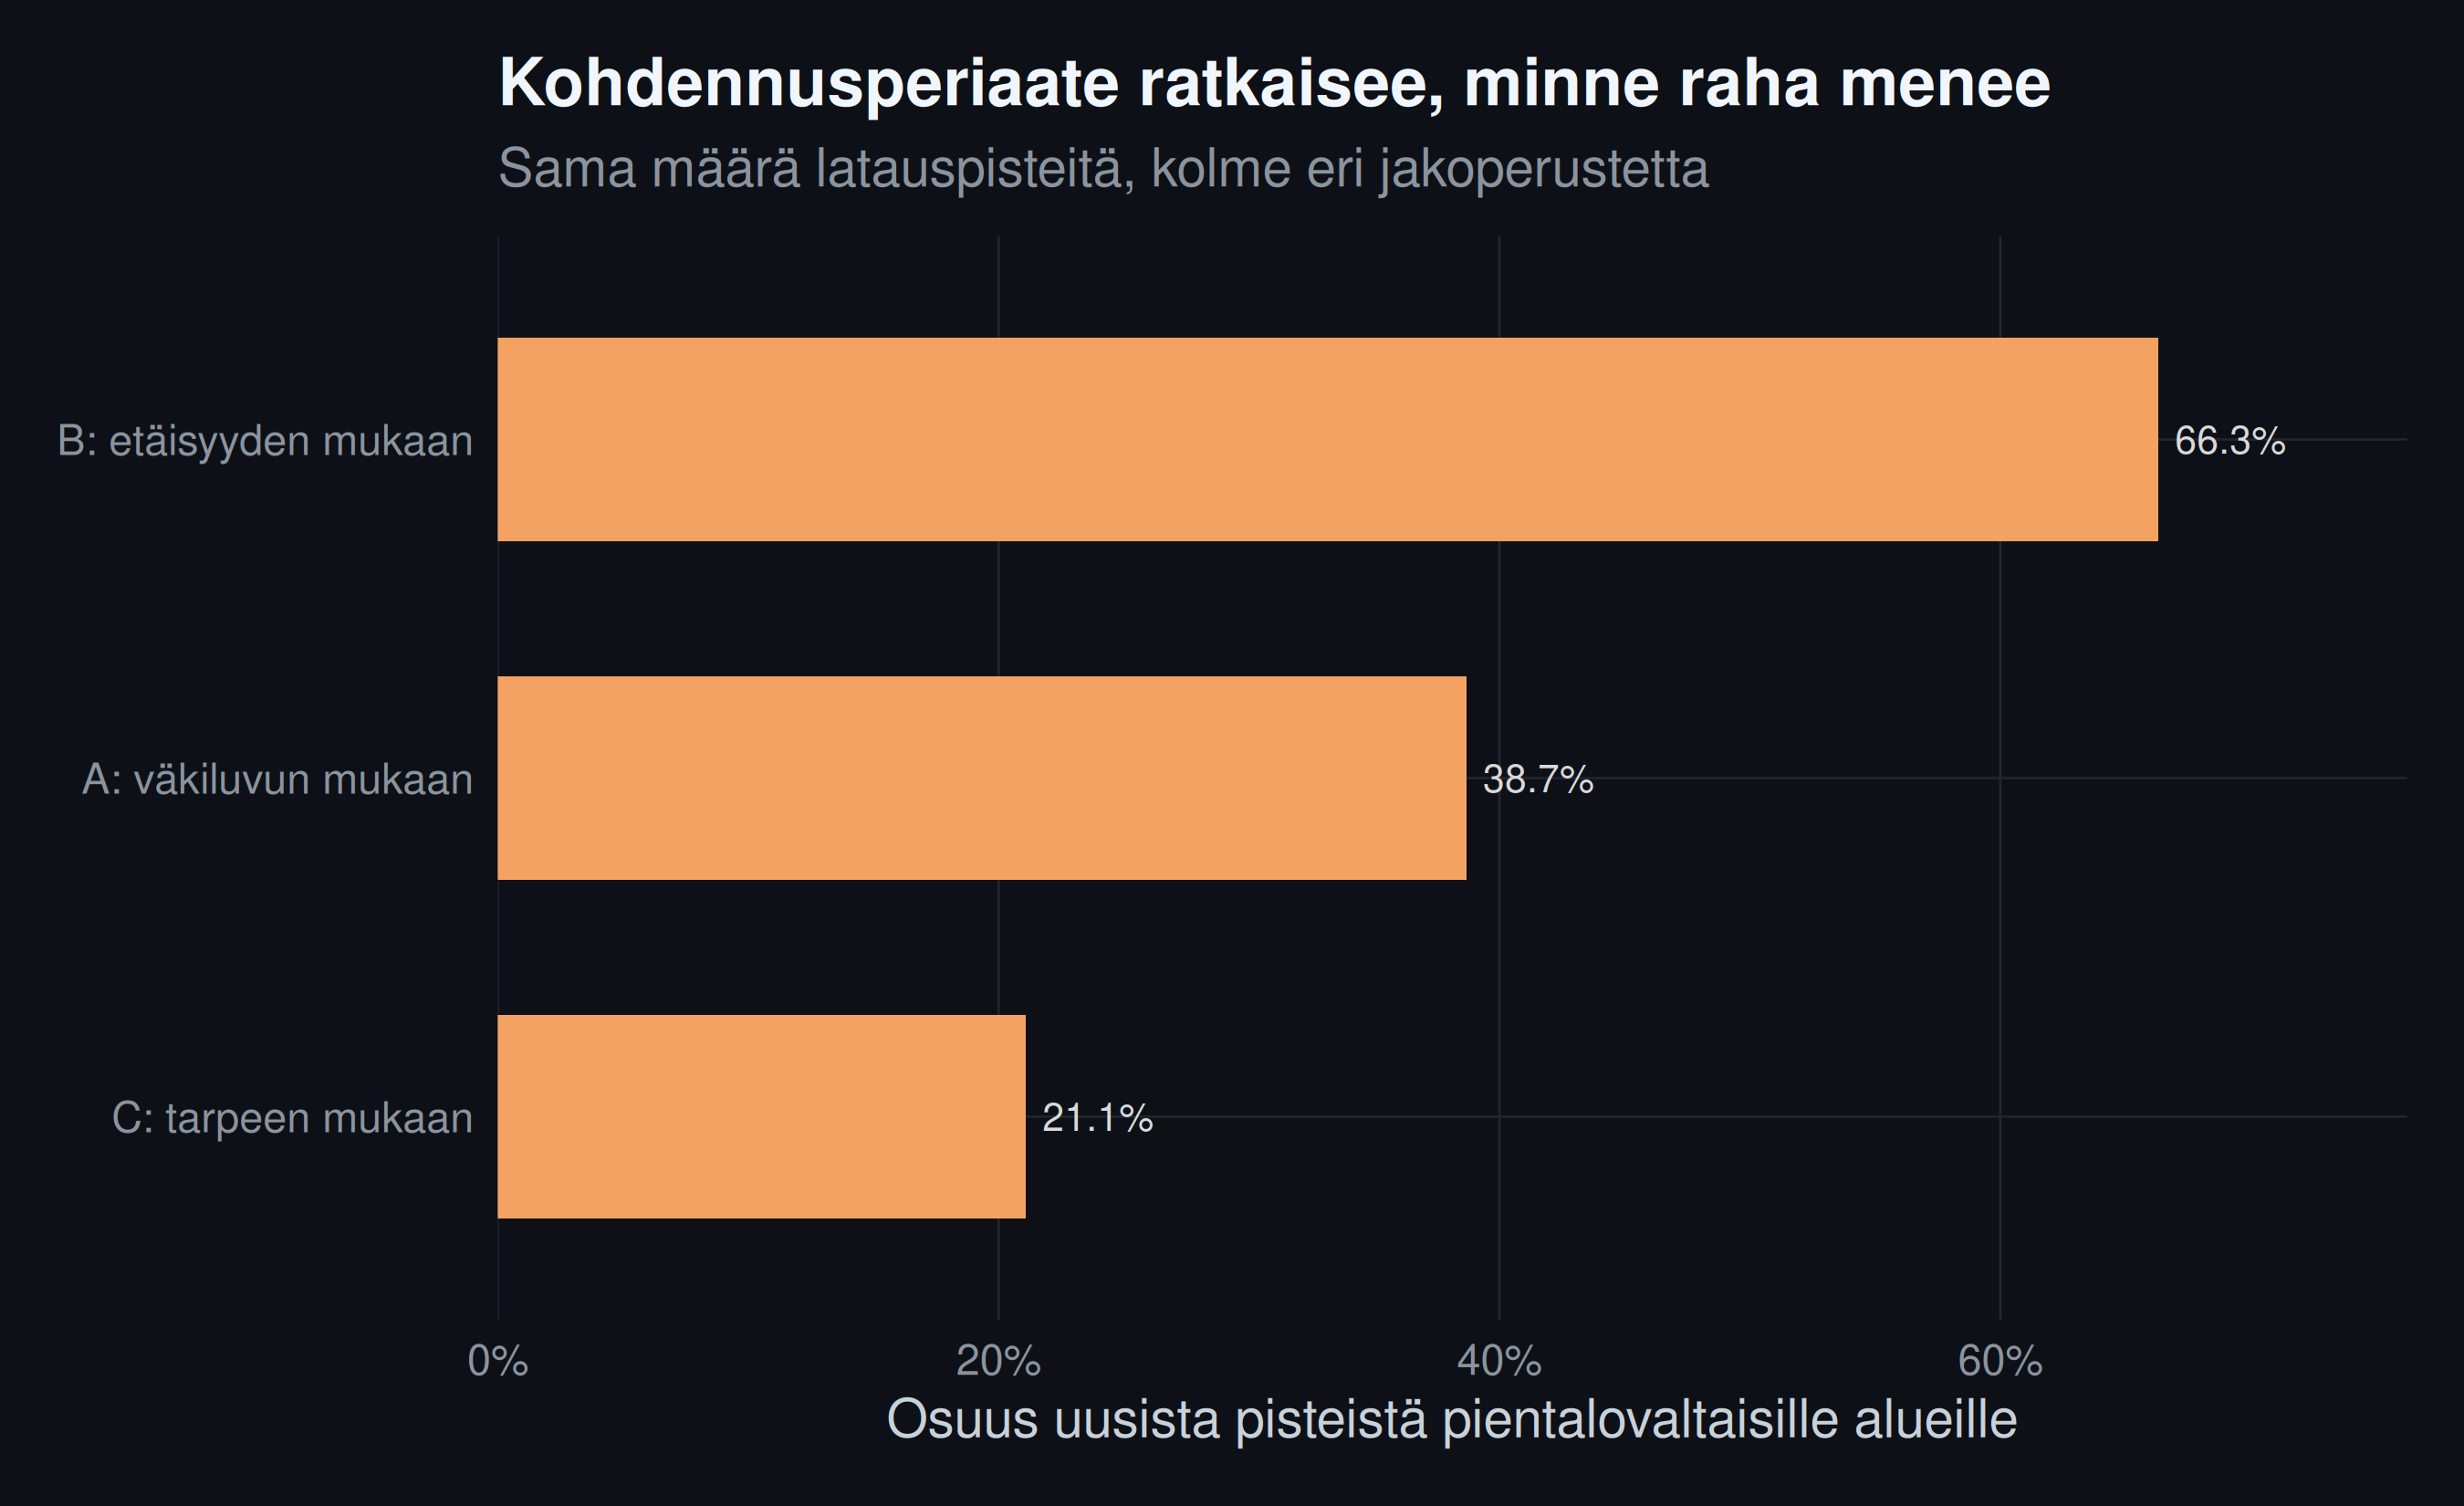
Kaikissa kolmessa skenaariossa rakennetaan **täsmälleen sama määrä**
latauspisteitä. Ainoa ero on jakoperuste.
Periaate B — rakennetaan sinne, missä matka on pisin — vaikuttaa
oikeudenmukaiselta. Käytännössä se ohjaa merkittävän osan investoinnista
alueille, joilla asukkaat lataavat autonsa kotona eivätkä käytä julkista
verkkoa juuri lainkaan.
Periaate C ottaa kotilatausmahdollisuuden huomioon ja kohdentaa sinne, missä
julkinen verkko on ainoa vaihtoehto. Se ei ole automaattisesti oikea valinta —
harvaan asutun alueen matkailijat tarvitsevat myös latureita — mutta se on
eri valinta, ja ero on nyt mitattavissa.
## Mitä jää käteen
**Suhdeluku "autoja per pistoke" olettaa liikaa.** Se kohtelee omakotitalossa
asuvaa ja kerrostaloasujaa samalla tavalla, vaikka heidän tarpeensa eroaa
täysin.
**Suomi asuu kahdella tavalla.** Pientalo-osuuden jakauma on kaksihuippuinen,
joten kotilatausmahdollisuus jakautuu jyrkästi eikä tasaisesti.
**Tarvitsijat ovat lähempänä latureita kuin väestö keskimäärin.** Se on hyvä
uutinen, mutta se tarkoittaa myös että painottamaton mittari näyttää huonommalta
kuin tilanne on — ja ohjaa investoinnit väärään suuntaan.
**Sekoittavat tekijät on erotettava.** Tulotaso, asumismuoto ja latausetäisyys
kulkevat yhdessä. Ilman osittaista tarkastelua tuloksesta voisi lukea
eriarvoisuutta, jota siinä ei ole — tai jättää huomaamatta sellaista, jota
siinä on.
Seuraavassa osassa palaan verkoston kestävyyteen. Tähän asti olen kysynyt, missä
latausasemat ovat ja kenelle ne riittävät. Seuraavaksi kysyn, mitä tapahtuu kun
ne katoavat.
---
## Mitä tästä on hyötyä yrityksellesi
**Kysy, kuka mittarissasi on nimittäjänä.** Tämän osan koko idea on siinä, että
"autoja per latauspiste" laskee mukaan autoja, jotka eivät latauspistettä
tarvitse. Sama virhe on lähes jokaisessa kapasiteettimittarissa: asiakkaita per
palveluneuvoja laskee mukaan asiakkaat, jotka eivät koskaan soita; käyttäjiä per
lisenssi laskee mukaan käyttäjät, jotka eivät kirjaudu sisään. Tarkista
nimittäjä ennen kuin mitoitat sen perusteella.
**Segmentoi tarpeen, älä ominaisuuden mukaan.** Asiakkaita segmentoidaan
tavallisesti sen mukaan mitä he ovat — toimiala, koko, sijainti. Hyödyllisempi
jako on se, mitä he tarvitsevat. Tässä osassa asuinalueen rakennuskanta
osoittautui paremmaksi ennustajaksi kuin sijainti tai tulotaso.
**Erota sekoittavat tekijät ennen kuin raportoit yhteyden.** Osittaiskorrelaatio
on muutaman rivin laskutoimitus ja estää nolaavan virheen: raportoimasta
yhteyttä, joka selittyy kolmannella tekijällä. Jos raportissa lukee "A ja B
korreloivat", ensimmäinen kysymys on aina mikä C on.
**Käytä hienojakoisinta saatavilla olevaa aluejakoa.** Kuntataso peittää
kunnan sisäiset erot, ja ne ovat usein suurempia kuin kuntien väliset.
Postinumerotaso on Suomessa avointa dataa ja kymmenkertainen tarkkuus. Sama
pätee organisaatioon: konsernitason luku peittää sen, että yksi yksikkö
vetää kaikkia muita.
**Ja kerro, kun paras saatavilla oleva muuttuja ei ole se jota haluaisit
mitata.** Käytin pientaloasumista kotilatausmahdollisuuden mittarina, koska
parempaa ei ole. Se on approksimaatio ja sanon sen ääneen. Analyysi, joka
esittää approksimaation mittauksena, on epärehellinen; analyysi, joka jättää
laskematta koska täydellistä muuttujaa ei ole, on hyödytön.
Jos organisaatiossasi mitoitetaan kapasiteettia mittarilla, jonka nimittäjää ei
ole kyseenalaistettu, tai jos aluevertailuja tehdään kuntatasolla vaikka
tarkempaa dataa on saatavilla, siinä on työtä odottamassa. Teen tätä
vuokrattavana Head of Datana ja projektikohtaisesti — hinnasto ja yhteystiedot
löytyvät [sivustolta](https://kristianvepsalainen.com).
---
*Aineistot: Tilastokeskuksen Paavo-postinumeroalueittainen avoin tieto,
OpenStreetMap (© OpenStreetMap-osallistujat, ODbL 1.0), Fintraffic AFIR /
Digitraffic. Koodi on kokonaisuudessaan tässä postauksessa. Maailma on jakauma.*