Vesa Linja-aho esitti LinkedInissä haasteen: hän oli saanut liikennevirhemaksun Kehä I:n Leppäsolmun kamerasta, kaivanut itsensä esiin LAM-raakadatasta ja ehdotti, että joku katsoisi muutaman viikon päästä, näkyykö valvonnan aloittaminen keskinopeuksissa.
Otin haasteen vastaan. Mutta en katso keskinopeuksia, koska keskinopeus on tähän kysymykseen väärä työkalu — ja osoitan kohta miksi.
Vastaus on, että jokin muuttui Kehä I:llä tiistaina 25. elokuuta 2026, ja data osoittaa päivän niin tarkasti, että sattuman todennäköisyys on yksi biljoonasta. Mutta matka siihen vastaukseen kulkee kolmen ansan läpi, joista jokainen olisi tuottanut eri — ja väärän — luvun.
Tämä postaus näyttää kaikki kolme.
Mitä LAM-data on
Liikenneviraston LAM-pisteet (liikenteen automaattinen mittaus) ovat tienpintaan upotettuja induktiosilmukoita. Kun auto ajaa silmukan yli, sen metallimassa muuttaa silmukan magneettikenttää. Kahdella peräkkäisellä silmukalla laite laskee ajoneuvon nopeuden ja pituuden.
Jokaisesta ohituksesta tallentuu rivi: kellonaika sadasosasekunnin tarkkuudella, kaista, suunta, nopeus, ajoneuvon pituus, ajoneuvoluokka ja aikaväli edelliseen ajoneuvoon. Suomessa on yli 450 asemaa, ja data on vapaasti ladattavissa päivä- ja pistekohtaisina CSV-tiedostoina Fintrafficin Digitraffic-palvelusta.
Tämä on poikkeuksellista. Useimmissa maissa vastaava aineisto on viranomaisen sisäistä. Suomessa kuka tahansa voi ladata jokaisen moottoritien jokaisen auton nopeuden.
Tätä analyysiä varten latasin 22 mittauspisteen tiedot 328 päivältä — koko huhti–syyskuun sekä vuodelta 2026 että 2025. Kymmenen pistettä on Kehä I:llä, loput vertailukohdiksi muilta pääkaupunkiseudun pääväyliltä. Aineistossa on noin 349 miljoonaa henkilöauton ohitusta.
NoteMistä data tulee ja miten sen saa itse
Raakadata haetaan osoitteesta https://tie.digitraffic.fi/api/tms/v1/history/raw/lamraw_[piste]_[vuosi]_[päivä].csv, jossa vuosi on kaksinumeroinen ja päivä on järjestysnumero vuoden alusta. Esimerkiksi Leppäsolmun piste 116 syyskuun 4. päivältä 2026 on lamraw_116_26_247.csv. Raakadataa on saatavilla joulukuusta 2021 alkaen. Aineisto on lisensoitu CC BY 4.0, lähde Fintraffic / Digitraffic.
Miksi keskinopeus on väärä mittari
Tässä on koko postauksen tärkein ajatus, ja se pätee paljon laajemmin kuin liikenteeseen.
Nopeusvalvonta ei vaikuta kaikkiin kuljettajiin. Se vaikuttaa niihin, jotka ajoivat ylinopeutta. Jos sata autoa ajaa rajoituksen mukaan ja kymmenen ajaa reilusti yli, ja valvonta saa ne kymmenen hidastamaan, keskinopeus liikkuu vain vähän — mutta sakotettavien määrä voi puolittua.
Keskiarvo on yksi luku. Se ei kerro, miten havainnot jakautuvat sen ympärille. Maailma on jakauma, ja politiikkatoimen vaikutus näkyy melkein aina jakauman jossakin osassa, ei sen keskikohdassa.
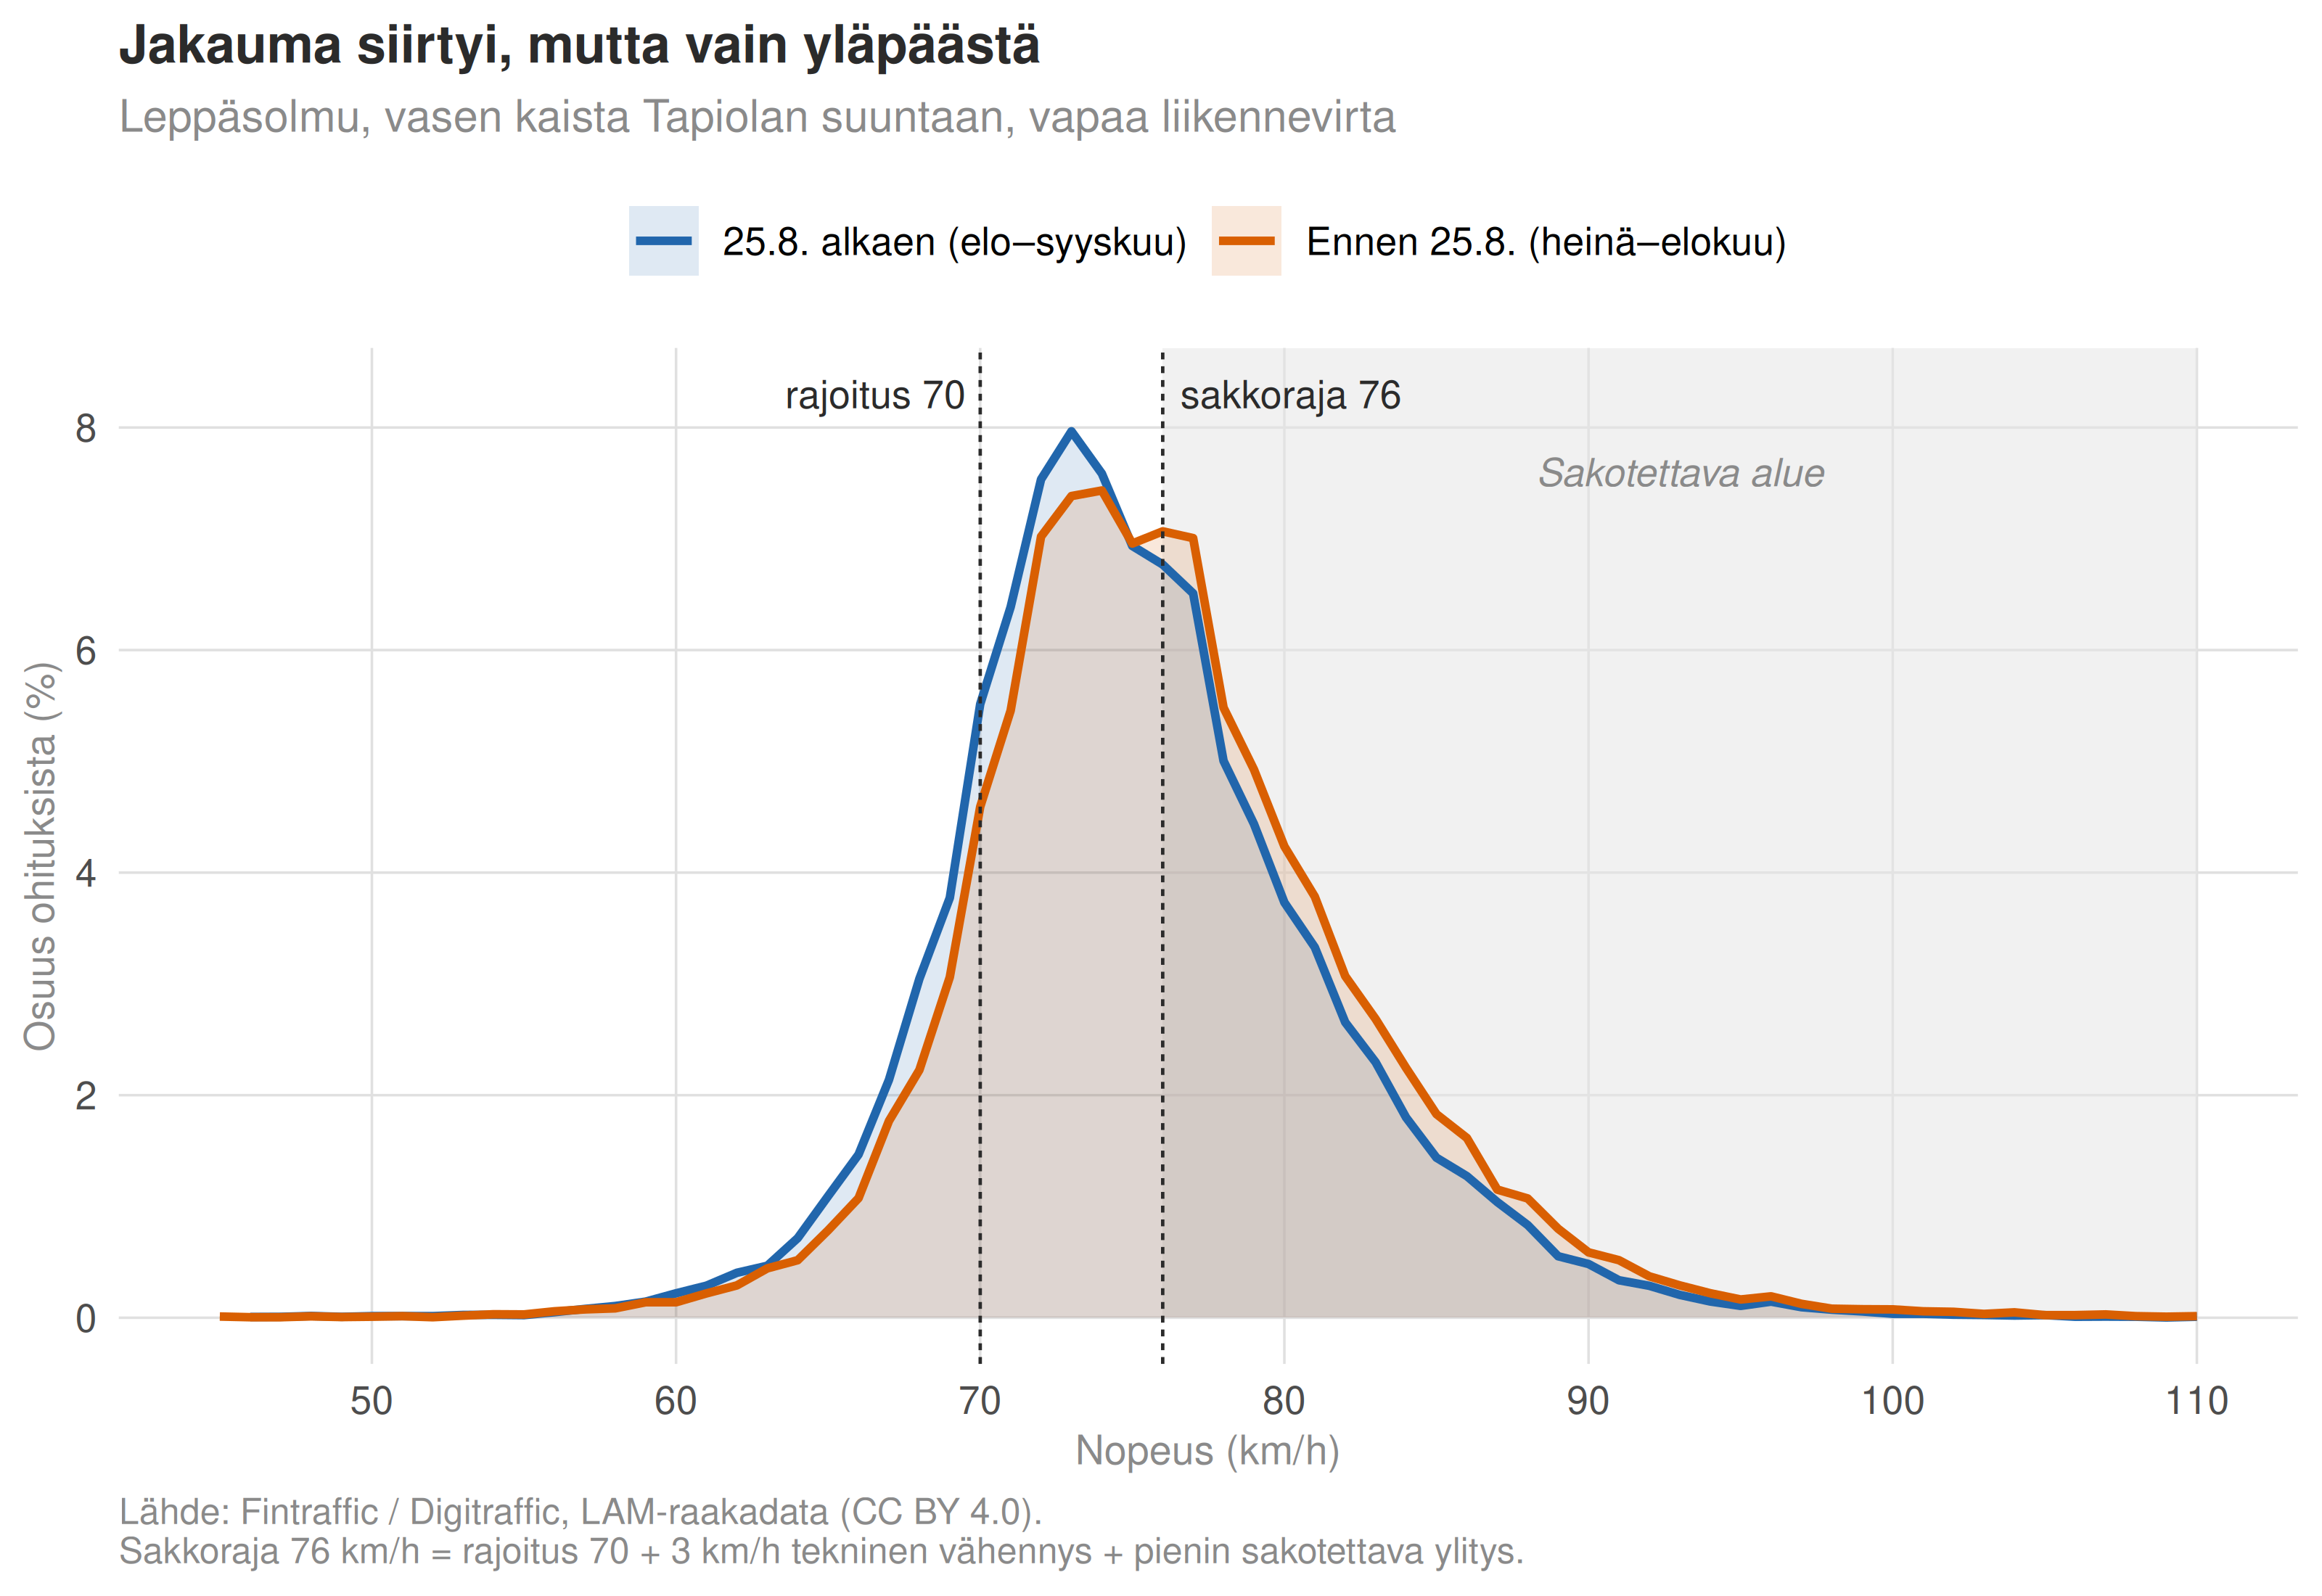
Katsotaan Leppäsolmun pistettä 116 — sitä samaa, josta Vesa löysi oman autonsa. Alla on sen vasemmanpuoleisimman kaistan nopeusjakauma ennen ja jälkeen elokuun 25. päivän.
Katso käyrien vasenta puolta: ne ovat lähes päällekkäin. Ne kuljettajat, jotka ajoivat 55–70 km/h, ajavat edelleen samaa vauhtia. Heihin ei vaikutettu, koska heihin ei ollut tarvettakaan vaikuttaa.
Katso nyt oikeaa puolta, harmaata aluetta. Siellä käyrät eroavat selvästi. Sakotettavalla alueella (76 km/h ja yli) olevien osuus putosi 50.1 prosentista 43.9 prosenttiin.
Keskinopeus tällä kaistalla muuttui samaan aikaan vain noin puolitoista kilometriä tunnissa. Jos olisin raportoinut vain keskinopeuden, olisin sanonut “pieni muutos”. Jakauma kertoo, että muutos osui täsmälleen sinne, minne valvonnan pitikin osua.
TipKäytännön sovellus: sama ilmiö muualla
Tämä ei ole liikennejuttu. Se on mittarijuttu.
Jos mittaat asiakastyytyväisyyden keskiarvoa, et näe sitä että tyytymättömien häntä paksunee. Jos mittaat keskimääräistä vasteaikaa, et näe että pahimmat tapaukset pitenevät. Jos mittaat keskipalkkaa, et näe palkkahaitarin leviämistä. Toimenpide vaikuttaa melkein aina johonkin jakauman osaan, ja keskiarvo on juuri se luku, joka piilottaa sen.
Kysy mittaristasi aina: mihin kohtaan jakaumaa tämän toimenpiteen pitäisi vaikuttaa, ja mittaanko minä sitä kohtaa?
Käytän tästä eteenpäin mittarina yli6-osuutta: kuinka monta prosenttia autoista ylittää kyseisen pisteen nopeusrajoituksen vähintään kuudella kilometrillä tunnissa. Kuusi on valittu siksi, että se on pienin ylitys, josta Vesa sai maksun teknisen vähennyksen jälkeen. Mittari on siis se, mitä valvonta oikeasti rankaisee.
Rajaan aineiston lisäksi kolmella tavalla, ja jokainen rajaus poistaa yhden häiriölähteen:
Vain henkilö- ja pakettiautot. Raskaalla kalustolla on eri rajoitukset ja eri käyttäytyminen.
Vain vapaa liikennevirta. Jos edellisestä autosta on alle viisi sekuntia, kuljettaja ei valitse nopeuttaan itse — edellä ajava valitsee sen hänen puolestaan. Ruuhkassa mitattu nopeus kertoo liikennemäärästä, ei kuljettajan päätöksestä. Aineistossa noin 30 % ohituksista täyttää vapaan virran ehdon.
Vain arkipäivät, ei arkipyhiä. Viikonloppuliikenne on erilaista.
Ansa 1: vuoden sisäinen vertailu
Aloitetaan ilmeisimmästä tavasta vastata haasteeseen: katsotaan Kehä I:n lukuja pitkin vuotta 2026 ja etsitään hyppäystä.
Kehä I:n yli6-osuus oli viikolla 29 noin 29.2 % ja viikolla 39 noin 17.0 %. Pudotus on -12.2 prosenttiyksikköä — yli kolmannes pois.
Tämä olisi hieno otsikko. Se on myös väärin.
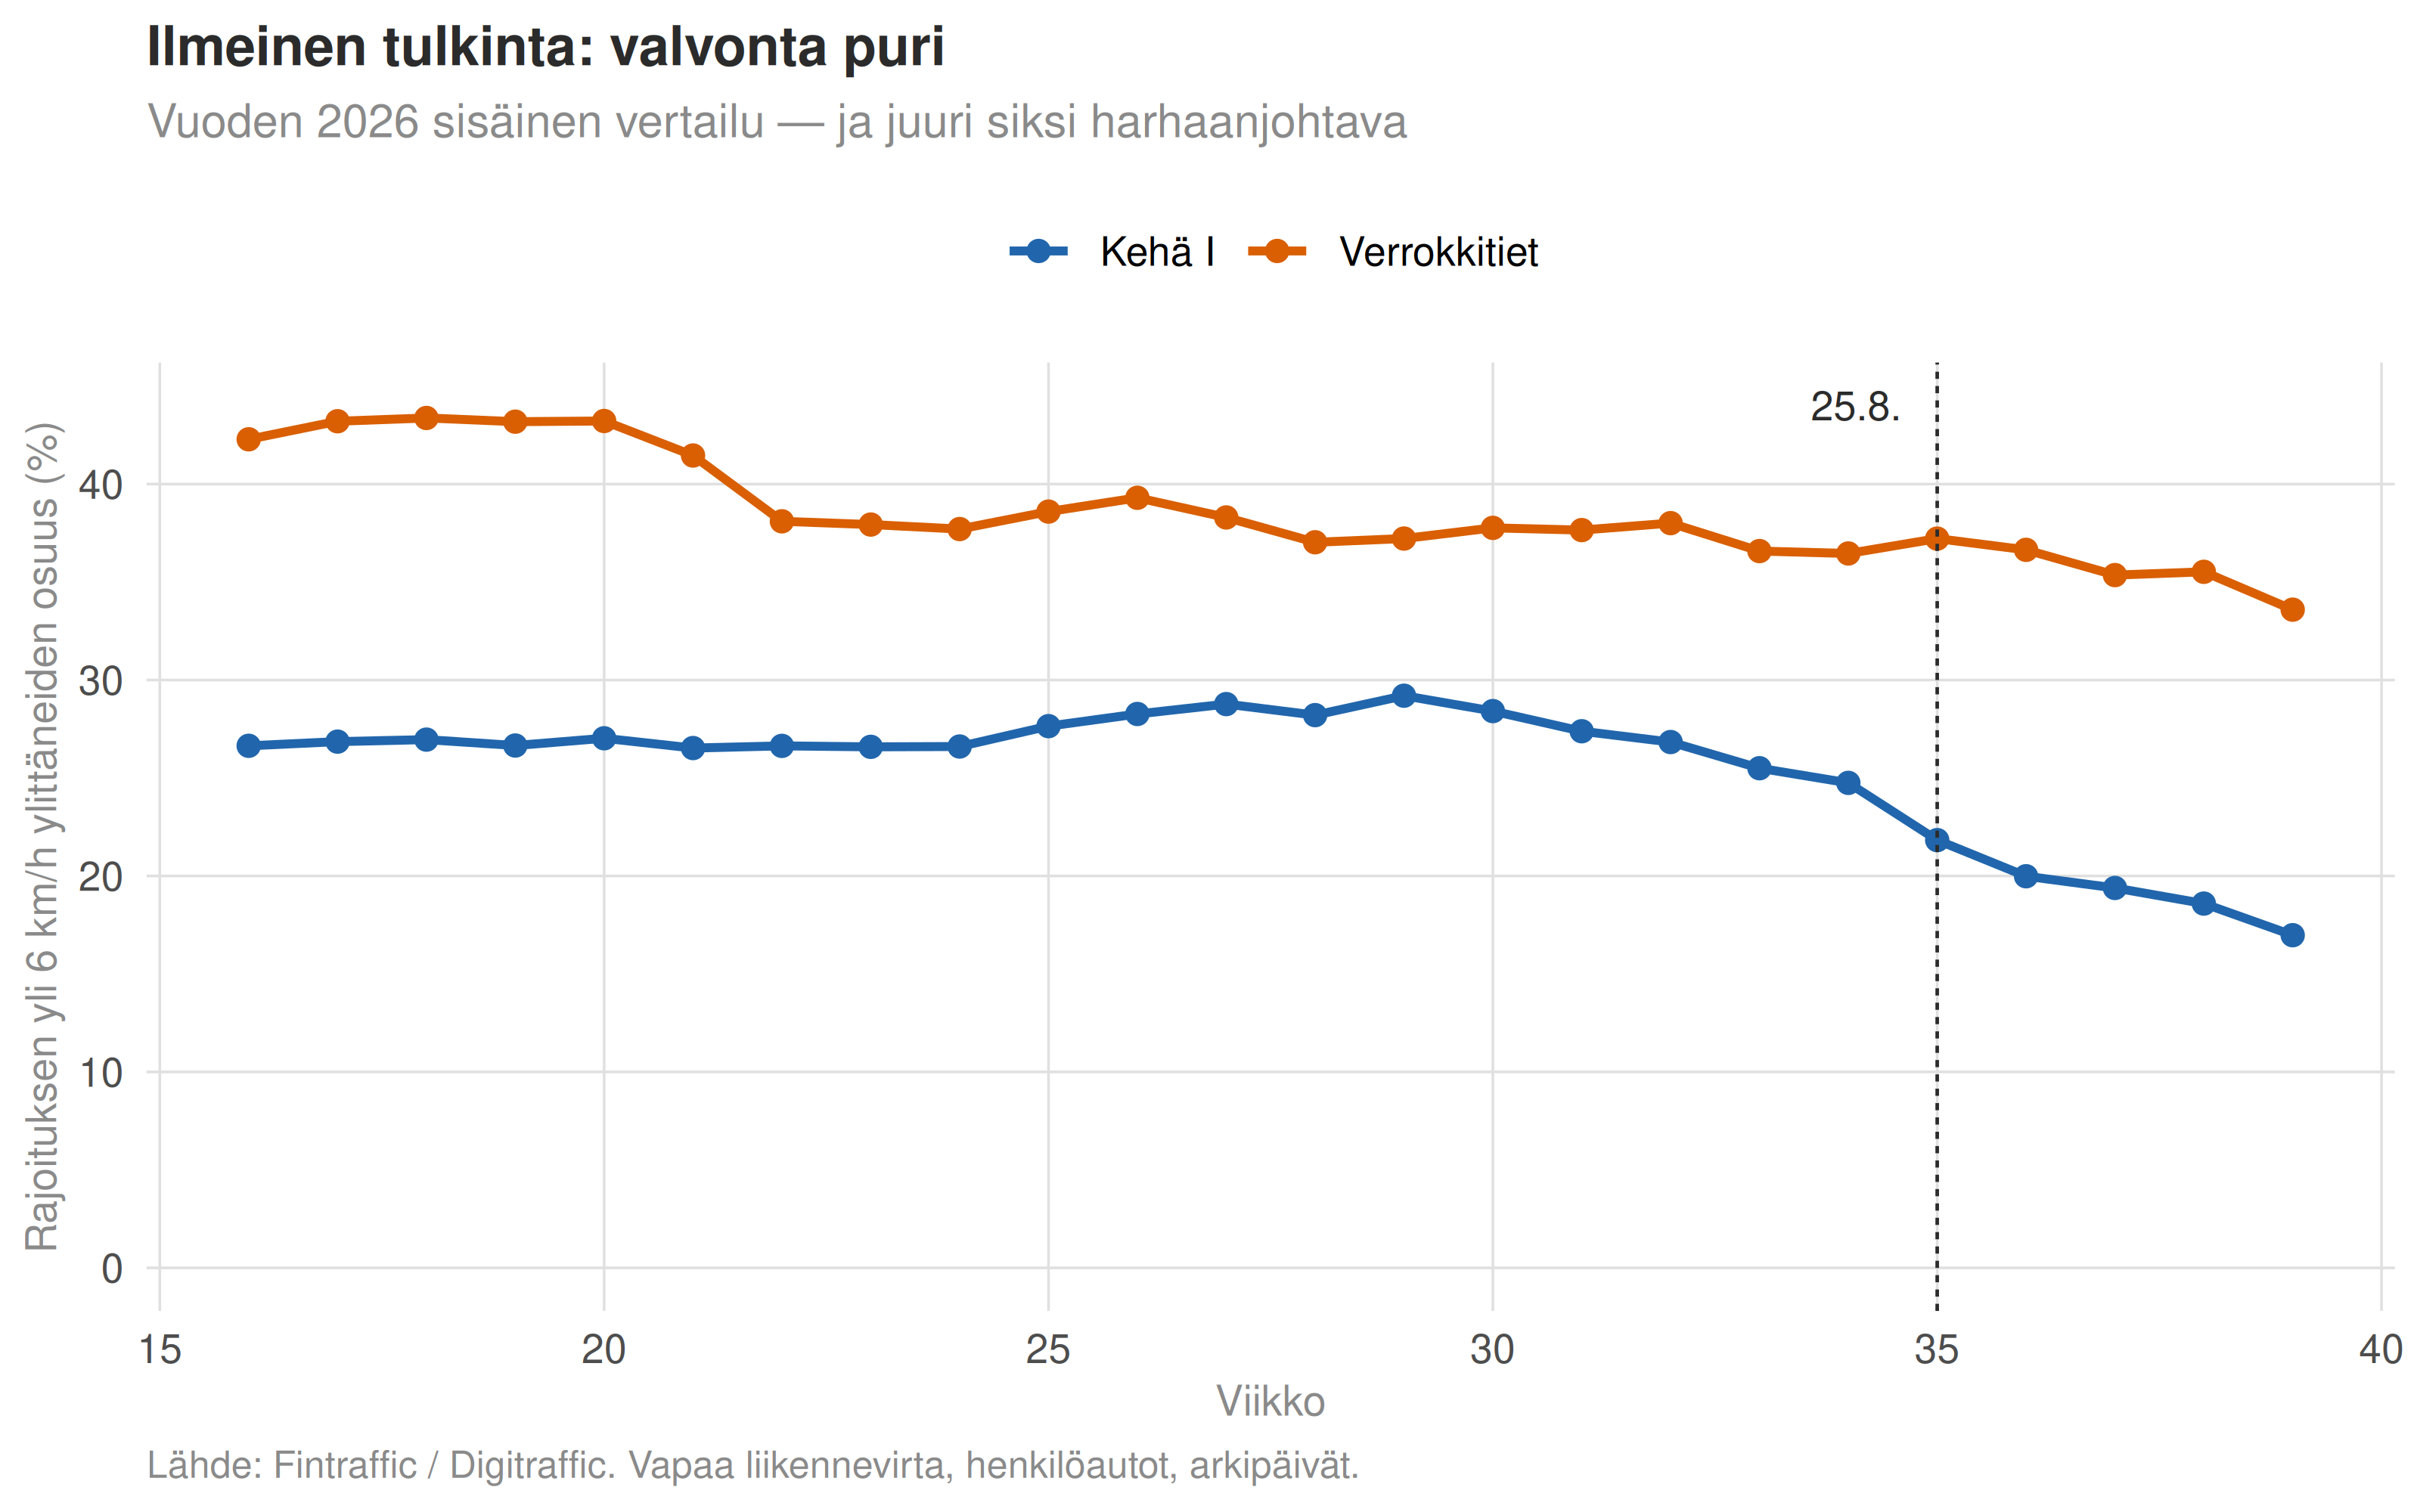
Ongelma näkyy, kun lasketaan käyrien erotus. Keväällä viikolla 16 Kehä I oli verrokkeja 15,7 prosenttiyksikköä alempana. Kesällä ero kaventui 8,0 prosenttiyksikköön. Syyskuun lopussa se oli 16,6 — eli käytännössä sama kuin keväällä.
Kehä I:n “pudotus” on suurelta osin paluu kevään tasolle kesälomakauden jälkeen. Kesällä kaupunkiliikenne on vähäisempää ja kuljettajat ajavat kovempaa; syksyllä se palautuu. Se ei ole valvontaa, se on kalenteri.
Jos vertailet mitä tahansa kausiluonteista ilmiötä saman vuoden sisällä, mittaat kausivaihtelua ja luulet mittaavasi toimenpidettä. Ainoa luotettava korjaus on verrata samaan ajankohtaan edellisenä vuonna. Siksi latasin koko vuoden 2025 samalta kalenterijaksolta, vaikka se kaksinkertaisti datamäärän.
Ansa 2: ryhmätason keskiarvo
Toinen ansa on hienovaraisempi, ja se nielaisee kokeneitakin analyytikkoja.
Edellisessä kuvassa “Kehä I” on laskettu poolaamalla kaikki ajoneuvot kaikilta Kehä I:n pisteiltä yhteen. Se on houkutteleva, koska havaintoja on paljon. Se on myös altis sille, että ryhmän koostumus muuttuu.
| Piste | Nimi | Ryhmä | 2025 | 2026 | Muutos % | Tila |
|---|---|---|---|---|---|---|
| 10 | st101_Espoo_Laajalahti | Kehä I | 45280 | 32317 | -28.6 | Hylätty |
| 147 | st101_Pakila | Kehä I | 114512 | 103259 | -9.8 | Hylätty |
| 153 | kt45_Oulunkylä | Verrokki | 43564 | 39939 | -8.3 | Hylätty |
| 145 | st101_Kannelmäki | Kehä I | 106253 | 105494 | -0.7 | Mukana |
| 101 | kt51_Hanasaari | Verrokki | 64812 | 64759 | -0.1 | Mukana |
| 146 | st101_Länsi-Pakila | Kehä I | 116262 | 116337 | 0.1 | Mukana |
Laajalahden piste menetti lähes kolmanneksen liikenteestään vuoden aikana — se on tietyömaan kokoluokka, ei satunnaisvaihtelua. Pakilan piste menetti kymmenyksen.
Kun ryhmän luku lasketaan poolaamalla, tällaisen pisteen painoarvo muuttuu. Jos nopea piste kutistuu, ryhmän keskiarvo laskee vaikka yksikään kuljettaja ei muuttaisi käytöstään. Ryhmässä näkyy muutos, jota ei tapahtunut missään.
Korjaus on periaatteessa yksinkertainen ja käytännössä aina oikea: laske muutos jokaiselle pisteelle erikseen ja keskiarvoista vasta pisteiden muutokset. Silloin jokainen piste painaa yhtä paljon riippumatta siitä, miten sen liikennemäärä kehittyi.
Lisäksi hylkään kokonaan ne neljä pistettä, joiden liikennemäärä muuttui yli 8 %. Niillä tien fyysinen tilanne on muuttunut, eikä niiden nopeuksia voi verrata viime vuoteen.
Ansa 3: verrokkien puute
Kolmas ansa: vaikka vertaisit oikein viime vuoteen ja oikein pisteittäin, et vieläkään tiedä, oliko muutos Kehä I:n erityispiirre vai tapahtuiko koko pääkaupunkiseudulla jotain.
Siksi mukana on yhdeksän verrokkipistettä muilta pääväyliltä — Kehä III, Länsiväylä, Tuusulanväylä, Lahdenväylä, Porvoonväylä ja Hämeenlinnanväylä. Niillä ei aloitettu valvontaa. Jos niillä tapahtuu sama muutos kuin Kehä I:llä, muutos ei johdu valvonnasta.
Tätä kutsutaan erotusten erotukseksi (difference-in-differences). Ajatus on helppo:
- Laske, paljonko Kehä I muuttui viime vuoteen verrattuna.
- Laske, paljonko verrokit muuttuivat viime vuoteen verrattuna.
- Vähennä jälkimmäinen edellisestä.
Ensimmäinen vähennys poistaa kausivaihtelun. Toinen poistaa kaiken sen, mikä vaikutti koko seudun liikenteeseen — sään, polttoaineen hinnan, talouden. Jäljelle jää se, mikä koski vain Kehä I:tä.
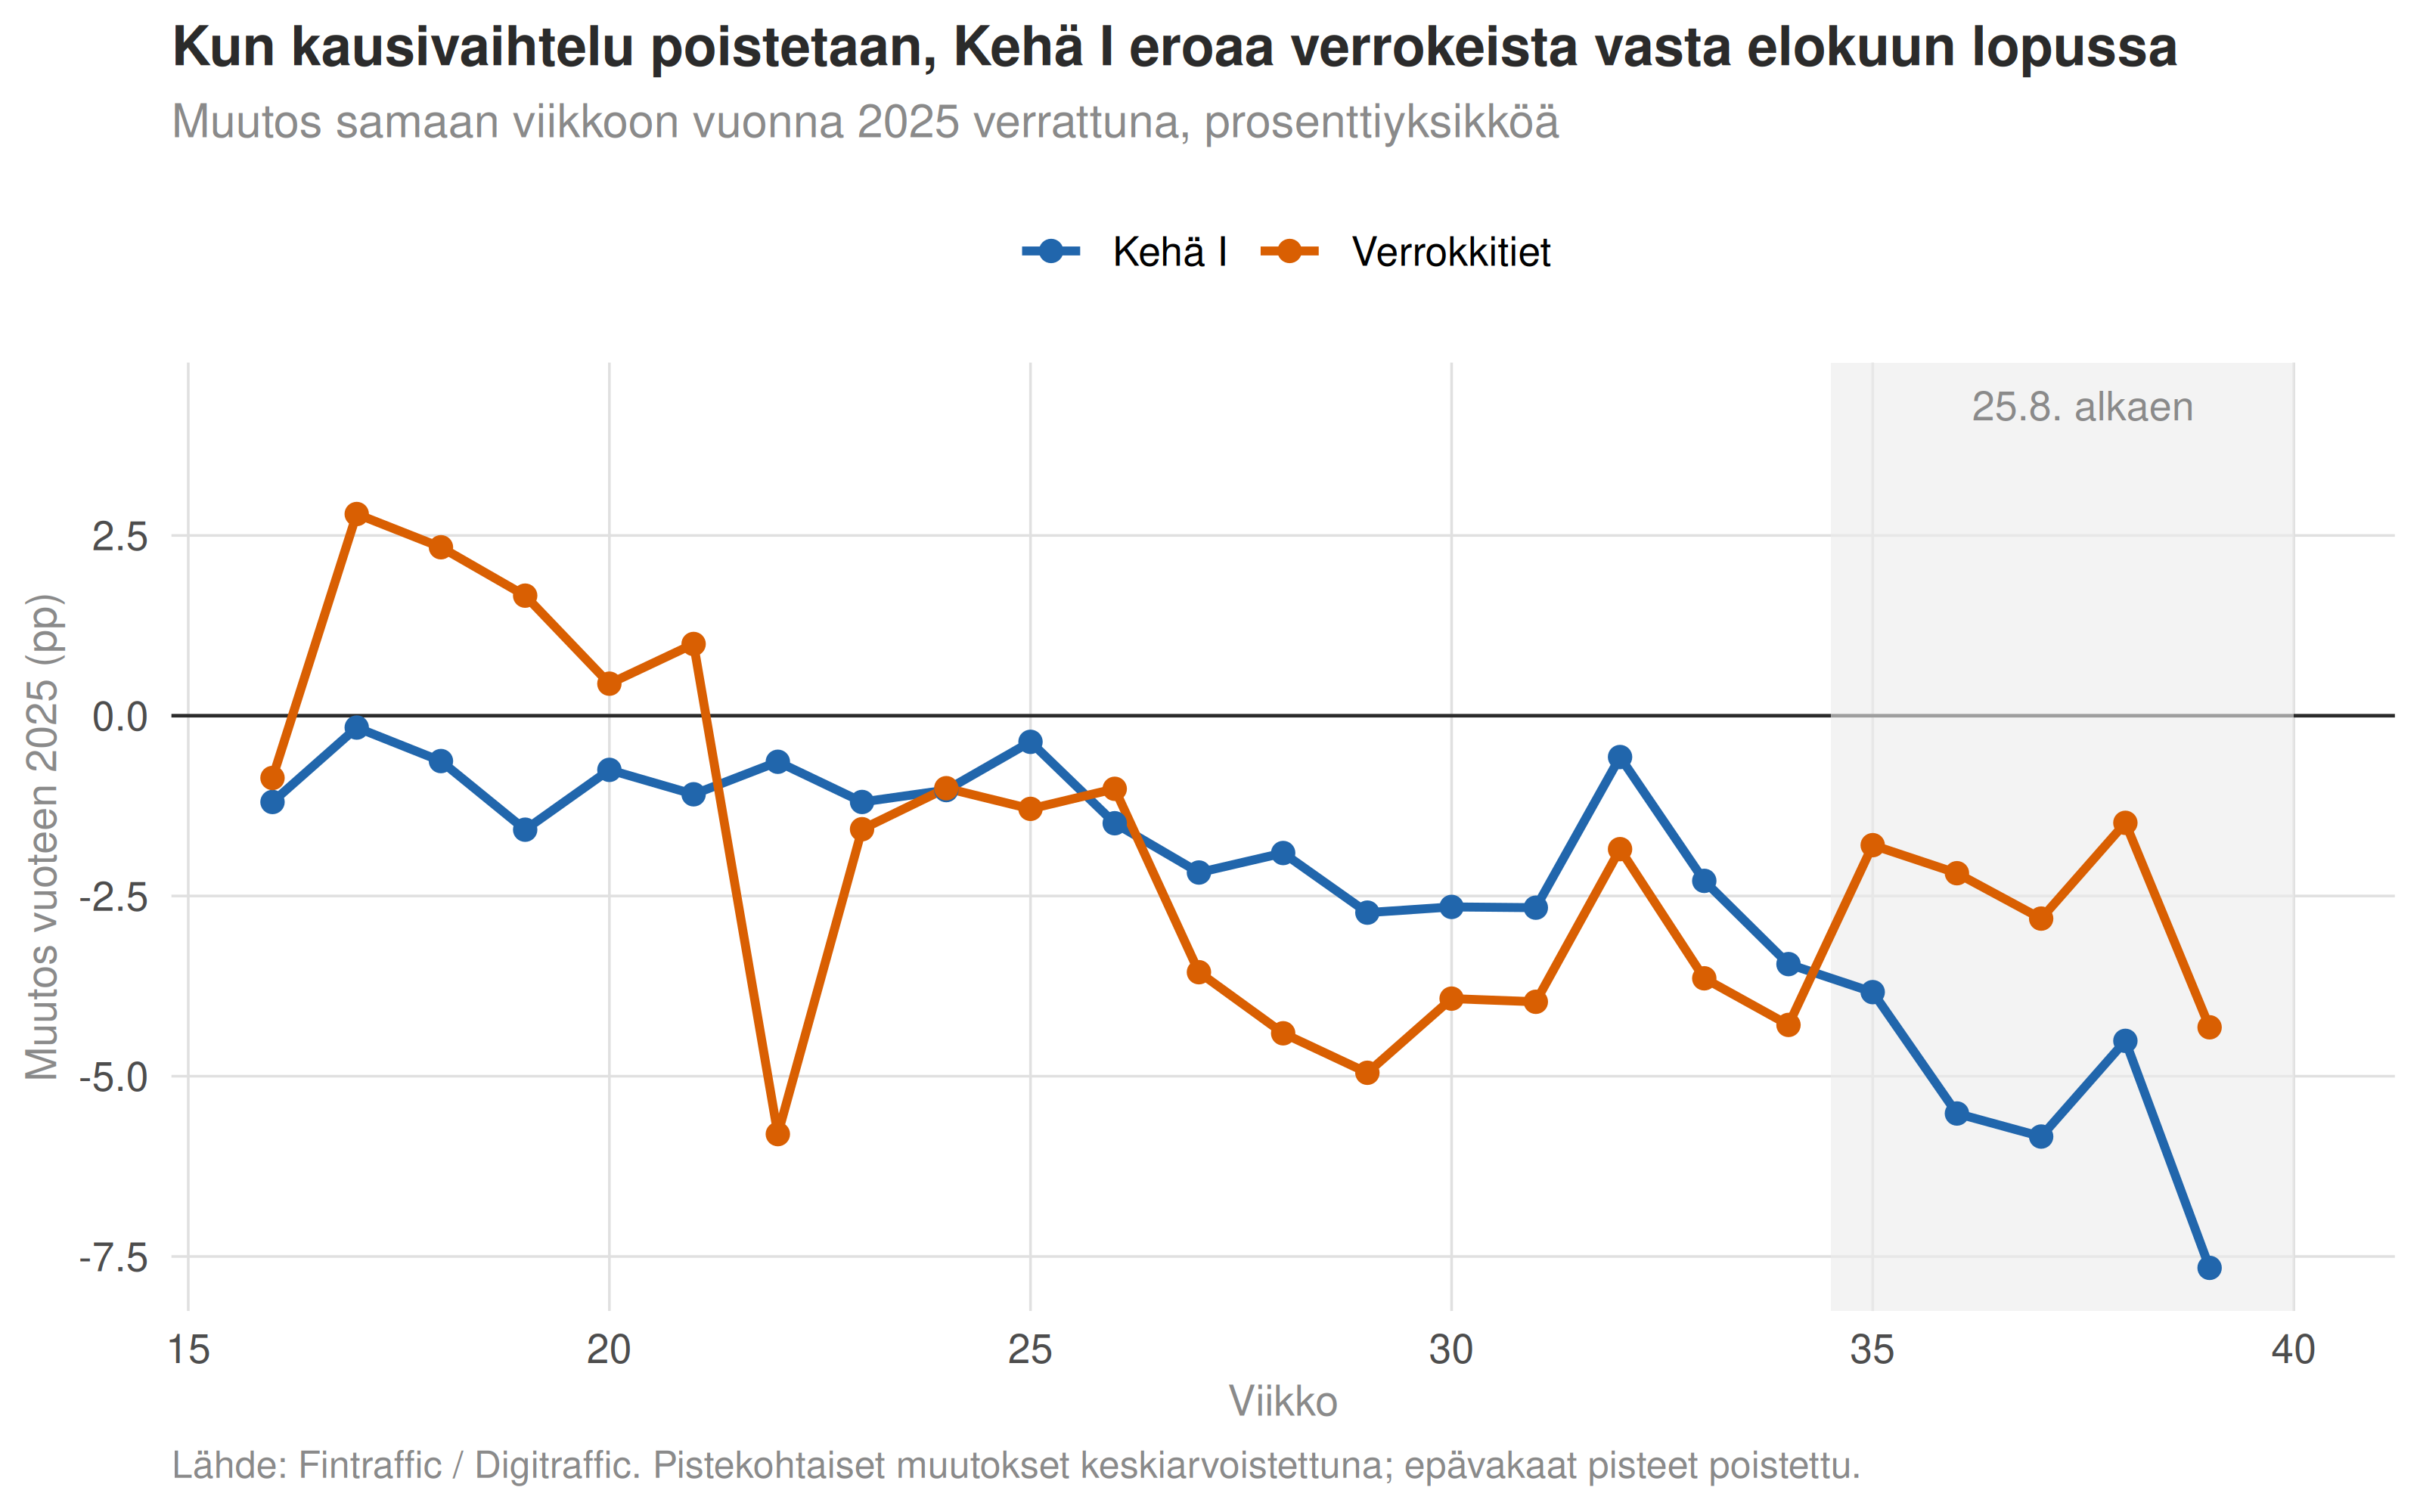
Kuvassa näkyy kaksi asiaa. Kesällä molemmat ryhmät olivat viime vuotta hitaampia, verrokit jopa enemmän kuin Kehä I. Elokuun lopusta alkaen tilanne kääntyy: Kehä I jatkaa alaspäin, verrokit palaavat lähemmäs nollaa.
Kuinka paljon alkuperäisestä 12.2 prosenttiyksiköstä on siis jäljellä? Puretaan se osiin.
| Vaihe | Arvio (pp) | Mitä korjaus poisti |
|---|---|---|
| 1. Naiivi: vuoden 2026 sisäinen vertailu | -12.2 | — |
| 2. Kausivaihtelu poistettu (vertailu vuoteen 2025) | -5.9 | Kesälomakauden paluuvaikutuksen |
| 3. Koostumus poistettu (pistekohtaiset muutokset) | -1.6 | Tietyömaiden aiheuttaman painotuksen muutoksen |
| 4. Verrokit poistettu (erotusten erotus) | -1.3 | Kaiken mikä koski koko pääkaupunkiseutua |
Naiivista 12 prosenttiyksiköstä jää jäljelle luokkaa 1.3. Noin yhdeksän kymmenesosaa alkuperäisestä “vaikutuksesta” oli jotain muuta kuin valvontaa.
Tämä on tavallista. Se on myös syy siihen, miksi datalla perusteltu päätöksenteko vaatii enemmän kuin yhden kuvaajan.
Milloin muutos tapahtui?
Nyt päästään siihen, missä data on vahvimmillaan.
Poliisi ei kerro, milloin automaattivalvonta on päällä. Se on tietoinen linjaus: valvonnan ennakoimattomuus on osa sen tehoa. Emme siis voi katsoa päivämäärää mistään rekisteristä — se on pääteltävä datasta.
Muodostan jokaiselle arkipäivälle luvun, joka kertoo, kuinka paljon Kehä I poikkesi verrokeista sen jälkeen kun molemmista on vähennetty niiden oma viime vuoden taso samalla viikolla. Jos mitään ei tapahdu, luku pysyy suunnilleen vakiona.
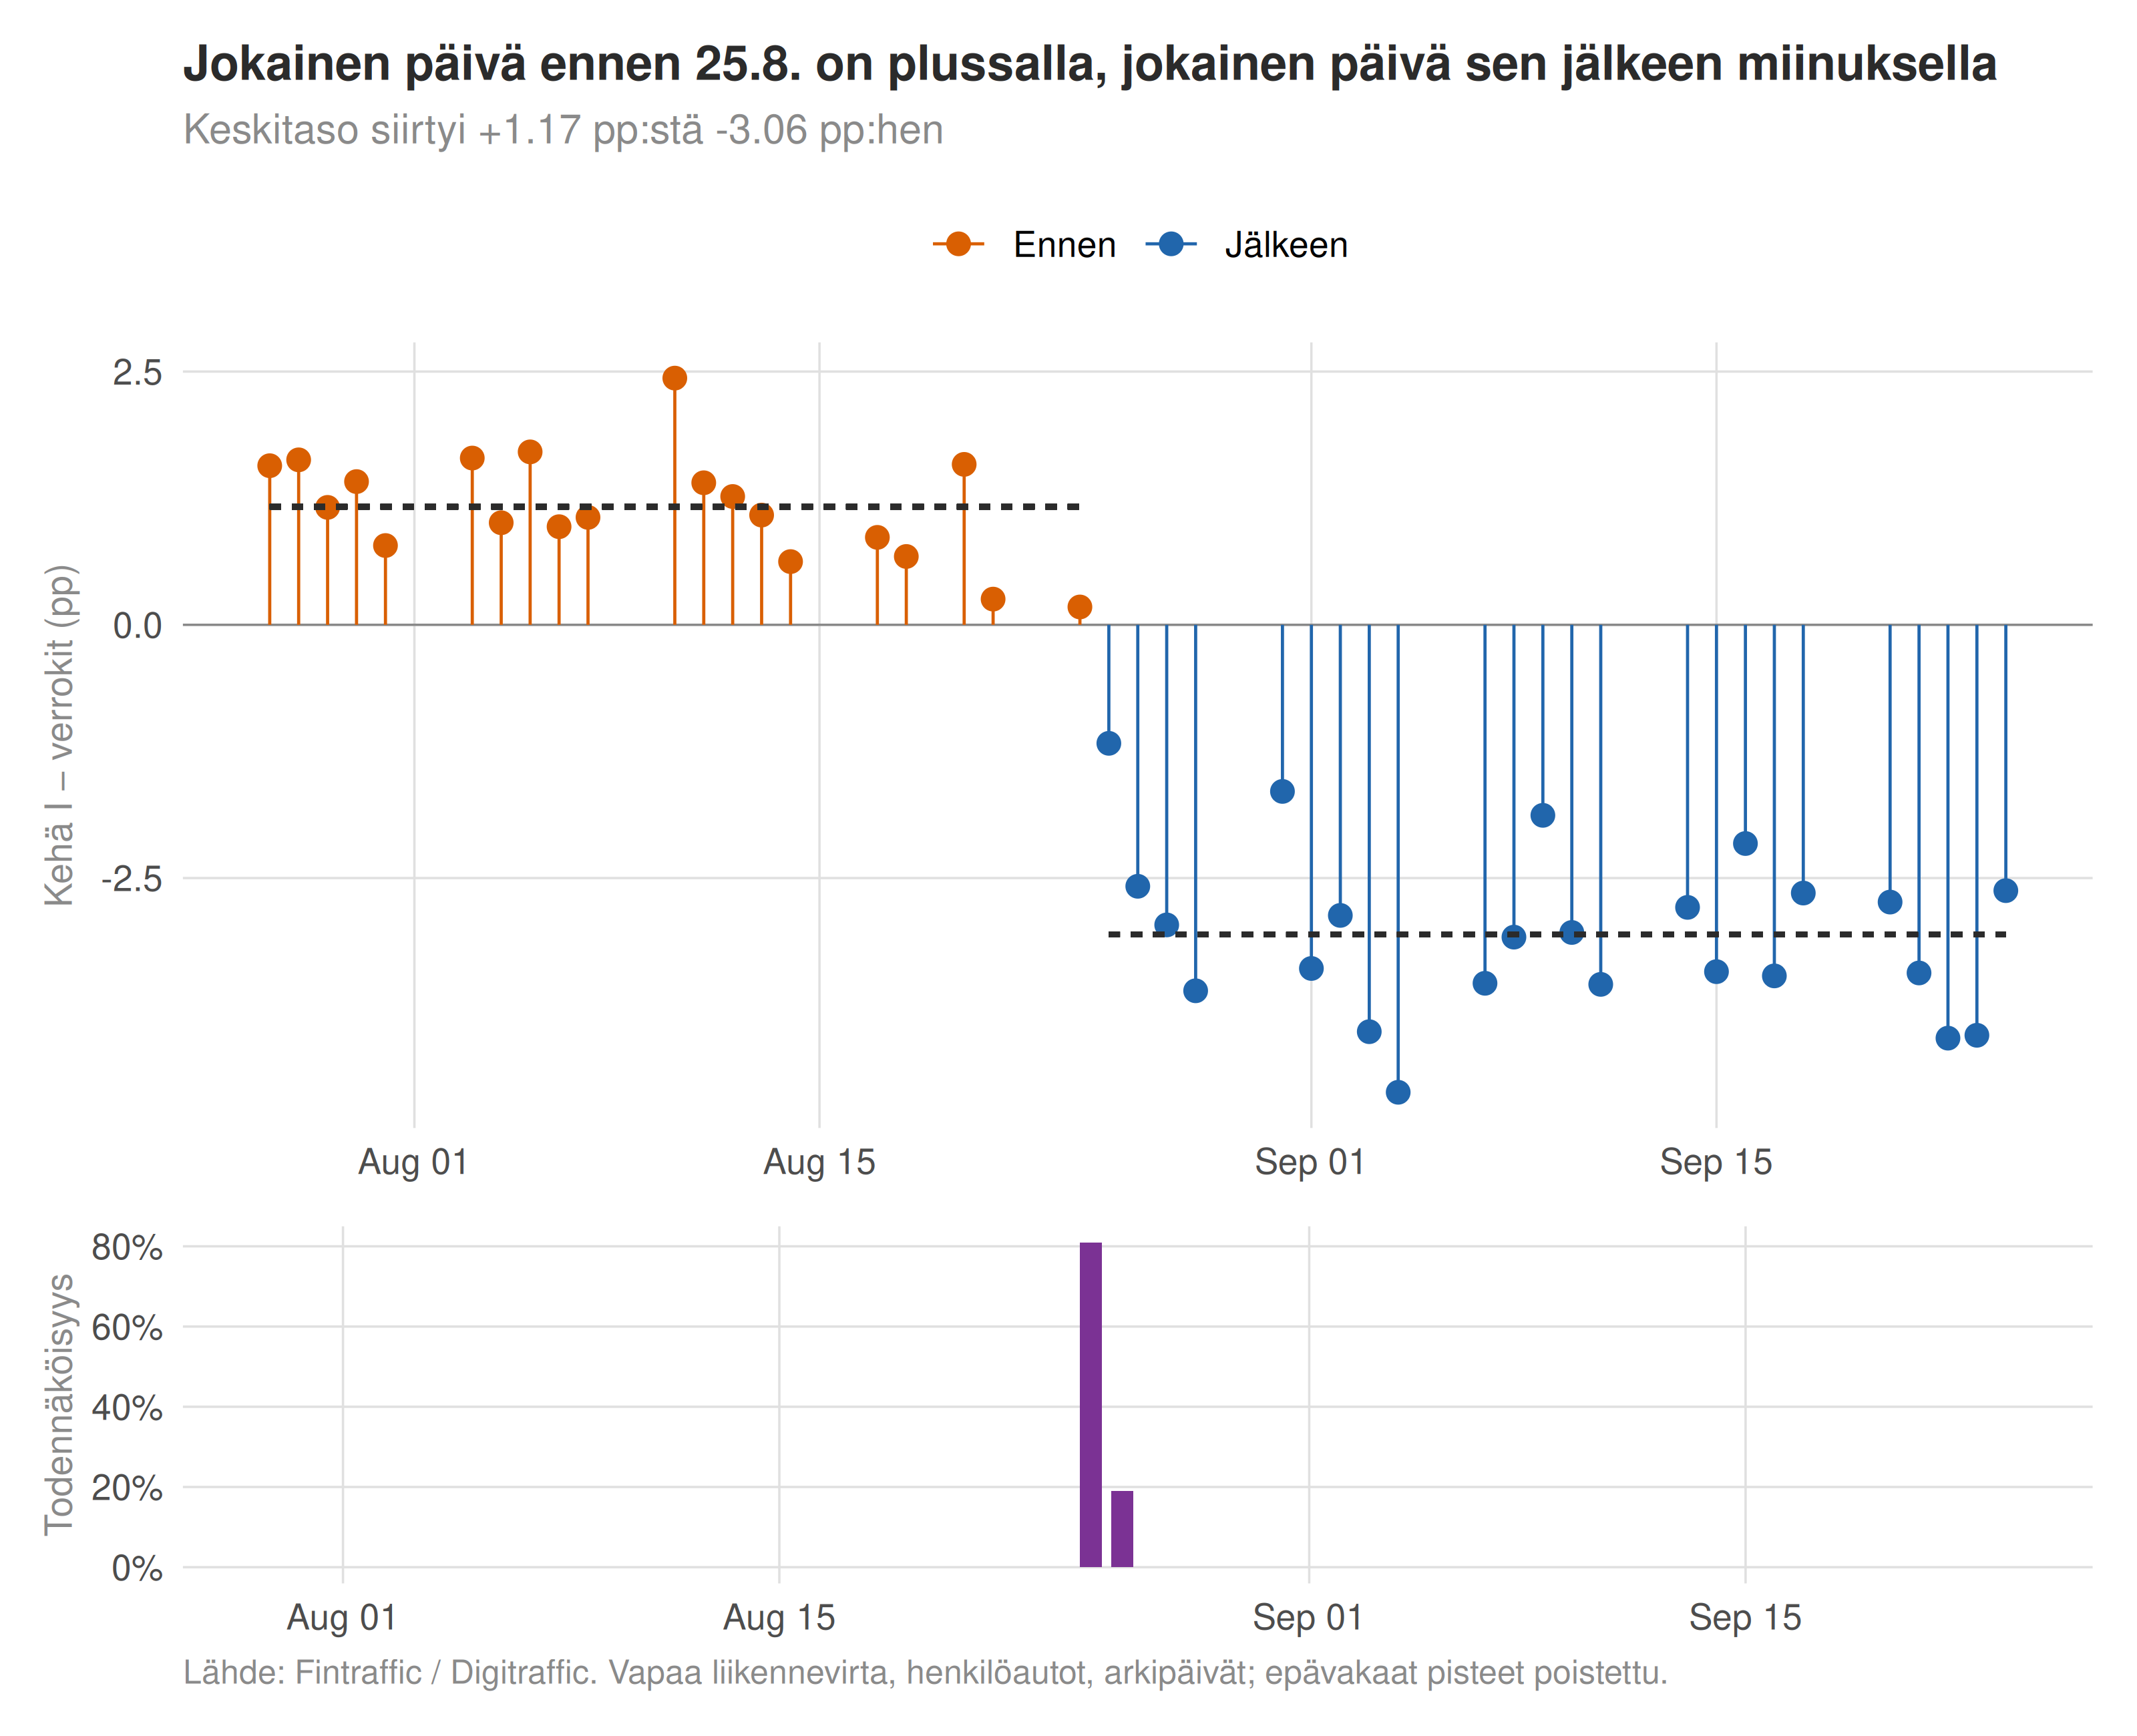
Tulos on poikkeuksellisen selvä. Muutoskohdan todennäköisin päivä on 25.8.2026, ja malli antaa sille todennäköisyyden 81 %. Kahdelle todennäköisimmälle päivälle yhteensä kertyy 100.0 % — malli ei siis epäröi viikon tai kuukauden sisällä, vaan yhden päivän tarkkuudella.
Vielä havainnollisempi on pelkkä merkkien laskeminen. Ennen tuota päivää aineistossa on 20 arkipäivää, ja jokainen niistä on plussalla. Siitä päivästä eteenpäin on 24 arkipäivää, ja jokainen niistä on miinuksella.
Kuinka epätodennäköistä tämä on? Jos päivien järjestys olisi sattumanvarainen, todennäköisyys sille että kaikki plusmerkkiset osuisivat ennen kaikkia miinusmerkkisiä on 5.7e-13 — eli noin yksi kahdesta biljoonasta. Tämä on tavallinen permutaatiotesti: se ei oleta jakaumasta mitään, vaan laskee suoraan, kuinka monella tavalla havainnot voisi järjestää ja kuinka moni niistä olisi yhtä siisti kuin havaittu.
Jotain tapahtui Kehä I:llä tiistaina 25. elokuuta 2026.
Tämä on kymmenen päivää ennen kuin Vesa sai virhemaksunsa 4. syyskuuta. Valvonta oli siis käynnissä jo yli viikon ennen kuin yksikään sakon saanut ehti kertoa siitä julkisesti. Avoin data näki sen ennen kuin kukaan tiesi sitä.
Kuinka suuri vaikutus oli?
Muutoskohta on nyt tiedossa. Seuraava kysymys on suuruus — ja siihen vastattaessa on rehellistä näyttää myös epävarmuus.
Käytän bayesilaista hierarkkista mallia. “Hierarkkinen” tarkoittaa, että malli tietää havaintojen kuuluvan mittauspisteisiin ja antaa jokaiselle pisteelle oman tasonsa ja oman muutoksensa, mutta lainaa tietoa pisteiden välillä. “Bayesilainen” tarkoittaa, että tulos ei ole yksi luku vaan jakauma uskottavista arvoista.
Käytän Studentin t-jakaumaa normaalijakauman sijaan. Syy on käytännöllinen: aineistossa on pari pistettä, joiden muutos on poikkeuksellisen suuri. Normaalijakauma antaisi niiden vetää koko arviota puoleensa. T-jakauma on paksuhäntäisempi, eli se pitää poikkeavia havaintoja mahdollisina eikä anna niiden hallita tulosta. Näin poikkeavia havaintoja ei tarvitse poistaa käsin — mikä olisi aina altis sille, että poistaa juuri ne, jotka eivät sovi omaan ennakkokäsitykseen.
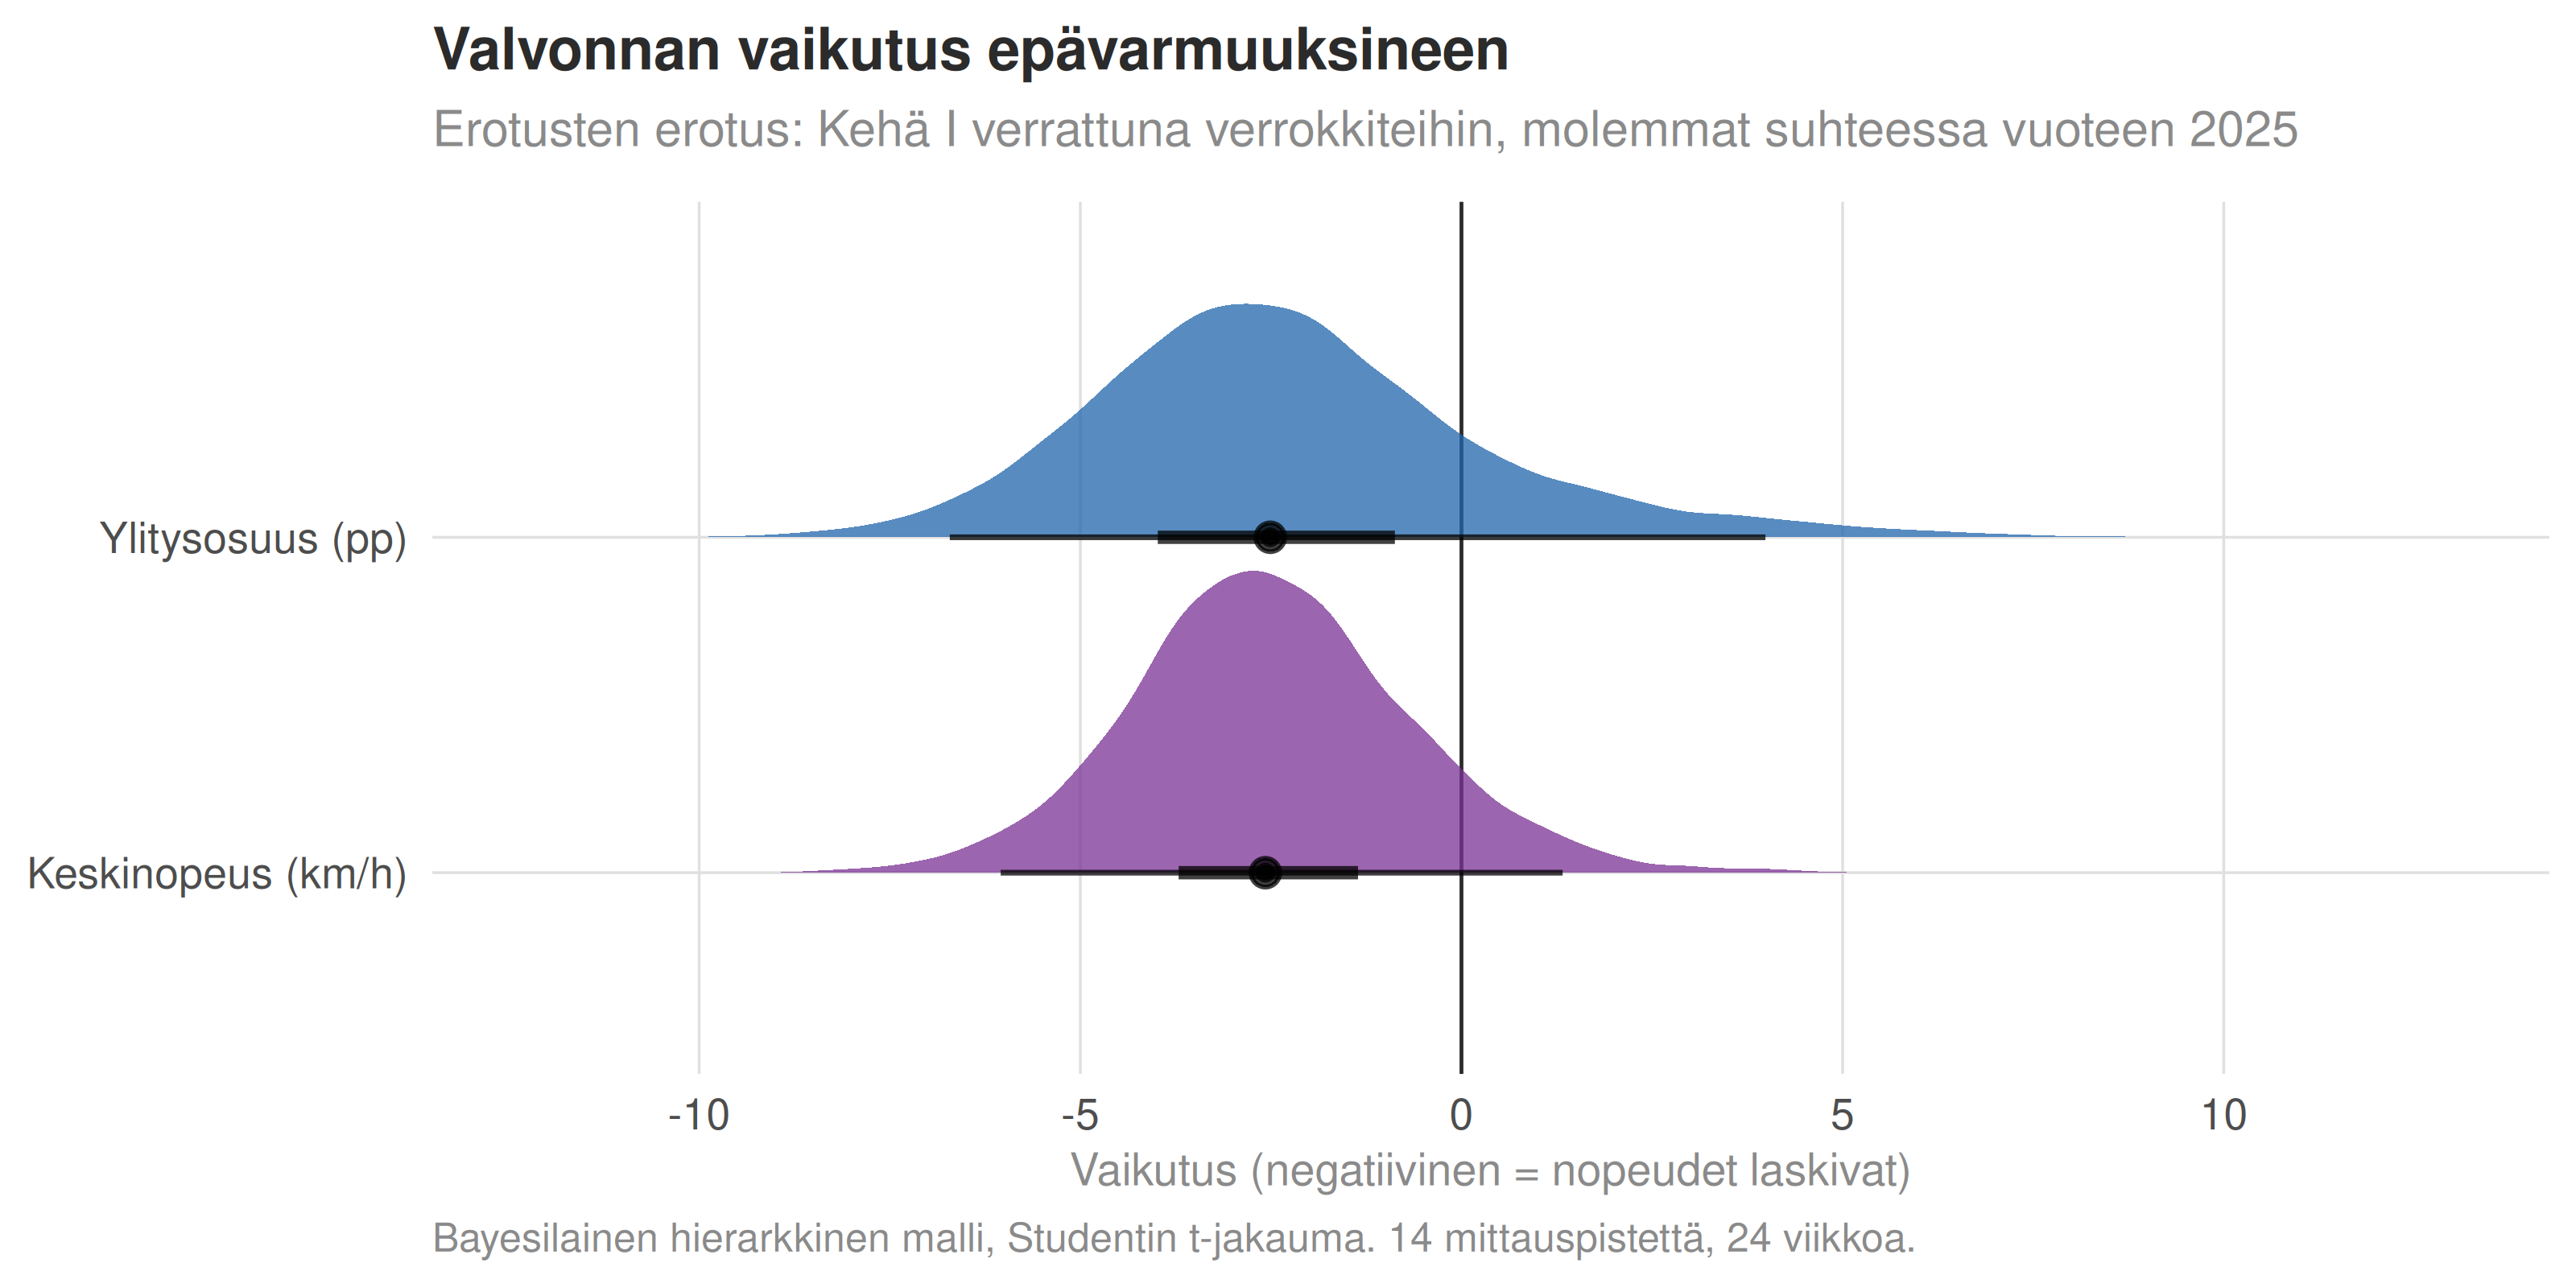
| Mittari | Vaikutus | 95 %:n uskottavuusväli | Todennäköisyys että vaikutus on negatiivinen |
|---|---|---|---|
| Keskinopeus (km/h) | -2.57 | -6.04 … 1.33 | 91 % |
| Ylitysosuus (pp) | -2.51 | -6.71 … 3.99 | 83 % |
Mallin mukaan ylitysosuus laski Kehä I:llä verrokkeihin nähden noin 2.5 prosenttiyksikköä, ja todennäköisyys sille että vaikutus on todella negatiivinen on 83 %.
Huomaa, että uskottavuusväli on leveä. Se on rehellinen kuva tilanteesta: käytettävissä on neljätoista mittauspistettä ja viisi viikkoa jälkijaksoa. Piste-estimaatti ilman tätä väliä antaisi liian varman kuvan.
NoteFaktalaatikko: mitä tutkimus sanoo nopeuskameroiden vaikutuksesta
Yksittäinen tutkimus voi osua väärin. Siksi kannattaa katsoa meta-analyysejä, jotka kokoavat kymmenien tutkimusten tulokset yhteen.
Onnettomuudet. Alena Høyen meta-analyysi (Accident Analysis & Prevention 2014) kokosi 63 vaikutusarviota 15 tutkimuksesta. Kiinteät nopeuskamerat vähensivät onnettomuuksia kokonaisuudessaan noin 20 %. Kuolemaan johtaneissa onnettomuuksissa vähenemä oli 51 %, mutta tekijä varoittaa itse, että tähän voi sisältyä keskiarvoon palautumisen harhaa: kameroita asennetaan paikkoihin, joissa on juuri sattunut poikkeuksellisen paljon onnettomuuksia, ja osa parannuksesta tapahtuisi ilman kameraakin.
Nopeudet. Tuore systemaattinen katsaus (Accident Analysis & Prevention 2026) kävi läpi 94 tutkimusta ja sai yhdistetyksi vaikutukseksi −7,57 km/h (95 %:n luottamusväli −10,48…−4,66) satunnaisvaikutusmallilla. Luku koskee kameran välitöntä läheisyyttä.
Etäisyys. Høyen keskeinen havainto on, että vaikutus heikkenee nopeasti kameralta etäännyttäessä. Kamera ei hidasta tietä, se hidastaa kohtaa.
Meta-analyysin −7,57 km/h ja tämän analyysin arvio samasta suuruusluokasta kuin yksi kilometri tunnissa eivät ole ristiriidassa, koska ne mittaavat eri asiaa. Meta-analyysin luku on kameran kohdalla; tässä arvio on koko Kehä I:n keskiarvo kaikilta mittauspisteiltä, joista useimmat ovat satojen metrien päässä lähimmästä kamerasta.
Onko se todella valvontaa?
Tähän asti on osoitettu, että jokin muuttui 25. elokuuta ja että muutos koski Kehä I:tä mutta ei verrokkiteitä. Se ei vielä todista, että syy on nopeusvalvonta. Tietyö, nopeusrajoituksen muutos tai muuttuvien opasteiden uusi ohjelmointi tuottaisivat myös Kehä I:lle rajoittuvan muutoksen.
Tarvitaan jotain, joka erottaa valvonnan muista selityksistä. Sellainen löytyy kaistoista.
Jos tie kavennetaan tai rajoitusta lasketaan, kaikki hidastuvat suunnilleen yhtä paljon. Jos taas kyse on valvonnasta, hidastuvat ne jotka ajoivat ylinopeutta — ja he ovat vasemmalla kaistalla. Oikealla kaistalla ajavat eivät juuri muuta käytöstään, koska heillä ei ole syytä.
Leppäsolmun pisteellä on kolme kaistaa suuntaansa. Vasen kaista on se, jolla Vesa jäi kiinni.
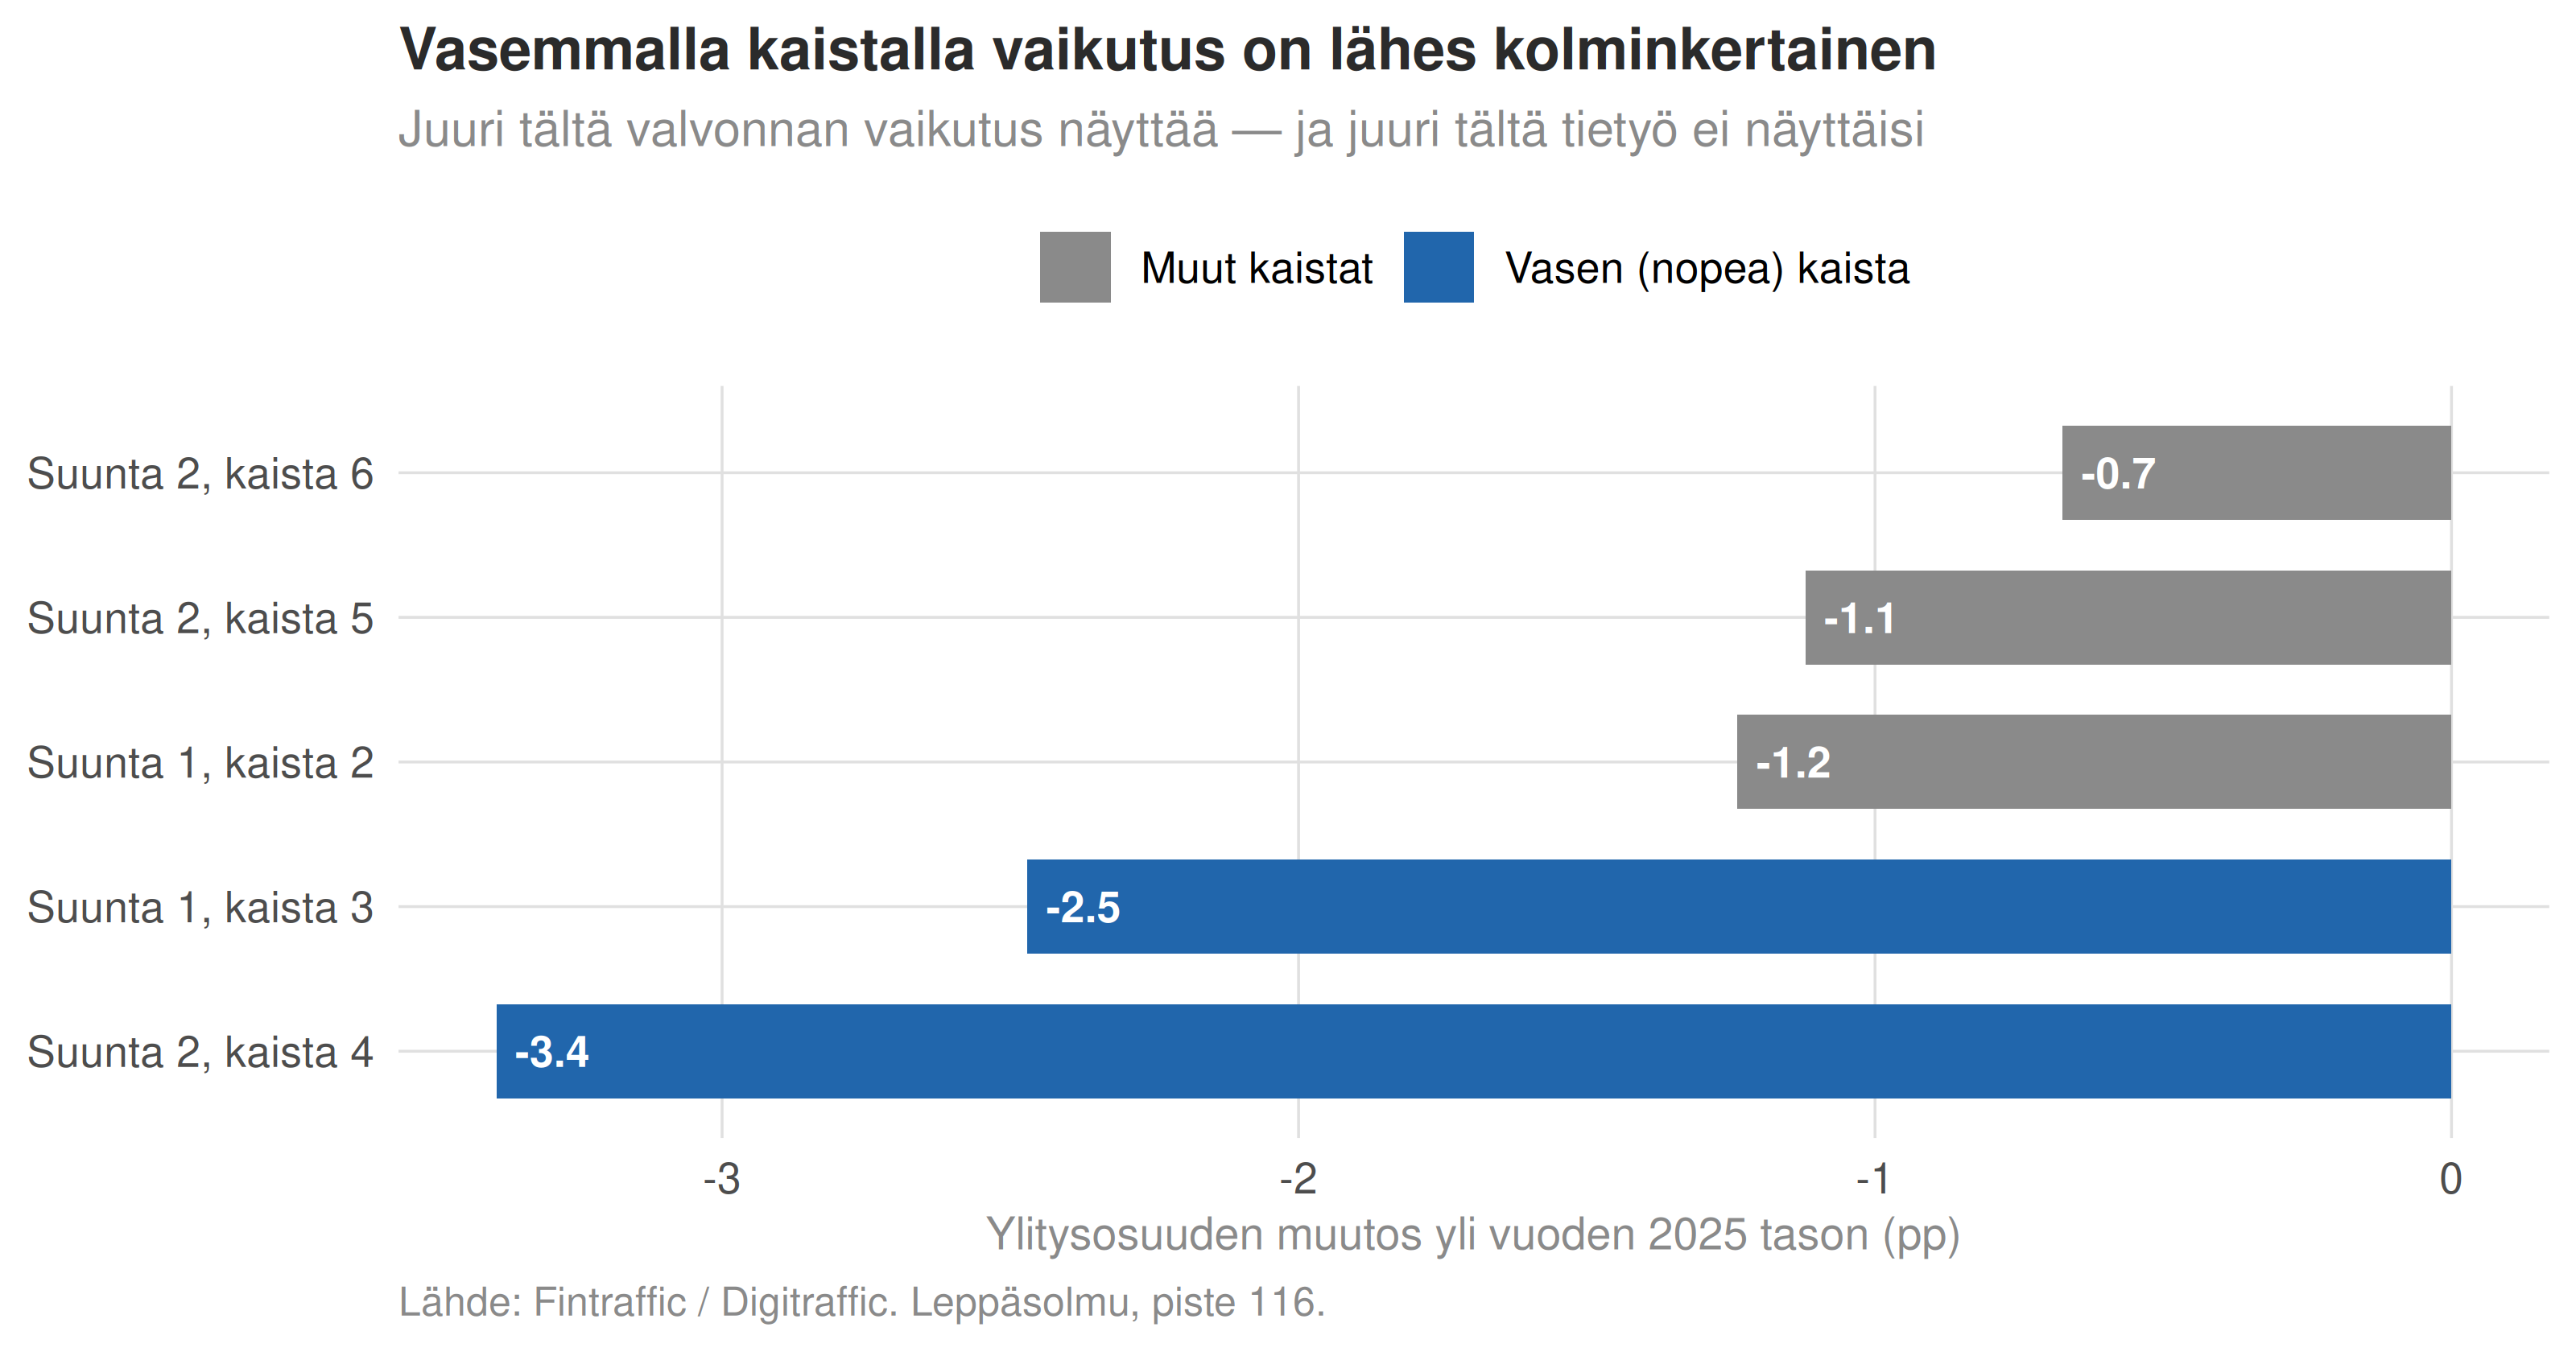
Vasemmilla kaistoilla muutos on keskimäärin -2.93 prosenttiyksikköä, muilla kaistoilla -1.01. Ero on 2.9-kertainen.
Tämä on se todiste, jota ilman koko analyysi jäisi arvailuksi. Tien kaventaminen ei valitse kaistaa. Nopeusrajoituksen lasku ei valitse kaistaa. Valvonta valitsee: se vaikuttaa niihin, joilla on jotain menetettävää, ja he ovat vasemmalla.
Leppäsolmun LAM-pisteen ja lähimmän kameran välimatka on noin 300 metriä, ja OSM-aineiston mukaan siellä on kaksi kameraa vierekkäin, molemmat 70 km/h:n rajoituksella — yksi kumpaankin suuntaan. Mittauspiste on siis juuri ennen kameraa, mikä sopii siihen, että Vesan virhemaksu oli kellotettu noin puoli minuuttia LAM-havainnon jälkeen.
Mitä data ei kerro
Rehellisyyden nimissä on sanottava, mitä tässä aineistossa ei ole.
Kahdella pisteellä muutos on liian suuri ollakseen valvontaa. Kannelmäen pisteellä ylitysosuus putosi 14 prosenttiyksikköä ja keskinopeus lähes 11 km/h yli viime vuoden tason, vaikka liikennemäärä pysyi ennallaan. Länsi-Pakilassa luvut ovat samaa luokkaa. Yksikään meta-analyysi ei raportoi kameravalvonnasta 11 km/h:n keskinopeusvaikutusta. Todennäköisin selitys on tietyö tai rajoitusmuutos, jota ei näy liikennemäärässä. Nämä pisteet ovat mukana mallissa, mutta Studentin t-jakauma estää niitä hallitsemasta tulosta.
Vaikutuksen etäisyysriippuvuutta ei voi vielä osoittaa. Høyen meta-analyysin perusteella vaikutuksen pitäisi heiketä kameralta etäännyttäessä. Aineistossa suunta on oikea — korrelaatio etäisyyden ja muutoksen välillä on positiivinen (Spearmanin järjestyskorrelaatio noin 0,61) — mutta seitsemällä pisteellä se ei yllä tilastolliseen merkitsevyyteen. Tämä ei tarkoita, ettei ilmiötä ole; se tarkoittaa, että pisteitä on liian vähän.
Jälkijakso on kolme viikkoa. Se riittää osoittamaan, että muutos tapahtui. Se ei riitä kertomaan, pysyykö se. Kirjallisuudessa tunnetaan ilmiö, jossa vaikutus haalistuu, kun kuljettajat oppivat kameroiden sijainnit ja alkavat jarruttaa vain niiden kohdalla — Høye kutsuu sitä kenguruhypyksi.
Emme tiedä varmasti, mitä 25. elokuuta tapahtui. Tiedämme, että jotain tapahtui, että se koski Kehä I:tä eikä verrokkiteitä, ja että se vaikutti vasempaan kaistaan kolme kertaa voimakkaammin kuin muihin. Kaikki tämä sopii valvonnan aloittamiseen. Mikään siitä ei ole poliisin vahvistus.
Vastakkaiset skenaariot
Mitä tämä merkitsee, jos se jatkuu? Lasketaan läpi muutama vaihtoehtoinen tulevaisuus.
Nopeuden ja onnettomuuksien suhdetta kuvataan liikenneturvallisuustutkimuksessa kahdella vakiintuneella mallilla, ja käytän molempia — koska mallin valinta on yksi epävarmuuden lähde, jota ei pidä piilottaa.
NoteFaktalaatikko: kuinka nopeus muuttuu onnettomuuksiksi
Potenssimalli (Rune Elvik). Onnettomuuksien määrä muuttuu keskinopeuden suhteellisen muutoksen potenssina. Mallin mukaan 10 %:n lasku keskinopeudessa vähentää kuolemaan johtaneita onnettomuuksia keskimäärin 35 % ja loukkaantumisiin johtaneita 16 %. Tästä seuraa eksponentti noin 4,1 kuolemille ja noin 1,65 loukkaantumisille.
Eksponenttimalli (käytetty mm. ruotsalaisessa kameratutkimuksessa). Onnettomuuksien määrä muuttuu eksponentiaalisesti nopeuden absoluuttisen muutoksen mukana, kertoimella noin 0,08 kuolemille ja 0,06 vakaville loukkaantumisille kilometriä tunnissa kohden.
Mallit on kalibroitu pääosin maantieolosuhteissa. Kaupunkimoottoritiellä niiden antamat luvut ovat suuntaa-antavia.
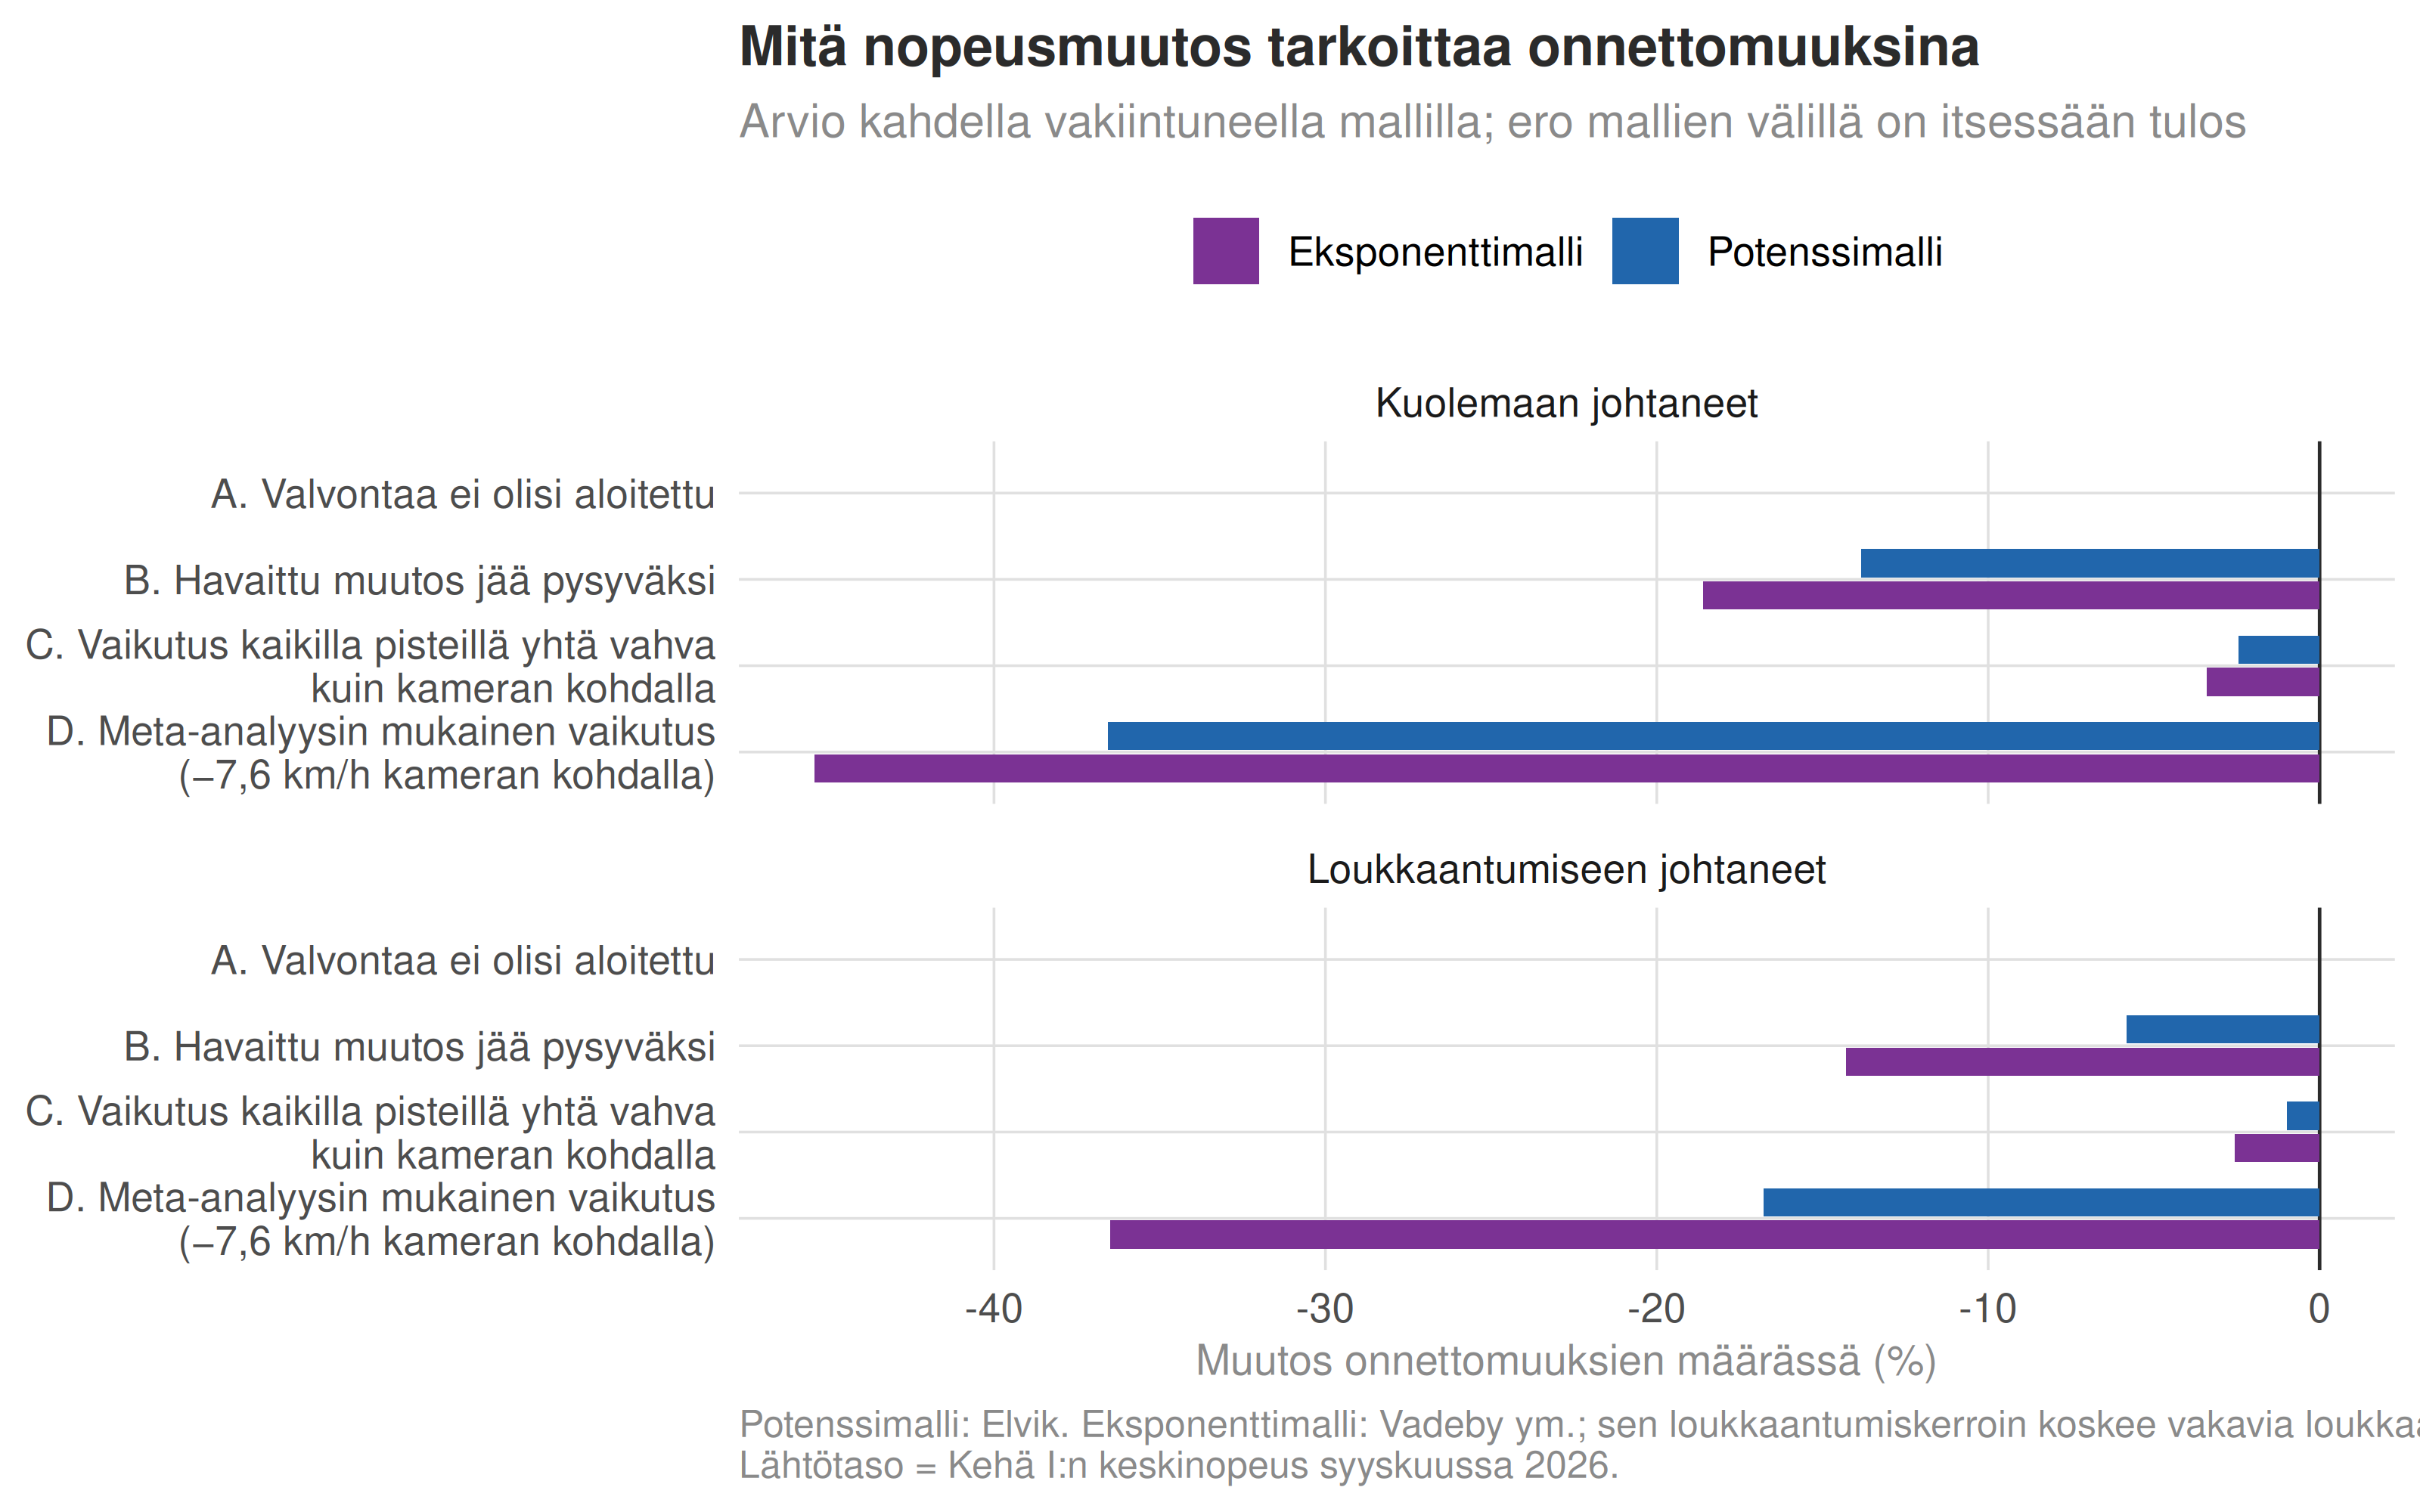
Skenaario B — havaitun muutoksen jääminen pysyväksi — tuottaa vaatimattoman mutta ei merkityksettömän parannuksen. Skenaario C, jossa koko Kehä I käyttäytyisi niin kuin kameran välitön lähistö, on huomattavasti suurempi. Skenaario D näyttää, mitä olisi luvassa, jos suomalainen valvonta yltäisi kansainvälisen meta-analyysin keskitasolle.
Kahden mallin ero on itsessään olennainen tulos. Potenssimalli antaa kuolemille selvästi suuremman vaikutuksen kuin eksponenttimalli. Kumpikaan ei ole väärä; ne on kalibroitu eri aineistoilla. Jos joku esittää sinulle yhden luvun siitä, montako ihmishenkeä jokin liikenneratkaisu säästää, kysy mitä mallia on käytetty ja miltä toinen malli sanoisi.
Ennuste, joka kirjataan nyt
Analyysin uskottavuuden mitta ei ole se, miten hyvin se selittää mennyttä. Se on se, osuuko se tulevaan.
Siksi kirjaan tähän ennusteen ennen kuin data on olemassa. Tämä postaus on julkaistu 7.10.2026, ja aineisto päättyy 25.9.2026. Ennusteet koskevat aikaa, jota en ole nähnyt.
| Ennuste | Luottamus |
|---|---|
| Kehä I:n ylitysosuus marraskuussa 2026 on alempi kuin marraskuussa 2025 | 85 % |
| Ero verrokkiteihin (erotusten erotus) on marraskuussa edelleen negatiivinen | 80 % |
| Vaikutus on pienempi marraskuussa kuin syyskuussa (kenguruhyppy) | 60 % |
| Leppäsolmun vasemman kaistan vaikutus on edelleen yli kaksinkertainen muihin kaistoihin nähden | 70 % |
| Vähintään yksi Kehä I:n piste osoittautuu tietyömaaksi eikä valvontavaikutukseksi | 75 % |
Ennusteet ovat tarkistettavissa kenen tahansa toimesta: sama avoin data, sama koodi. Jos ne menevät pieleen, se näkyy.
Mitä tästä voi oppia
Haaste oli yksinkertainen: näkyykö valvonnan aloittaminen datassa. Vastaus on kyllä — mutta vasta kun kolme asiaa on tehty oikein.
Oikea mittari. Keskinopeus olisi näyttänyt pienen muutoksen ja johtanut johtopäätökseen “ei juuri vaikutusta”. Jakauman yläpää näyttää, että muutos osui täsmälleen sinne, minne valvonnan kuuluukin osua.
Oikea vertailukohta. Vuoden sisäinen vertailu olisi antanut yhdeksän kertaa liian suuren luvun, koska kesälomakausi näyttää interventiolta.
Oikea yksikkö. Ryhmätason keskiarvo olisi sekoittanut tietyömaiden aiheuttamat painotusmuutokset kuljettajien käyttäytymiseen.
Ja lopuksi: muutoskohdan löytäminen datasta on sinänsä kiinnostava kyky. Poliisi ei kerro, milloin valvonta on päällä. Avoin data kertoi sen päivän tarkkuudella — ja kymmenen päivää ennen kuin asia tuli julkiseksi sitä kautta, että joku sai sakon ja kirjoitti siitä.
ImportantMitä tällä tekee yrityksessä
Tämän analyysin rakenne ei liity liikenteeseen millään tavalla. Se on yleinen vastaus kysymykseen “muuttuiko jokin, ja oliko se meidän ansiotamme”.
Milloin kilpailijasi muutti hinnoitteluaan? Sama muutoskohtamalli julkisesta hintadatasta kertoo päivän, jona strategia vaihtui — ilman että kukaan ilmoittaa siitä. Sama pätee toimitusaikoihin, aukioloihin, rekrytointi-ilmoituksiin ja julkisiin hankintailmoituksiin.
Toimiko kampanja, vai oliko se kausi? Useimmat markkinoinnin vaikutusarviot ovat vuoden sisäisiä vertailuja — eli ansa 1. Verrokkiryhmä ja edellisen vuoden sama jakso muuttavat vastauksen tyypillisesti murto-osaan alkuperäisestä.
Mihin kohtaan jakaumaa toimenpiteesi osui? Jos mittaat keskiarvoja, et näe sitä. Asiakaspoistuma, luottotappiot, vasteajat ja laatupoikkeamat asuvat kaikki jakauman hännässä.
Valvonnan ja pelotteen taloudellinen arvo. Jos olet vastuussa väärinkäytösten torjunnasta, compliance-valvonnasta tai laaduntarkastuksesta, sama kysymys toistuu: paljonko valvonta oikeasti muuttaa käyttäytymistä, ja kuinka kauas se vaikuttaa? Kaistakohtainen havainto — vaikutus kohdistuu niihin, joilla on jotain menetettävää — on suoraan siirrettävissä.
Teen tämäntyyppisiä analyysejä toimeksiantoina: avoimesta datasta liiketoiminnan kannalta hyödyllistä tietoa, epävarmuus mukana ja menetelmät näkyvissä. Jos tunnistit oman kysymyksesi tuosta listasta, varaa puolen tunnin keskustelu.
Aineisto ja toistettavuus
Analyysin data on Fintrafficin / Digitrafficin LAM-raakadataa (CC BY 4.0), nopeusvalvontakameroiden sijainnit OpenStreetMapista (ODbL) ja säähavainnot Ilmatieteen laitokselta. Kaikki on vapaasti saatavilla, ja koodi on tämän sivun koodilohkoissa.
Jos haluat toistaa analyysin, tarvitset 22 mittauspisteen raakadatan 328 päivältä. Latausskripti ja tiivistysvaihe ovat olennaisia: tunnin tarkkuudella pidetty nopeushistogrammi kasvaa noin 40 miljoonaan riviin, joten se kannattaa tiivistää päivätasolle jo latauksen yhteydessä.
R version 4.5.1 (2025-06-13)
Platform: x86_64-pc-linux-gnu
Running under: Ubuntu 24.04.5 LTS

Matrix products: default
BLAS:   /usr/lib/x86_64-linux-gnu/openblas-pthread/libblas.so.3
LAPACK: /usr/lib/x86_64-linux-gnu/openblas-pthread/libopenblasp-r0.3.26.so;  LAPACK version 3.12.0

locale:
 [1] LC_CTYPE=C.UTF-8       LC_NUMERIC=C           LC_TIME=C.UTF-8
 [4] LC_COLLATE=C.UTF-8     LC_MONETARY=C.UTF-8    LC_MESSAGES=C.UTF-8
 [7] LC_PAPER=C.UTF-8       LC_NAME=C              LC_ADDRESS=C
[10] LC_TELEPHONE=C         LC_MEASUREMENT=C.UTF-8 LC_IDENTIFICATION=C

time zone: UTC
tzcode source: system (glibc)

attached base packages:
[1] stats     graphics  grDevices utils     datasets  methods   base

other attached packages:
 [1] ggdist_3.3.3    brms_2.23.0     Rcpp_1.1.2      patchwork_1.3.2
 [5] sf_1.1-3        qs2_0.3.1       lubridate_1.9.5 forcats_1.0.1
 [9] stringr_1.6.0   dplyr_1.2.1     purrr_1.2.2     readr_2.2.0
[13] tidyr_1.3.2     tibble_3.3.1    ggplot2_4.0.3   tidyverse_2.0.0
[17] here_1.0.2

loaded via a namespace (and not attached):
 [1] tidyselect_1.2.1     farver_2.1.2         loo_2.10.1
 [4] S7_0.2.2             fastmap_1.2.0        tensorA_0.36.2.1
 [7] stringfish_0.19.2    digest_0.6.39        timechange_0.4.0
[10] lifecycle_1.0.5      StanHeaders_2.39.1   processx_3.9.0
[13] magrittr_2.0.5       posterior_1.7.0      compiler_4.5.1
[16] rlang_1.3.0          tools_4.5.1          yaml_2.3.12
[19] knitr_1.52           labeling_0.4.3       bridgesampling_1.2-1
[22] htmlwidgets_1.6.4    curl_8.1.0           pkgbuild_1.4.8
[25] classInt_0.4-11      RColorBrewer_1.1-3   abind_1.4-8
[28] KernSmooth_2.23-26   withr_3.0.3          grid_4.5.1
[31] stats4_4.5.1         e1071_1.7-17         inline_0.3.21
[34] scales_1.4.0         cli_3.6.6            mvtnorm_1.4-2
[37] rmarkdown_2.32       generics_0.1.4       otel_0.2.0
[40] RcppParallel_6.2.1   tzdb_0.5.0           DBI_1.3.0
[43] proxy_0.4-29         rstan_2.32.7         bayesplot_1.16.0
[46] parallel_4.5.1       matrixStats_1.5.0    vctrs_0.7.3
[49] V8_8.2.0             Matrix_1.7-3         jsonlite_2.0.0
[52] callr_3.8.0          hms_1.1.4            units_1.0-1
[55] glue_1.8.1           ps_1.9.3             codetools_0.2-20
[58] distributional_0.9.0 stringi_1.8.9        gtable_0.3.6
[61] QuickJSR_1.11.0      pillar_1.11.1        htmltools_0.5.9
[64] Brobdingnag_1.3-1    R6_2.6.1             rprojroot_2.1.1
[67] evaluate_1.0.5       lattice_0.22-7       backports_1.5.1
[70] rstantools_2.7.1     class_7.3-23         coda_0.19-4.1
[73] gridExtra_2.3.1      nlme_3.1-168         checkmate_2.3.4
[76] xfun_0.61            pkgconfig_2.0.3