Kun Kehä I:n nopeusvalvonta käynnistyi uudelleen elokuun lopussa 2026, ylitysosuus laski. Mutta kysymys “kuinka paljon” on vähemmän kiinnostava kuin kysymys “keneltä”.
Jos valvonta hidastaa niitä, jotka ajoivat vaarallisen kovaa, se tekee tehtävänsä. Jos se hidastaa niitä, jotka ajoivat jo valmiiksi rauhallisesti, se tuottaa harmia ilman turvallisuushyötyä. Keskiarvo ei erota näitä toisistaan.
Tämä osa purkaa vaikutuksen osiin kolmella tavalla: kaistoittain, kellonajan mukaan ja ajoneuvoluokittain. Lopuksi katson, keitä ne ovat, jotka yhä ylittävät rajan reilusti — ja käyn läpi yhden yleisen väärinkäsityksen siitä, mitä hierarkkinen malli korjaa.
Kaistat kaikilla pisteillä
Kaistanumerot eivät tarkoita samaa eri mittauspisteillä. Jollain pisteellä kaista 1 on oikeanpuoleisin, toisella kaista 4 on vasemmanpuoleisin toiseen suuntaan. Numeroita ei siis voi verrata suoraan.
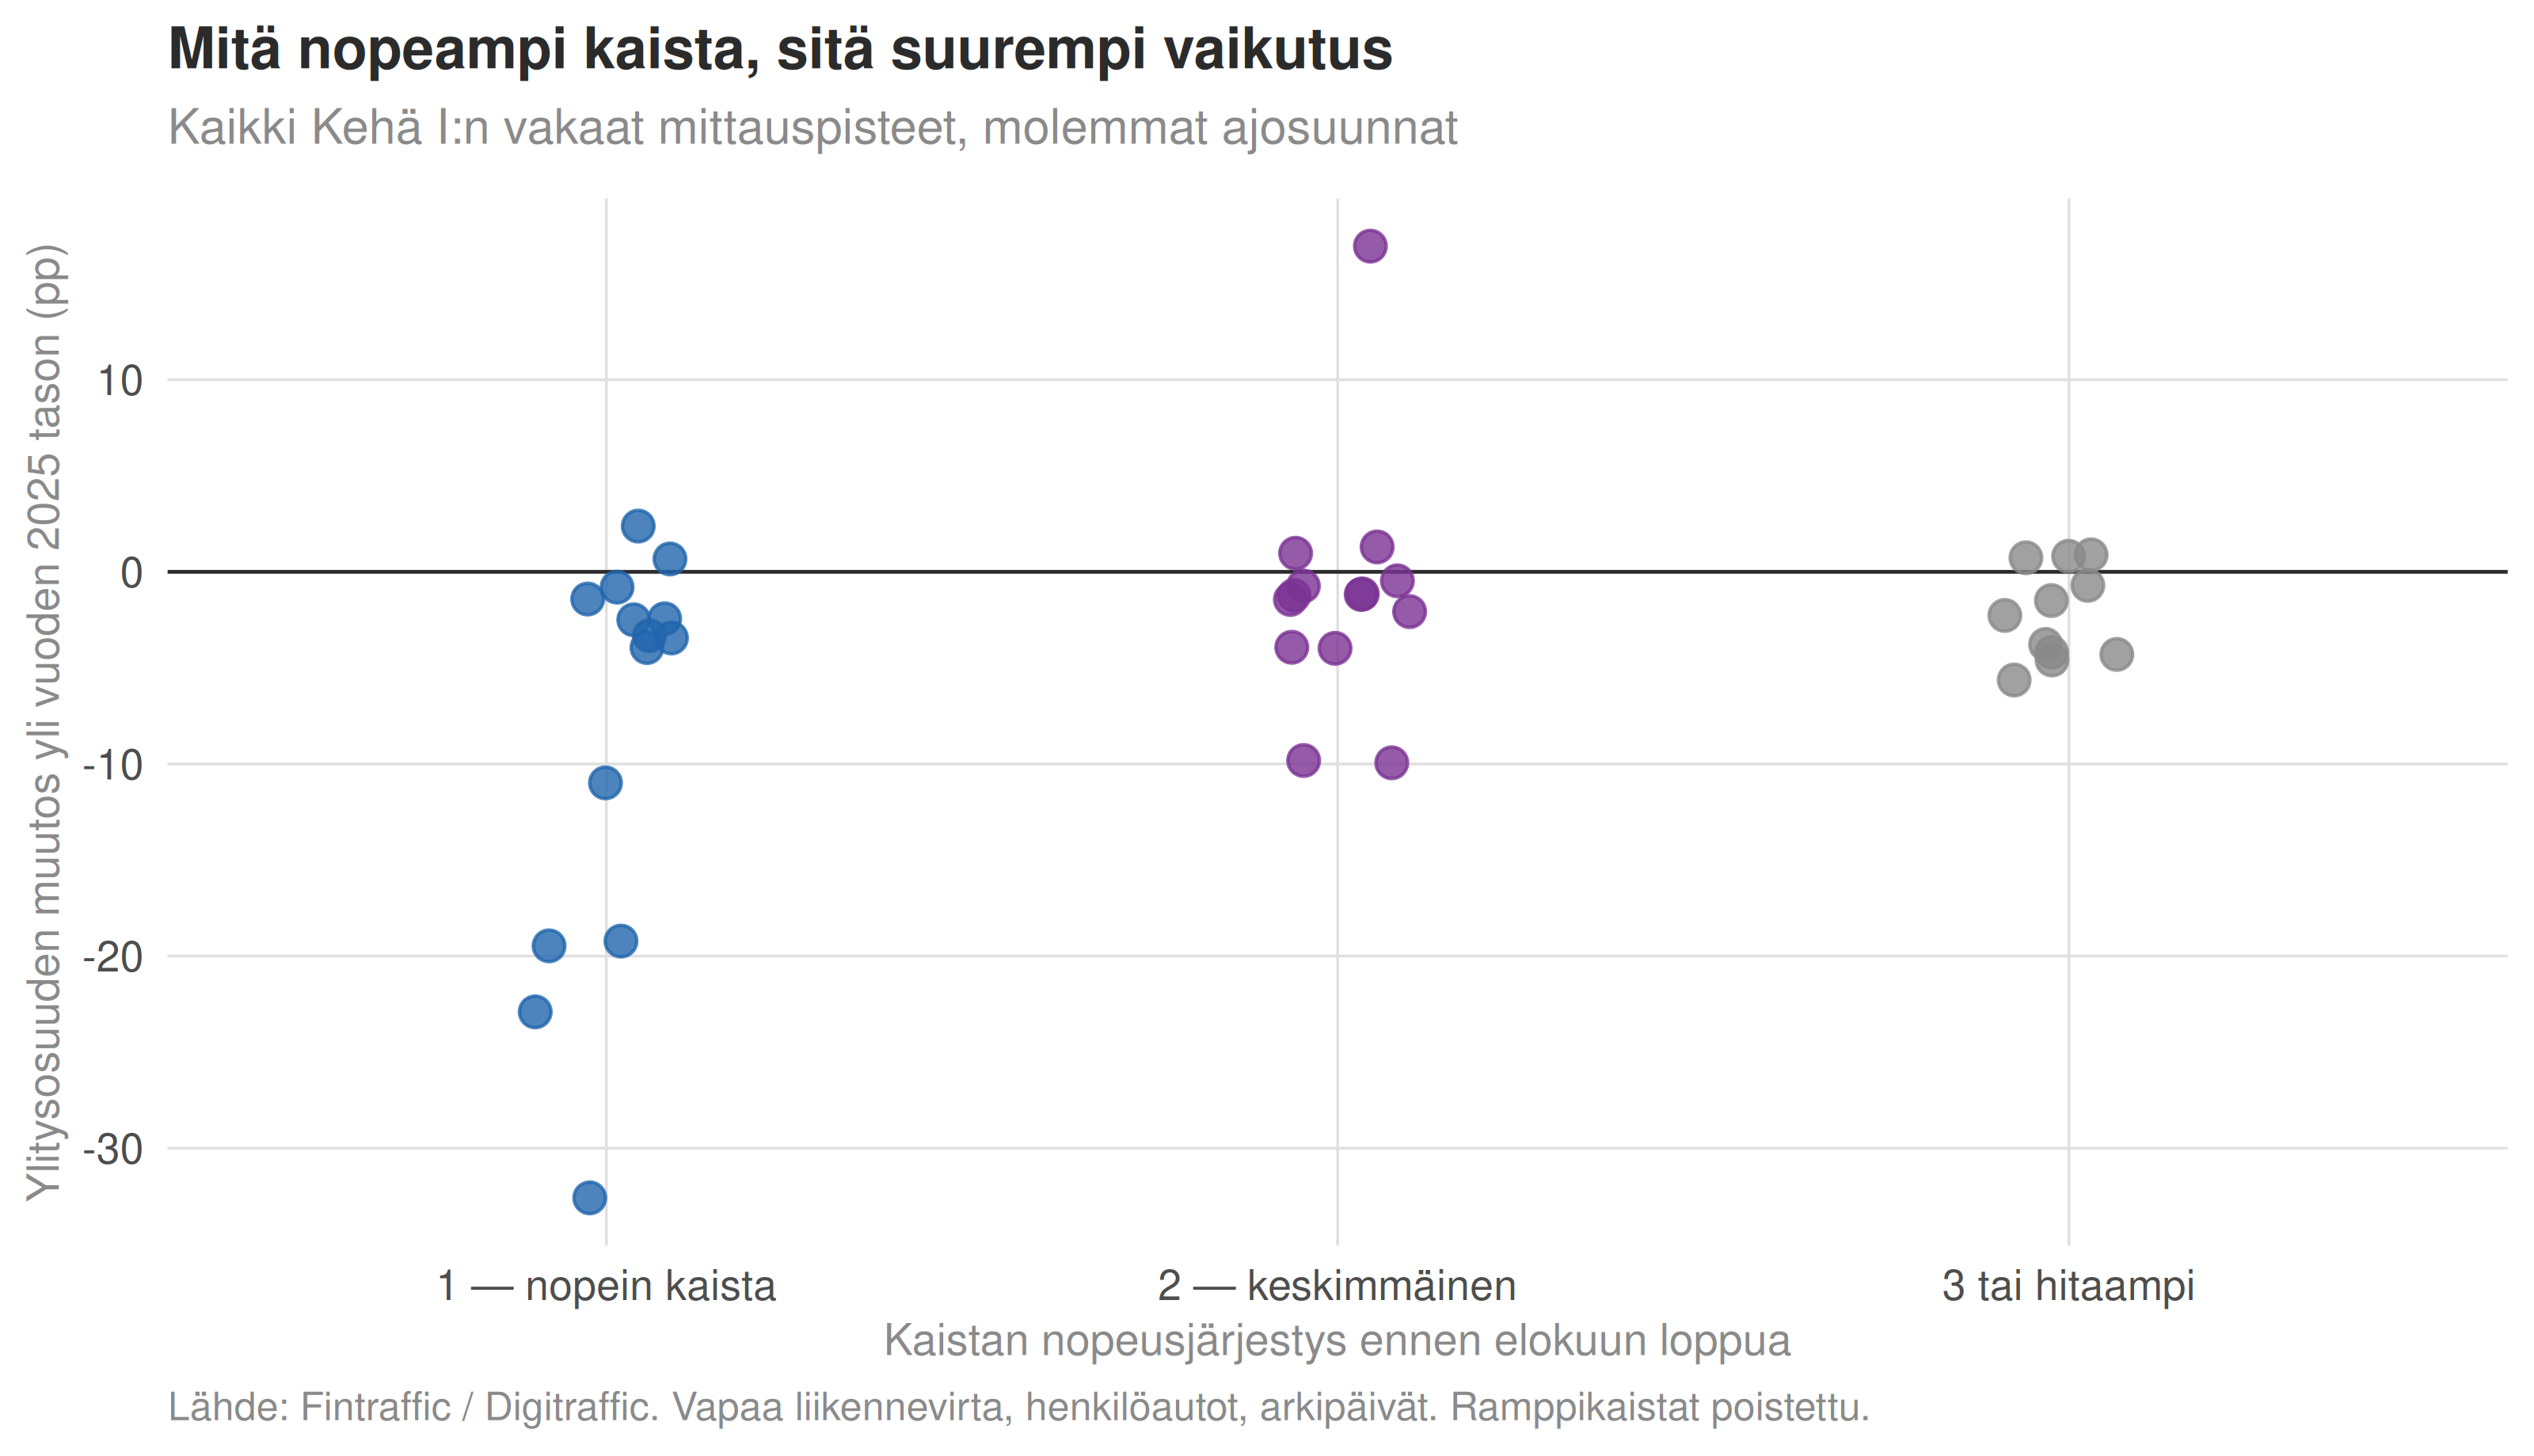
Ratkaisu on järjestää kaistat niiden oman nopeuden mukaan. Lasken jokaiselle mittauspisteelle ja suunnalle, mikä kaista oli nopein ennen elokuun loppua, ja annan sille järjestysluvun 1. Toiseksi nopein saa luvun 2 ja niin edelleen. Näin “nopein kaista” tarkoittaa samaa asiaa kaikkialla riippumatta numeroinnista.
Pudotan pois kaistat, joiden osuus suunnan liikenteestä on alle viisi prosenttia. Ne ovat liittymä- ja ramppikaistoja, joilla nopeus kertoo liittymän geometriasta eikä kuljettajan valinnasta.
Nopeimmilla kaistoilla ylitysosuus laski keskimäärin -8.57 prosenttiyksikköä yli vuoden 2025 tason, muilla kaistoilla -1.65. Suhde on 5.2-kertainen.
Ensimmäisessä osassa sama suhde laskettiin yhdeltä mittauspisteeltä. Nyt se on laskettu kaikilta, ja kuvio toistuu.
Tämä on tärkeä havainto kahdesta syystä. Turvallisuuden kannalta: vaikutus kohdistuu sinne, missä nopeudet olivat suurimmat, eli sinne missä onnettomuuden seuraukset olisivat vakavimmat. Menetelmän kannalta: tien kaventaminen tai nopeusrajoituksen lasku hidastaisi kaikkia kaistoja suunnilleen yhtä paljon. Kaistojen välinen ero on se, mikä erottaa valvonnan muista selityksistä.
Kellonaika
Yöllä tie on tyhjä ja ylinopeudet ovat suurimmillaan. Ruuhka-aikaan nopeutta rajoittaa liikenne, ei kuljettaja. Jos valvonta vaikuttaa kuljettajan valintaan, vaikutuksen pitäisi olla suurin silloin, kun kuljettajalla on valinnanvaraa.
Leppäsolmun pisteeltä on tallessa tuntitason jakaumat, joten siltä voin laskea ylitysosuuden tunneittain tarkasti.
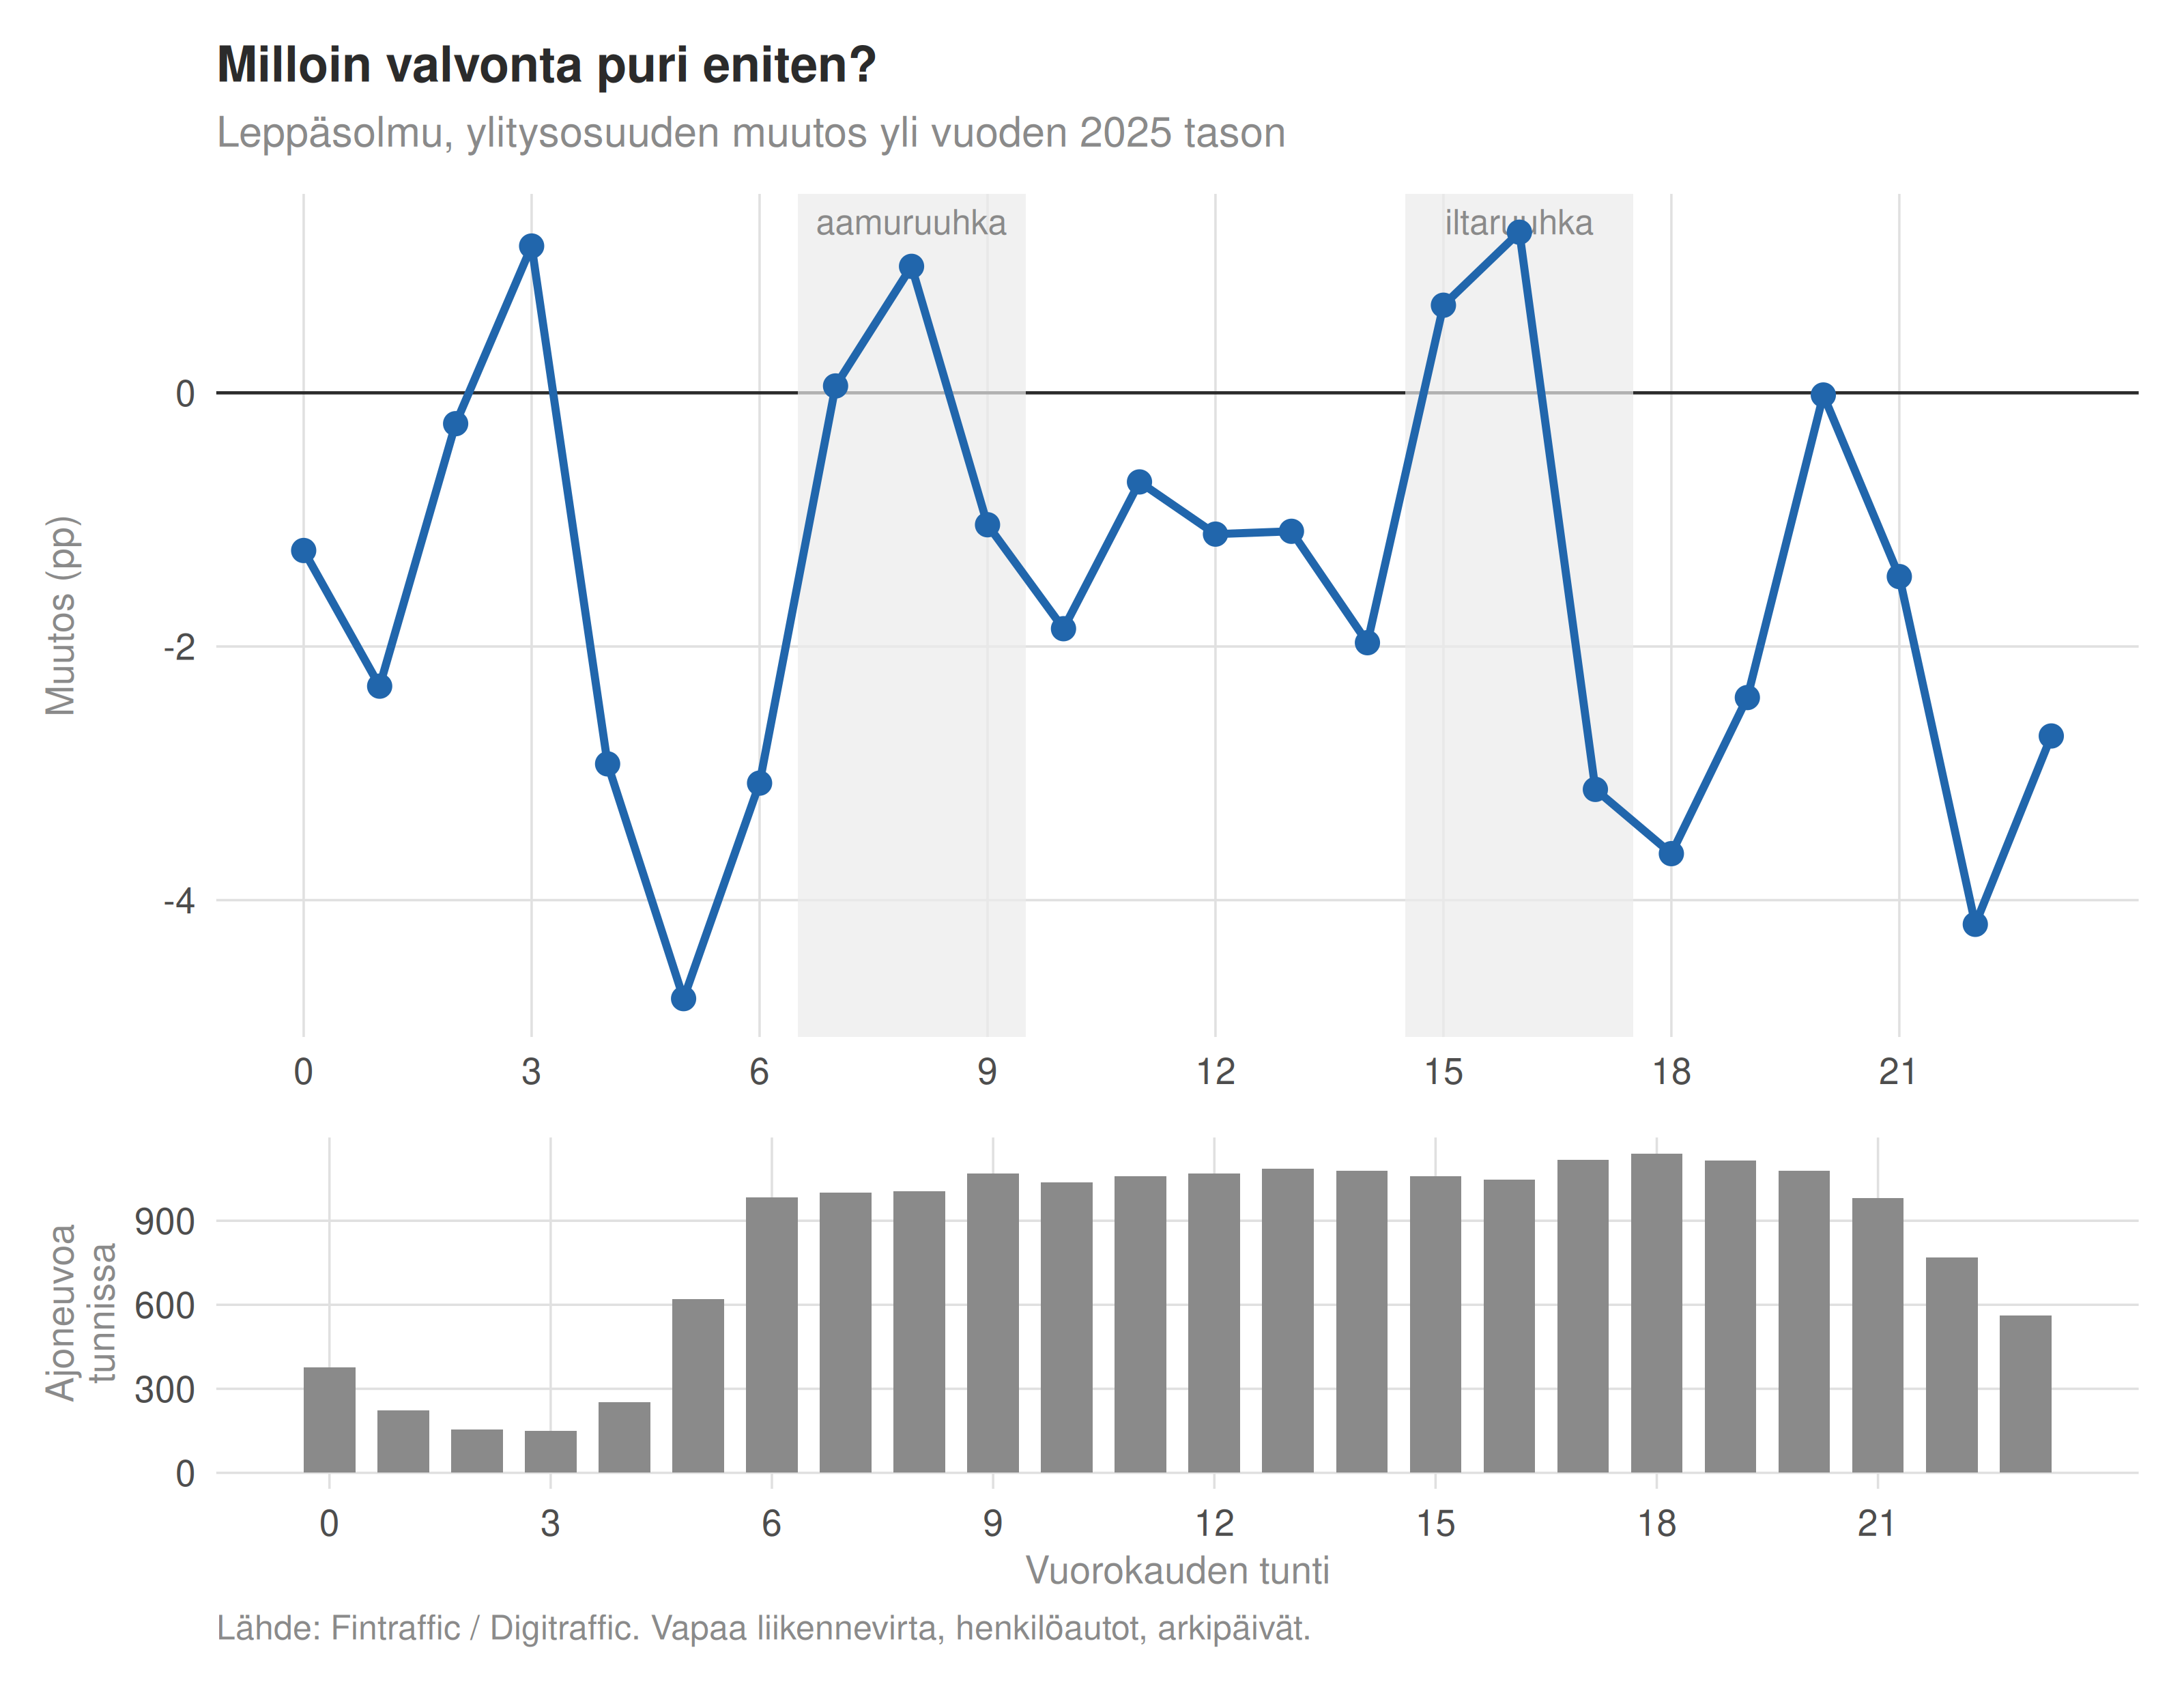
Tuntitason luvut ovat levottomia, koska yötunneilla havaintoja on vähän. Siksi sama asia kannattaa katsoa myös karkeammalla jaolla, jossa jokaisessa luokassa on riittävästi dataa — ja kaikilta Kehä I:n pisteiltä, ei vain yhdeltä.
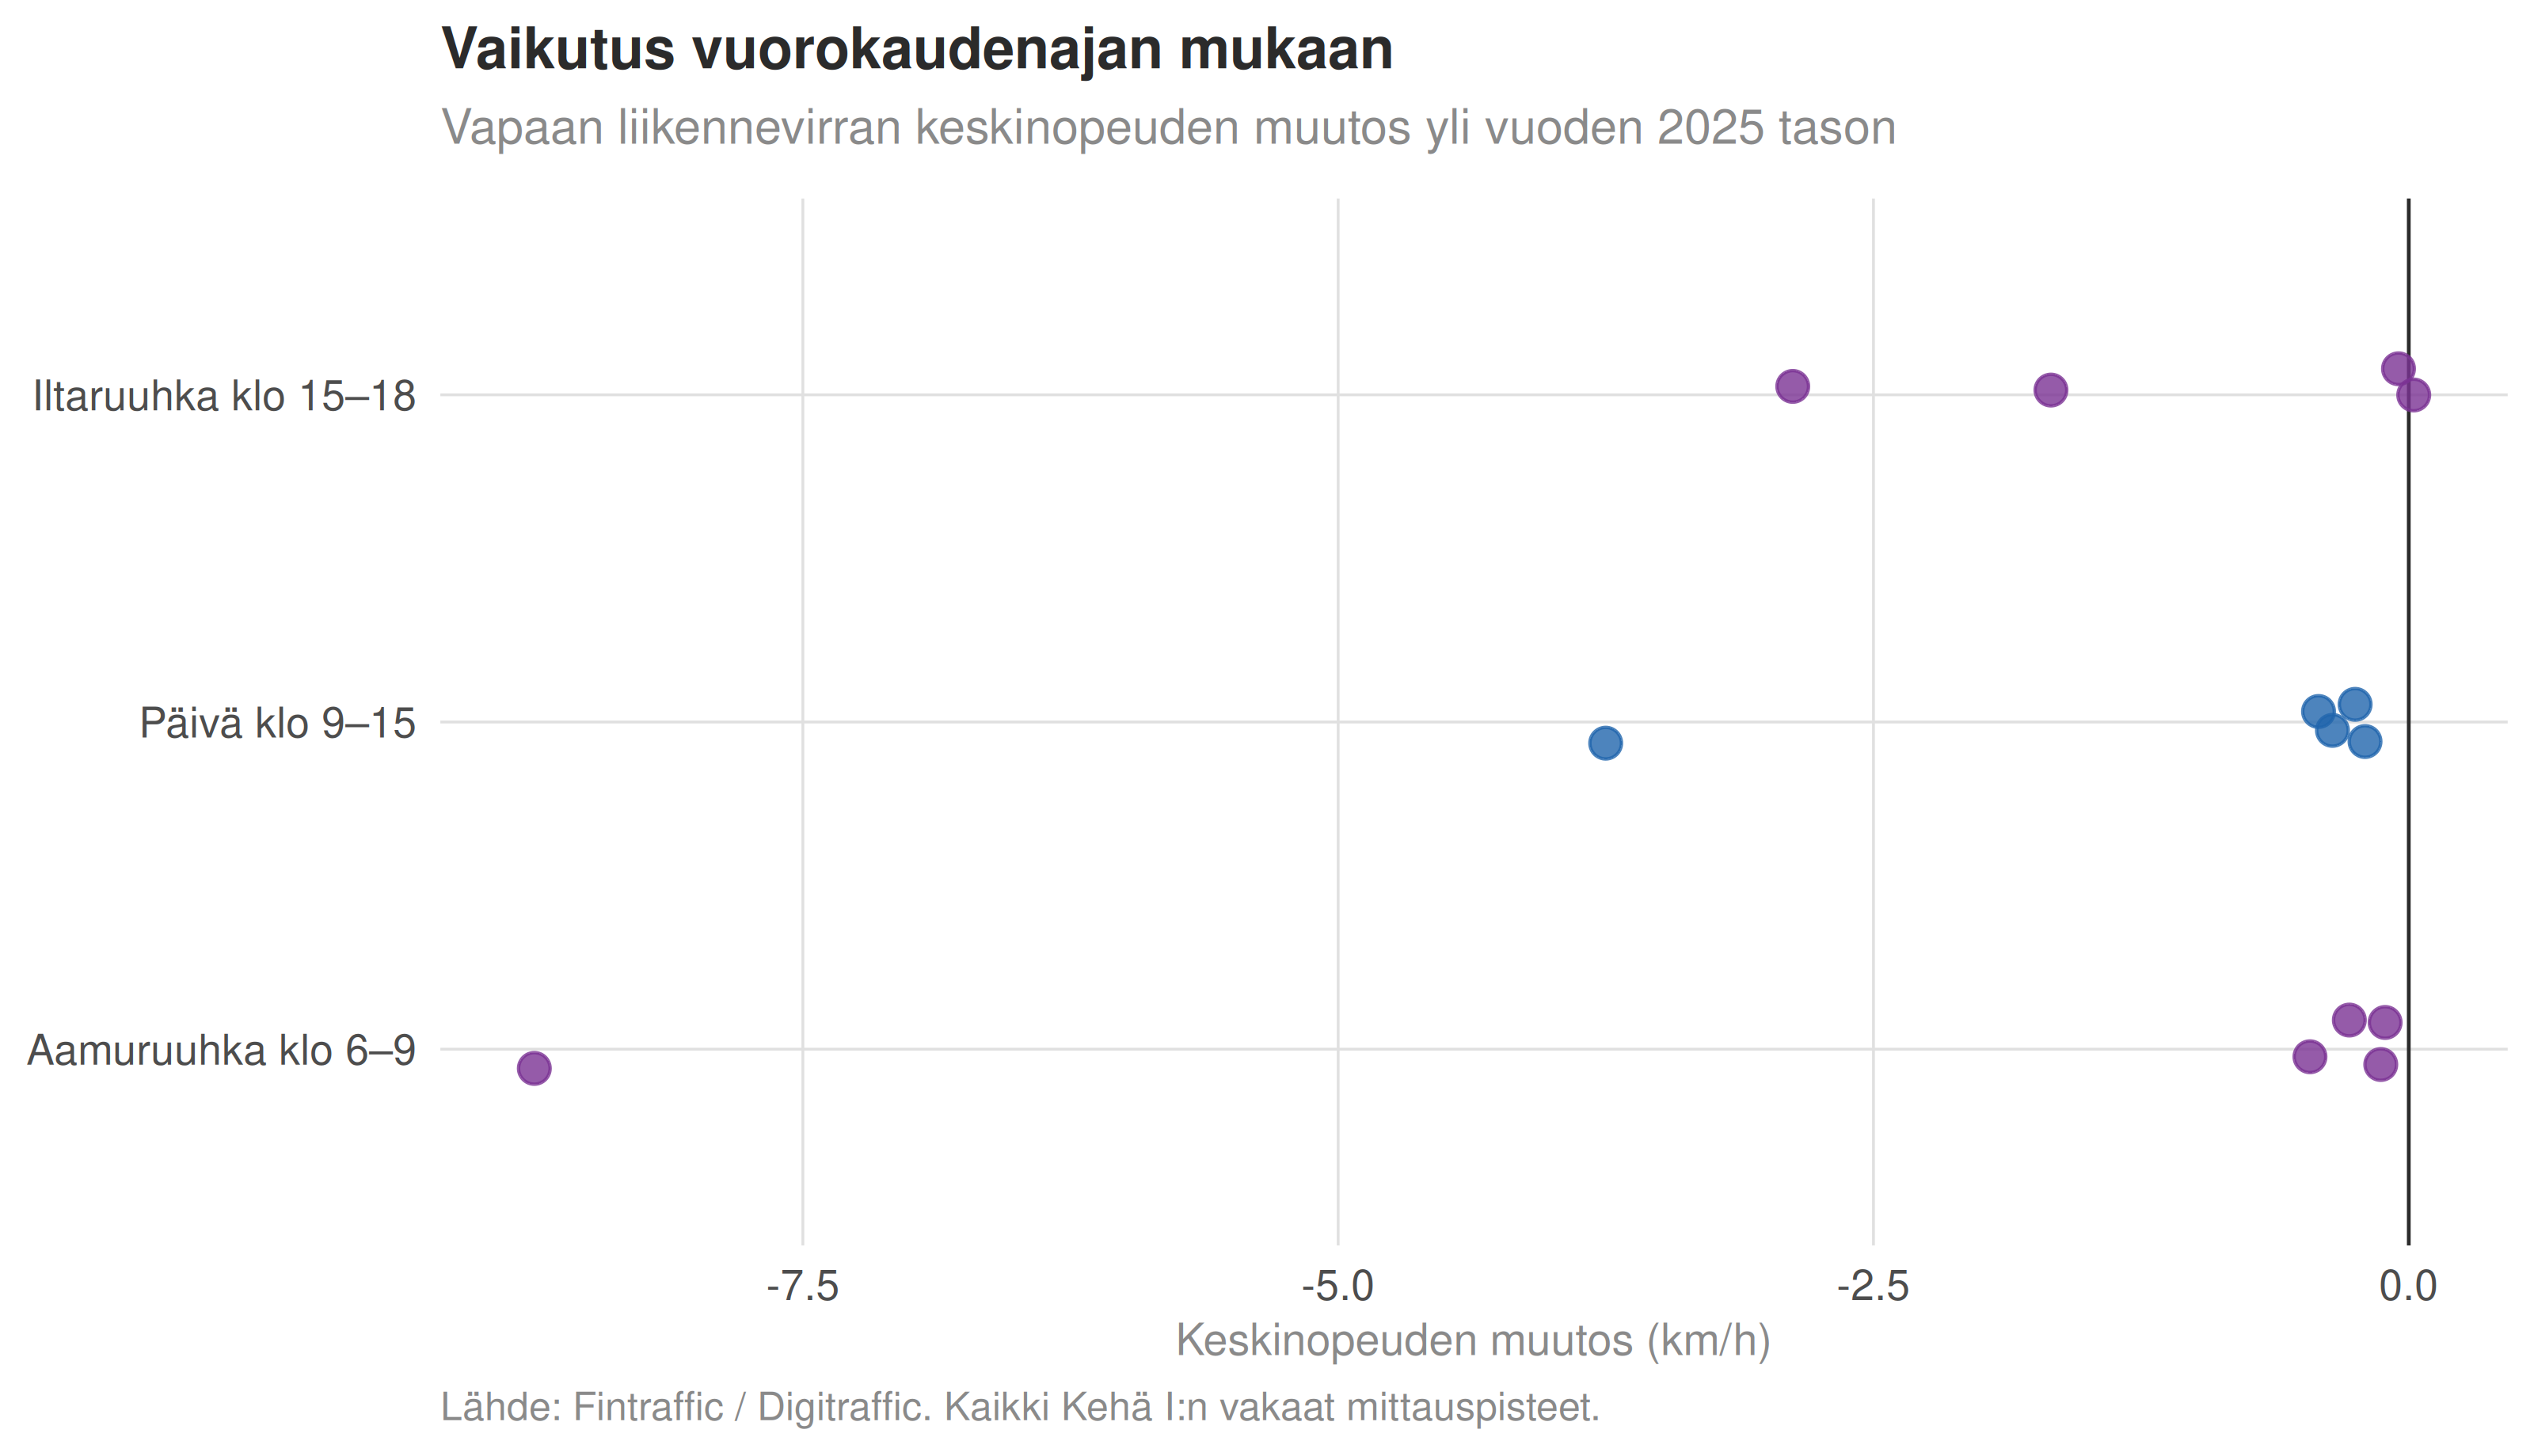
Suurin muutos osuu luokkaan Päivä klo 9–15 (-1.00 km/h) ja pienin luokkaan Iltaruuhka klo 15–18 (NA km/h).
Ajoneuvoluokka
Raskaalla kalustolla on omat nopeusrajoituksensa ja ajopiirturi, joka tallentaa nopeudet joka tapauksessa. Jos valvonnan pelotevaikutus toimii, sen pitäisi vaikuttaa vähemmän niihin, joita valvotaan jo muutenkin.
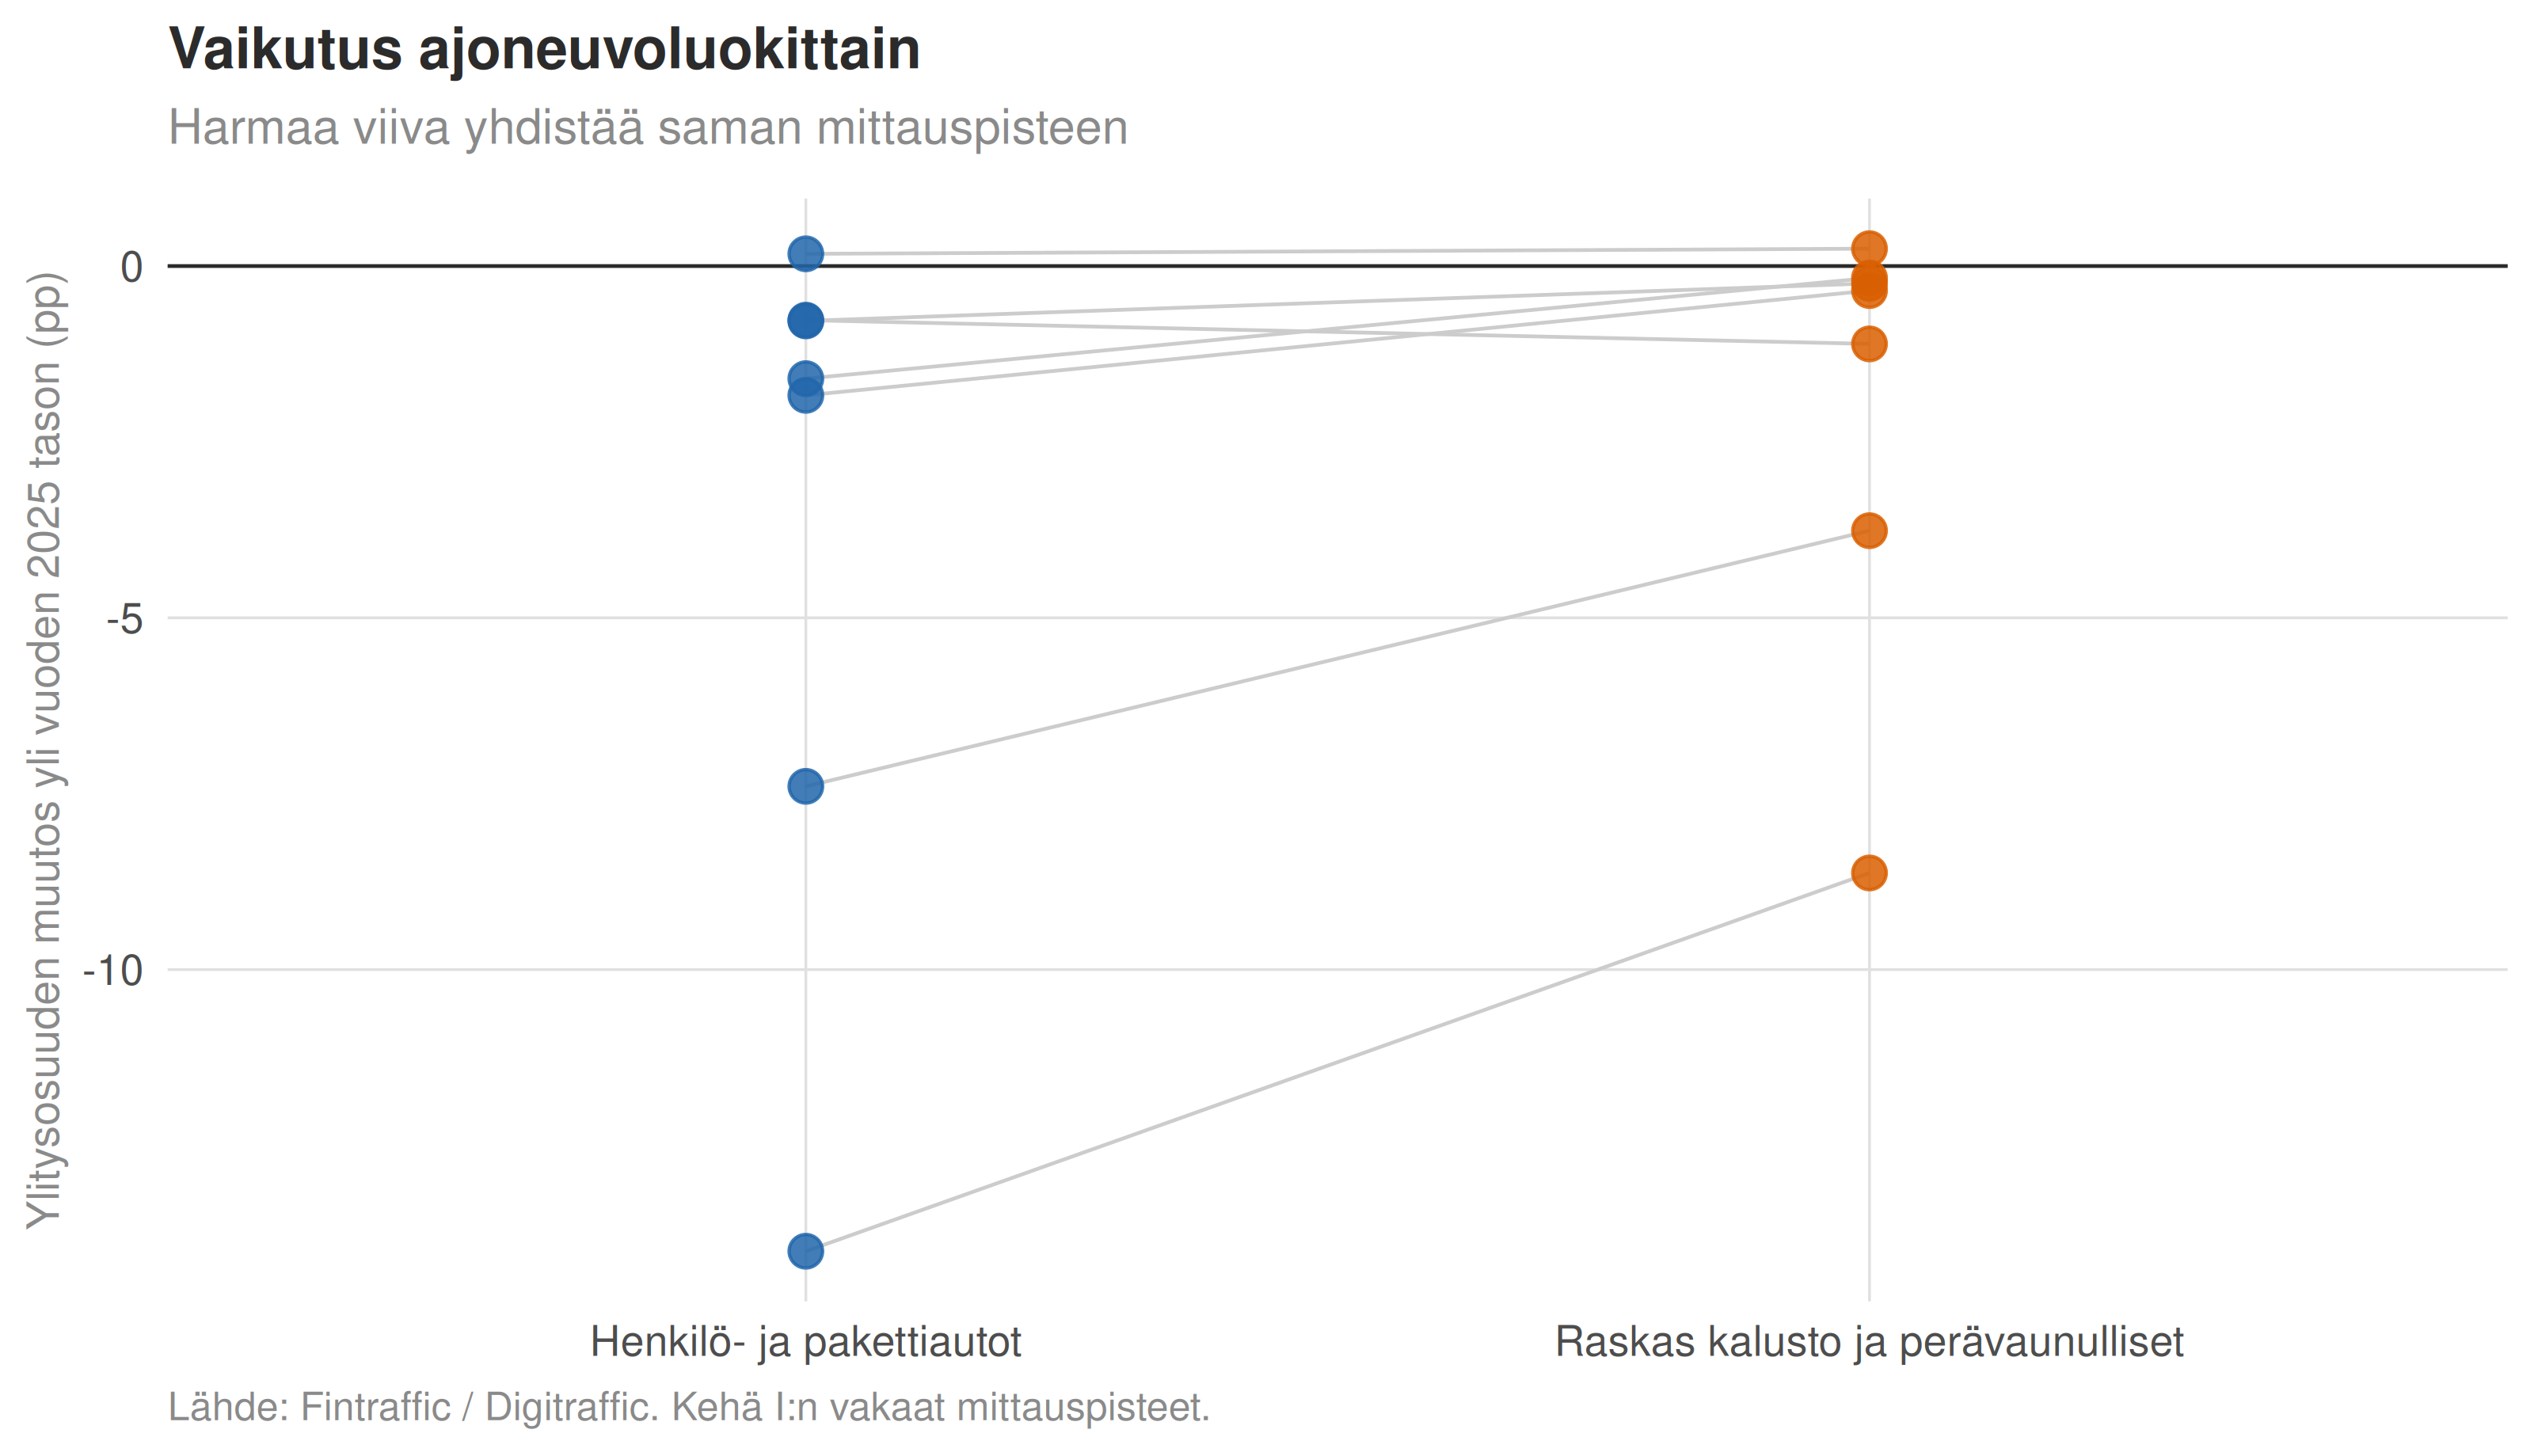
Vertailu on parittainen: jokaiselta mittauspisteeltä verrataan henkilöautojen muutosta saman pisteen raskaan kaluston muutokseen. Näin tien, sään ja liikenteen vaikutukset kumoutuvat, koska molemmat luokat kokivat ne samalla tiellä samaan aikaan.
Käytän Wilcoxonin merkittyjen sijalukujen testiä enkä t-testiä, koska mittauspisteitä on vain 7 eikä erotusten normaalijakautuneisuutta voi näin pienellä aineistolla tarkistaa luotettavasti. Sijalukutesti ei oleta jakaumasta mitään.
Erotuksen mediaani on -1.43 prosenttiyksikköä (p = 0.052, vaikutuskoko r = 0.73).
P-arvo kertoo, kuinka epätodennäköistä havaittu ero olisi, jos todellista eroa ei olisi. Se ei kerro, kuinka suuri ero on. Siksi mukana on vaikutuskoko r, joka asettuu välille 0–1: noin 0,1 on pieni, 0,3 keskisuuri ja 0,5 suuri.
Keitä ovat ne, jotka yhä ylittävät
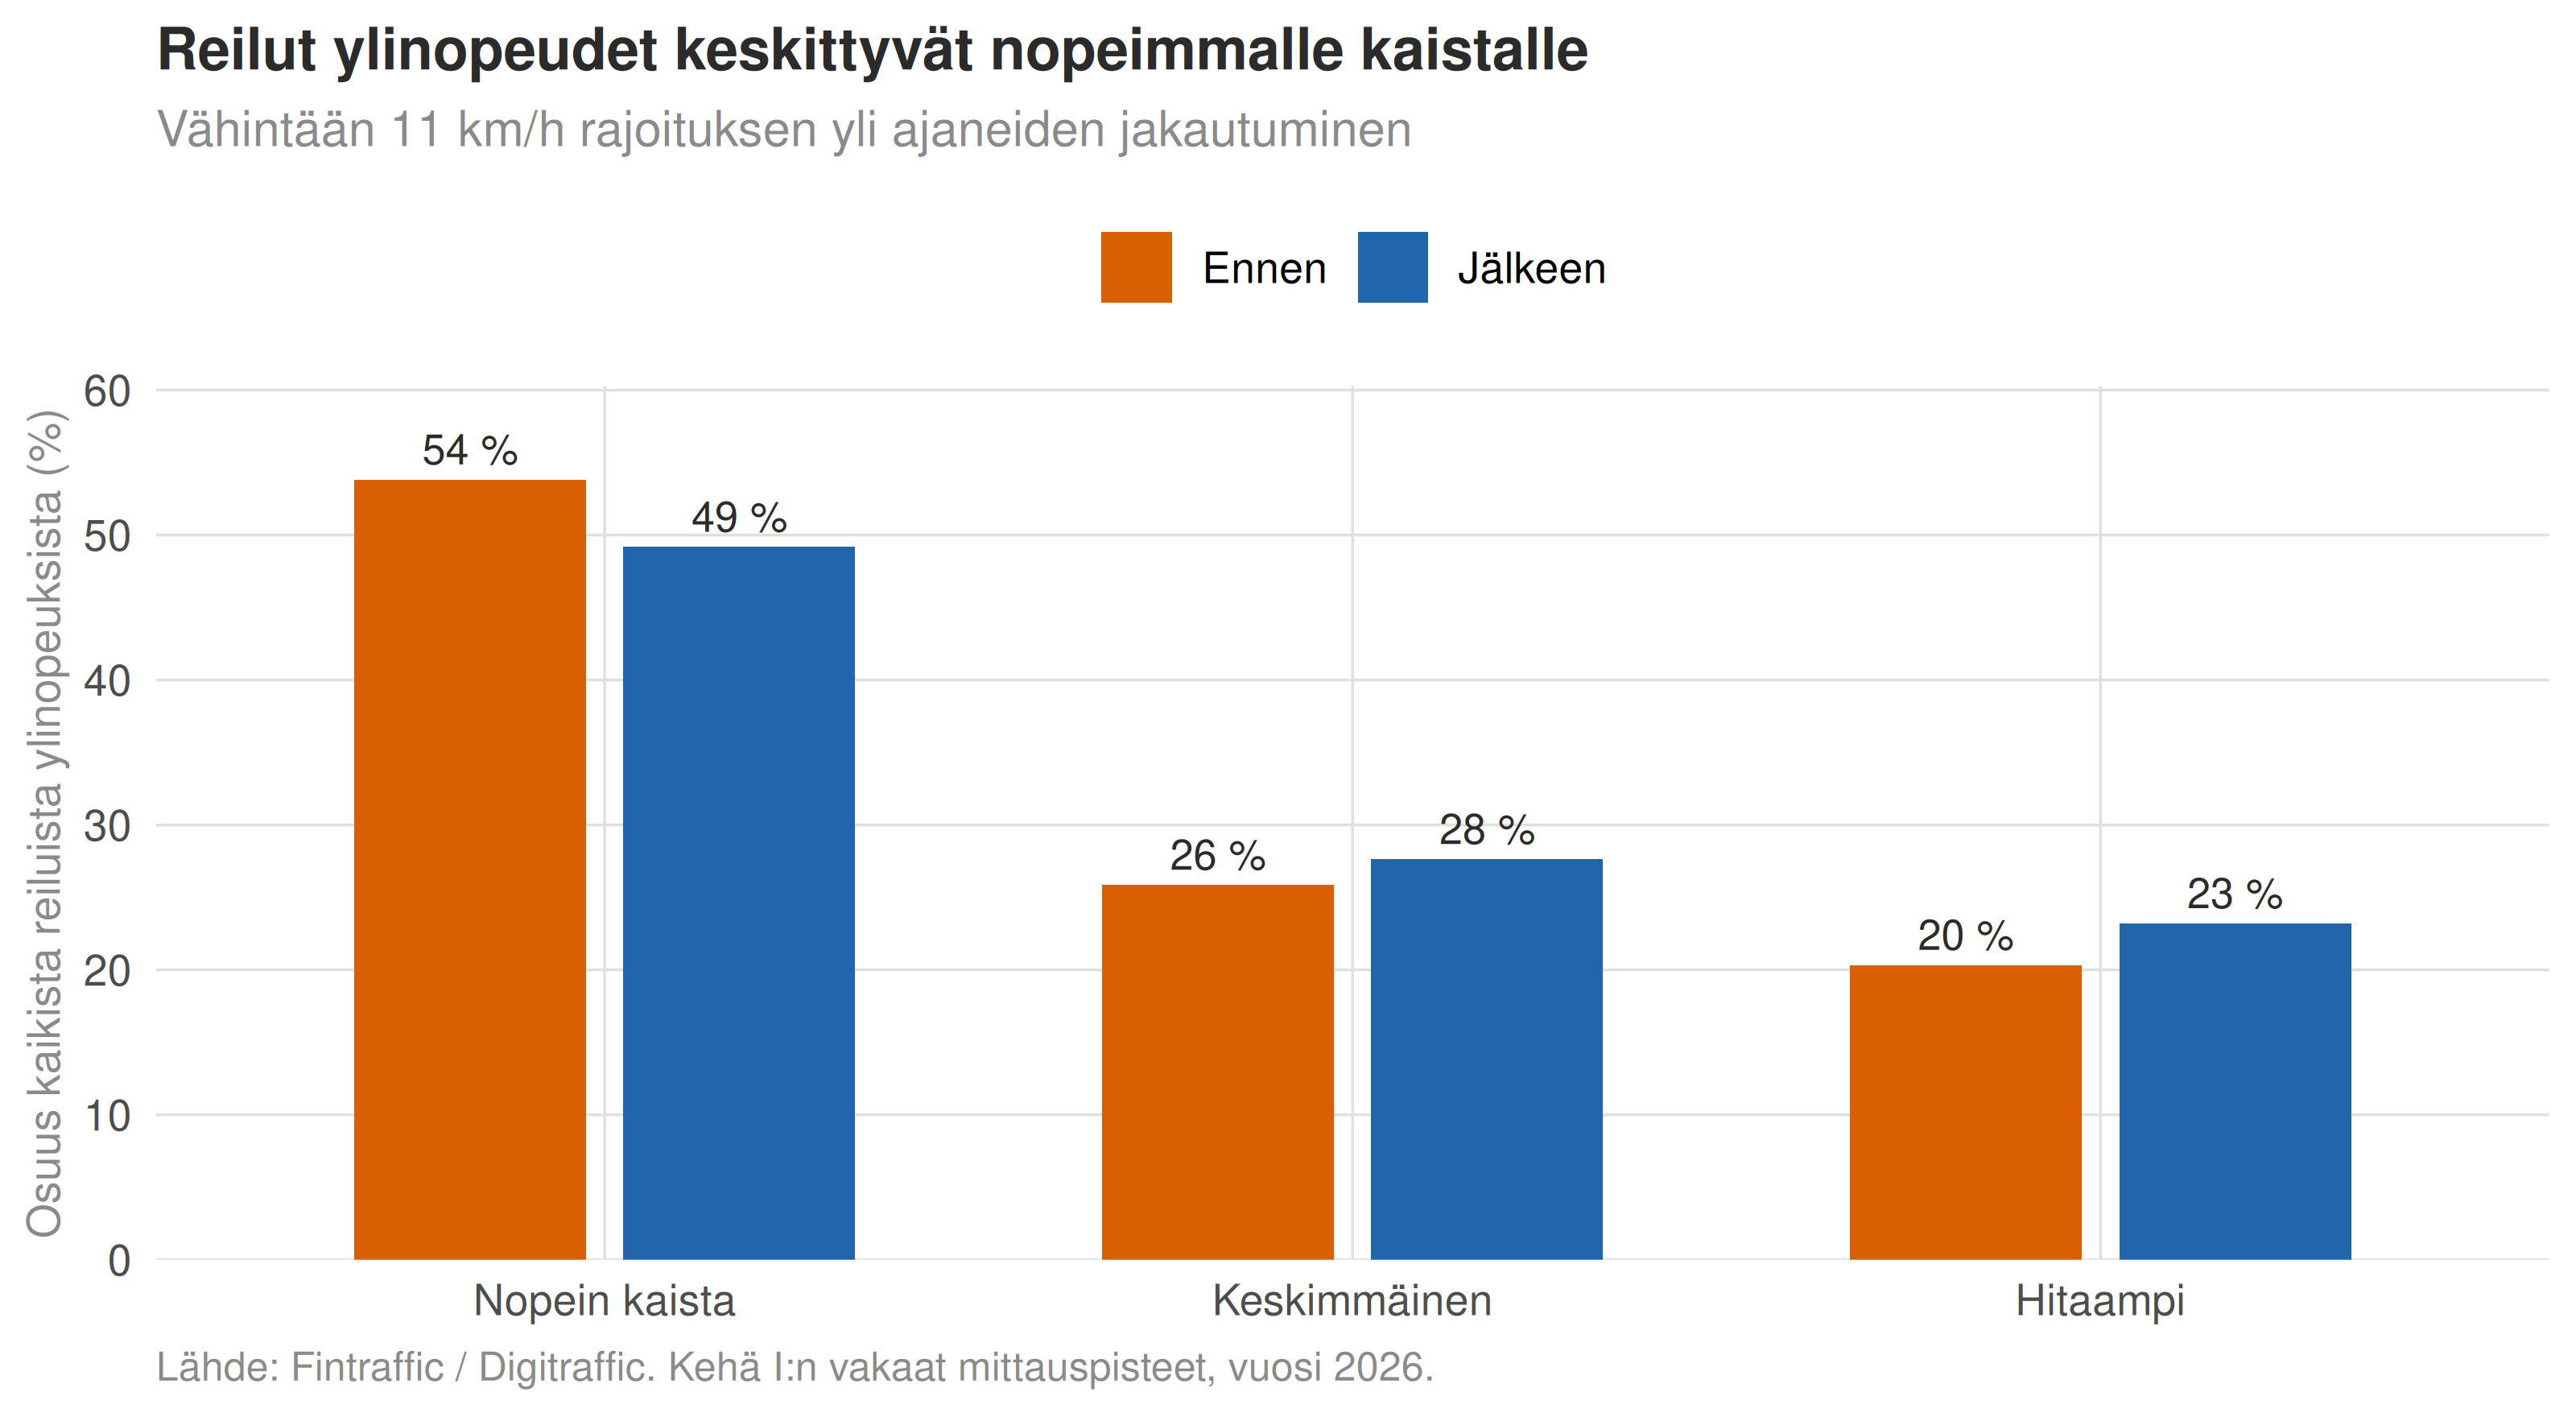
Valvonta ei poistanut ylinopeuksia. Se pienensi niiden osuutta. Keitä jäljelle jääneet ovat?
Mitä hierarkkinen malli korjaa — ja mitä ei
Tässä sarjassa on käytetty hierarkkisia malleja, joissa jokainen mittauspiste saa oman tasonsa mutta lainaa tietoa muilta. Vaikutus on se, että yksittäisen pisteen poikkeuksellinen arvio kutistuu kohti ryhmän keskiarvoa. Mitä vähemmän pisteellä on dataa, sitä enemmän se kutistuu.
Tämä on usein juuri oikea korjaus. Mutta siitä seuraa väärinkäsitys, joka kannattaa purkaa auki.
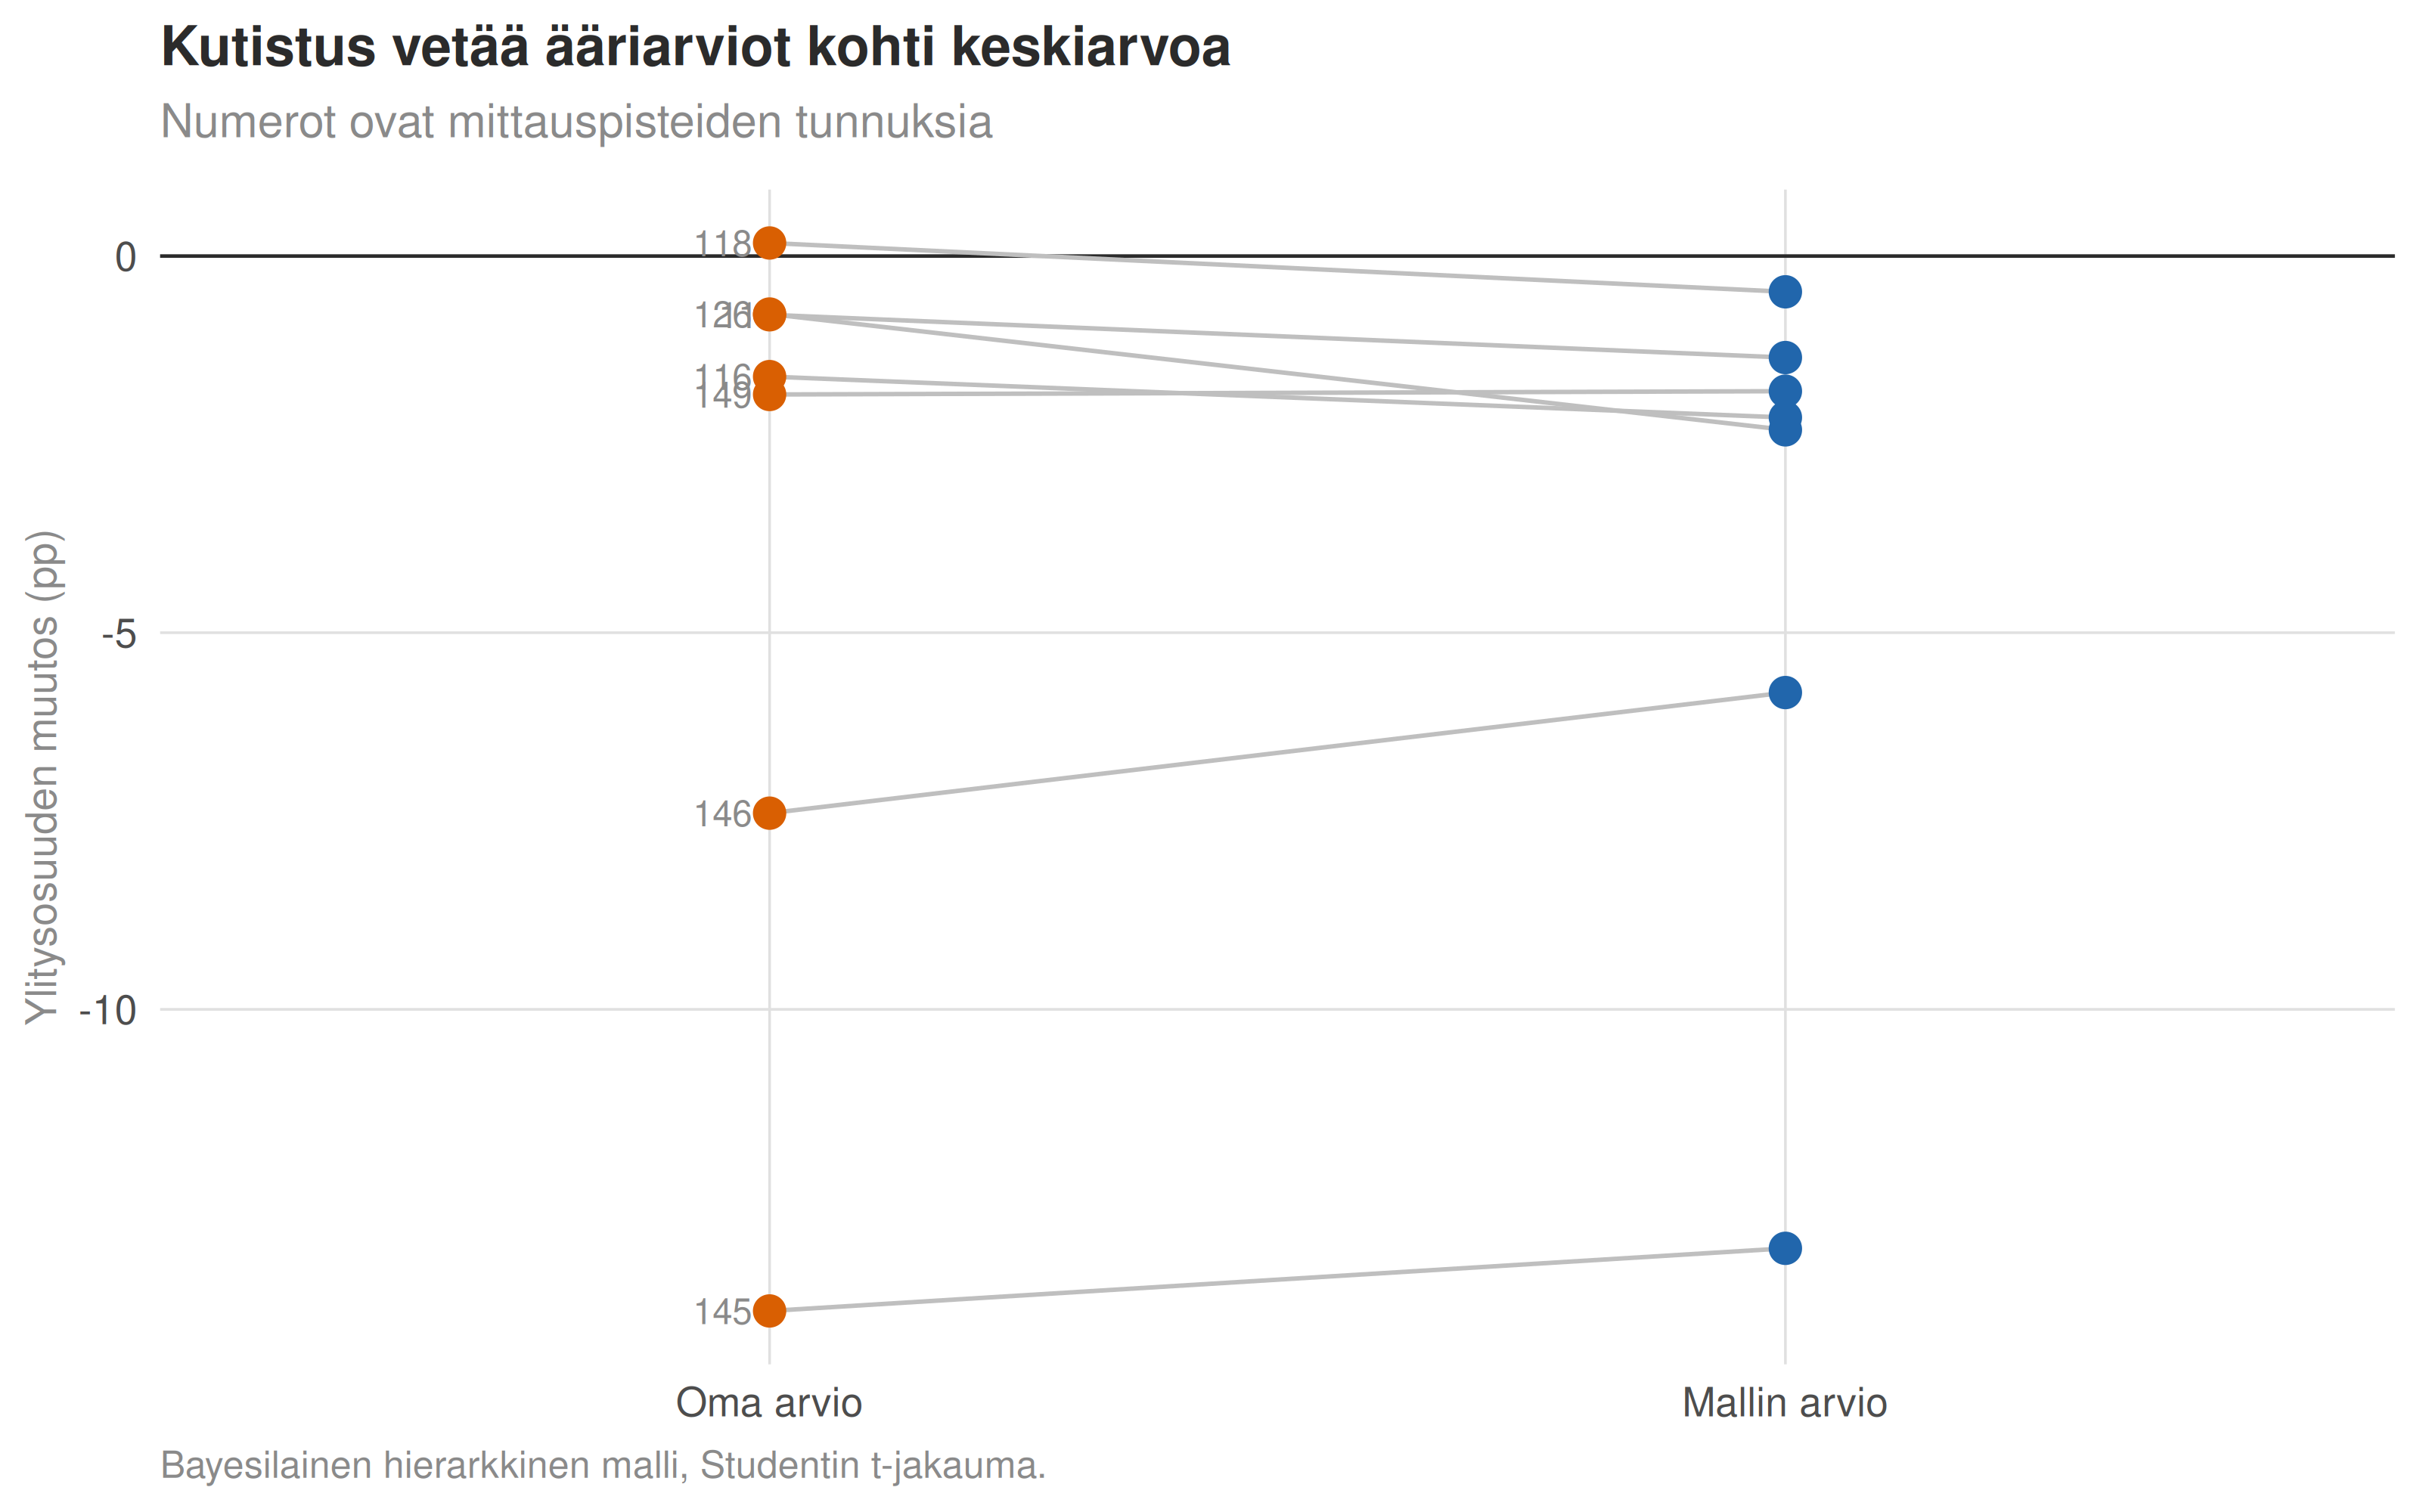
Kutistus auttaa, kun poikkeava arvio johtuu satunnaisuudesta — pisteellä on vähän havaintoja tai kohina on suurta, ja ääriarvo on todennäköisesti onnenkauppaa. Silloin kutistettu arvio on keskimäärin lähempänä totuutta kuin raaka arvio.
Kutistus ei auta, kun poikkeava arvio johtuu siitä, että pisteellä tapahtui oikeasti jotain muuta. Jos tielle tuli työmaa, pisteen nopeudet laskivat aidosti — arvio ei ole kohinaa vaan oikea mittaus väärästä asiasta. Kutistaminen vain piilottaa ongelman: se tekee luvusta uskottavamman näköisen muuttamatta sitä, että se mittaa väärää ilmiötä.
Tämän sarjan aineistossa on kaksi mittauspistettä, joilla keskinopeus laski yli kymmenen kilometriä tunnissa vuoden takaisesta liikennemäärän pysyessä ennallaan. Yksikään kansainvälinen meta-analyysi ei raportoi kameravalvonnasta sen kokoluokan vaikutusta. Ne ovat siis mitä todennäköisimmin jotain muuta — työmaa tai rajoitusmuutos.
Oikea hoito niille ei ole kutistus vaan sulkeminen pois tai erillinen selitys. Tilastollinen menetelmä ei korvaa sitä, että katsoo mitä maastossa tapahtui.
NoteFaktalaatikko: kenelle valvonta vaikuttaa
Vaikutus painottuu nopeimpiin. Tuore systemaattinen katsaus (Accident Analysis & Prevention 2026) kokosi 94 tutkimusta ja sai kameran välittömän läheisyyden yhdistetyksi nopeusvaikutukseksi −7,57 km/h (95 %:n luottamusväli −10,48…−4,66). Katsaus nostaa esiin, että vaikutuksen mittaaminen pelkällä keskinopeudella kadottaa sen, että muutos keskittyy jakauman yläpäähän.
Onnettomuusvaikutus. Alena Høyen meta-analyysi (Accident Analysis & Prevention 2014) kokosi 63 vaikutusarviota 15 tutkimuksesta: kiinteät nopeuskamerat vähensivät onnettomuuksia noin 20 %. Kuolemaan johtaneissa vähenemä oli 51 %, mutta siihen voi sisältyä keskiarvoon palautumisen harhaa, koska kameroita asennetaan paikkoihin joissa on juuri sattunut poikkeuksellisen paljon onnettomuuksia.
Miksi yläpää ratkaisee. Elvikin potenssimallin mukaan 10 %:n lasku keskinopeudessa vähentää kuolemaan johtaneita onnettomuuksia keskimäärin 35 % ja loukkaantumisiin johtaneita 16 %. Suhde on jyrkästi epälineaarinen, eli nopeimpien hidastaminen tuottaa selvästi enemmän turvallisuutta kuin saman kilometrimäärän ottaminen pois jo valmiiksi rauhallisilta.
Mitä data ei kerro
Kaistajärjestys on määritelty samasta aineistosta. Nopein kaista valittiin ennen-jakson nopeuksien perusteella, ja samaa jakoa käytettiin muutoksen mittaamiseen. Jos kaistan nopeus ennen-jaksolla oli poikkeuksellisen korkea sattumalta, se näyttää jälkeen-jaksolla laskevan keskiarvoon palautumisen vuoksi. Tämä harha vetää tulosta siihen suuntaan, joka havaittiin. Vaikutus on todennäköisesti pieni, koska ennen-jaksossa on kuusi viikkoa ja miljoonia havaintoja, mutta se ei ole nolla.
Tuntitason tulokset ovat yhdeltä pisteeltä. Tuntijakaumat tallennettiin vain Leppäsolmun pisteeltä, joten kellonaikaprofiili on yhden paikan profiili. Muiden pisteiden osalta käytössä on karkeampi neljän luokan jako ja keskinopeus ylitysosuuden sijasta.
Raskaan kaluston havaintomäärä on pieni. Raskasta kalustoa on murto-osa liikenteestä, joten sen arviot ovat epävarmempia kuin henkilöautojen. Parittainen vertailu auttaa, mutta ei poista tätä.
Vuorokaudenaika ja kaista eivät ole riippumattomia. Yöllä ajetaan eri kaistoilla kuin ruuhkassa. En ole erottanut näitä toisistaan, joten osa kellonaikaerosta voi olla kaistaeroa ja päinvastoin.
ImportantMitä tällä tekee yrityksessä
Tämän osan kysymys on kohdentuminen: ketä toimenpide liikutti.
Kampanjan kohdistuminen. Jos kampanja nosti myyntiä kymmenen prosenttia, nousiko se niillä asiakkailla joita tavoiteltiin, vai niillä jotka olisivat ostaneet muutenkin? Jälkimmäinen on kallis tapa tehdä alennusta. Sama jakotapa — segmentoi ensin käyttäytymisen mukaan, mittaa vasta sitten — vastaa kysymykseen.
Hinnanmuutoksen osuvuus. Hinnankorotus vaikuttaa harvoin tasaisesti. Jos poistuma kasvaa, se kasvaa jossakin asiakassegmentissä. Keskiarvo kertoo paljonko, ei keneltä — ja vain jälkimmäinen kertoo mitä tehdä.
Valvonnan ja tarkastusten kohdentuminen. Jos vastaat compliance- valvonnasta tai laaduntarkastuksesta, kysymys on identtinen: muuttiko tarkastus niiden käyttäytymistä, joilla riski oli suurin, vai niiden joilla se oli jo valmiiksi pieni? Jälkimmäinen on hallinnollista kuormaa ilman riskivaikutusta.
Kutistuksen oikea käyttö. Hierarkkinen malli on vakiotyökalu, kun yksiköitä on paljon ja osalla niistä on vähän dataa — myymälöitä, toimipisteitä, asiakassegmenttejä, tuotteita. Mutta se korjaa kohinaa, ei harhaa. Ennen kuin kutistat poikkeavan toimipisteen luvut kohti keskiarvoa, selvitä, onko siellä tapahtunut jotain. Tilastollinen menetelmä ei korvaa maastokäyntiä.
Teen tämäntyyppisiä analyysejä toimeksiantoina. Varaa puolen tunnin keskustelu.
Aineisto ja toistettavuus
LAM-raakadata on Fintrafficin / Digitrafficin (CC BY 4.0). Kaikki laskenta on tämän sivun koodilohkoissa, ja yhteiset apufunktiot tiedostossa R/peltipoliisi-yhteiset.R.
R version 4.5.1 (2025-06-13)
Platform: x86_64-pc-linux-gnu
Running under: Ubuntu 24.04.5 LTS

Matrix products: default
BLAS:   /usr/lib/x86_64-linux-gnu/openblas-pthread/libblas.so.3
LAPACK: /usr/lib/x86_64-linux-gnu/openblas-pthread/libopenblasp-r0.3.26.so;  LAPACK version 3.12.0

locale:
 [1] LC_CTYPE=C.UTF-8       LC_NUMERIC=C           LC_TIME=C.UTF-8
 [4] LC_COLLATE=C.UTF-8     LC_MONETARY=C.UTF-8    LC_MESSAGES=C.UTF-8
 [7] LC_PAPER=C.UTF-8       LC_NAME=C              LC_ADDRESS=C
[10] LC_TELEPHONE=C         LC_MEASUREMENT=C.UTF-8 LC_IDENTIFICATION=C

time zone: UTC
tzcode source: system (glibc)

attached base packages:
[1] stats     graphics  grDevices utils     datasets  methods   base

other attached packages:
 [1] ggdist_3.3.3    brms_2.23.0     Rcpp_1.1.2      patchwork_1.3.2
 [5] sf_1.1-3        qs2_0.4.0       lubridate_1.9.5 forcats_1.0.1
 [9] stringr_1.6.0   dplyr_1.2.1     purrr_1.2.2     readr_2.2.0
[13] tidyr_1.3.2     tibble_3.3.1    ggplot2_4.0.3   tidyverse_2.0.0
[17] here_1.0.2

loaded via a namespace (and not attached):
 [1] tidyselect_1.2.1     libcoin_1.0-13       farver_2.1.2
 [4] loo_2.10.1           S7_0.2.2             fastmap_1.2.0
 [7] TH.data_1.1-5        tensorA_0.36.2.1     digest_0.6.39
[10] timechange_0.4.0     lifecycle_1.0.5      StanHeaders_2.39.1
[13] survival_3.8-3       magrittr_2.0.5       posterior_1.7.0
[16] compiler_4.5.1       rlang_1.3.0          tools_4.5.1
[19] yaml_2.3.12          knitr_1.52           labeling_0.4.3
[22] bridgesampling_1.2-1 htmlwidgets_1.6.4    curl_8.1.0
[25] pkgbuild_1.4.8       classInt_0.4-11      RColorBrewer_1.1-3
[28] multcomp_1.4-32      abind_1.4-8          KernSmooth_2.23-26
[31] withr_3.0.3          grid_4.5.1           stats4_4.5.1
[34] e1071_1.7-17         inline_0.3.21        MASS_7.3-65
[37] scales_1.4.0         cli_3.6.6            mvtnorm_1.4-2
[40] rmarkdown_2.32       generics_0.1.4       otel_0.2.0
[43] RcppParallel_6.2.1   tzdb_0.5.0           DBI_1.3.0
[46] proxy_0.4-29         rstan_2.32.7         modeltools_0.2-25
[49] splines_4.5.1        bayesplot_1.16.0     parallel_4.5.1
[52] matrixStats_1.5.0    vctrs_0.7.3          sandwich_3.1-3
[55] V8_8.2.1             Matrix_1.7-3         jsonlite_2.0.0
[58] hms_1.1.4            units_1.0-1          glue_1.8.1
[61] codetools_0.2-20     distributional_0.9.0 stringi_1.8.9
[64] gtable_0.3.6         QuickJSR_1.11.0      pillar_1.11.1
[67] htmltools_0.5.9      Brobdingnag_1.3-1    R6_2.6.1
[70] rprojroot_2.1.1      evaluate_1.0.5       lattice_0.22-7
[73] backports_1.5.1      rstantools_2.7.1     class_7.3-23
[76] charport_0.1.1       coda_0.19-4.1        gridExtra_2.3.1
[79] nlme_3.1-168         checkmate_2.3.4      coin_1.4-6
[82] xfun_0.62            zoo_1.9-1            pkgconfig_2.0.3