---
title: "Yksi sana, koko laki — mitä 'käännytyslaki' oikeasti sisältää"
subtitle: "Laki jakaumana: teemat lain omasta tekstistä, ei otsikosta"
description: >
Laki 482/2024 tunnetaan julkisuudessa yhtenä sanana. Mutta laki on teksti, ja
teksti on jakauma teemoja. Haemme lain finlex-paketilla pykälittäin, luokittelemme
jokaisen pykälän, ja vertaamme tulosta tekoälytyökalun (Skimle) teemoitukseen —
epävarmuus näkyvissä.
date: 2026-09-24
author: "Kristian Vepsäläinen"
categories: [avoin data, finlex, jakaumat, bayes, lainsäädäntö]
format:
html:
toc: true
toc-title: "Sisällys"
code-fold: true
code-summary: "Näytä koodi"
code-tools: true
execute: { warning: false, message: false, echo: true }
---
> **Idea.** Sloganini on "maailma on jakauma": yksittäinen luku tai yksittäinen sana
> kätkee yleensä enemmän kuin se paljastaa. Harva asia todistaa tämän yhtä hyvin kuin
> laki, joka julkisessa keskustelussa typistyy yhteen sanaan. Otamme sellaisen lain,
> avaamme sen tekstin pykälä pykälältä, ja katsomme minkä jakauman se oikeasti
> muodostaa.
## Uutiskoukku: laki, joka mahtuu yhteen sanaan
Kesällä 2024 eduskunta hyväksyi äänin 167–31 lain, joka tunnetaan julkisuudessa
nimellä "käännytyslaki". Sen virallinen nimi on pidempi ja kertoo enemmän: *laki
väliaikaisista toimenpiteistä välineellistetyn maahantulon torjumiseksi*
(säädösnumero 482/2024). Yksi sana — "käännytys" — on jäänyt elämään sen tilalle.
Mutta laki ei ole sana. Se on **teksti**, joka jakautuu pykäliin, ja jokainen pykälä
käsittelee jotakin. Kysymme yksinkertaisen kysymyksen: kun luetaan koko laki, mistä
se oikeasti koostuu? Ja koska tämä on juuri sellainen jakauma, jonka yksi otsikko
piilottaa, mittaamme sen — emmekä yhdellä luvulla vaan epävarmuus näkyvissä.
## Kolme tapaa mitata "mistä laki kertoo"
"Kuinka suuri osa laista käsittelee turvatakeita?" kuulostaa yksinkertaiselta, mutta
vastaus riippuu **mittarista**. Käytämme kolmea, koska niiden vertailu on itsessään
opettavaista:
1. **Tekoälyn havainnot.** Syötin lain Skimle-nimiseen teemoitustyökaluun, joka poimi
tekstistä 15 "havaintoa" ja luokitteli ne viiteen teemaan. Tämä on nopea, mutta
se on **mallin tuotos**: kone päättää, montako havaintoa mistäkin teemasta syntyy.
2. **Pykälät.** Kuinka moni lain pykälä käsittelee kutakin teemaa. Tämä on lain oma
rakenne — läpinäkyvä ja tarkistettava.
3. **Sanat.** Kuinka suuri osa lain sanamäärästä kuuluu kunkin teeman pykäliin. Tämä
painottaa laajasti käsitellyt asiat pieniä mainintoja enemmän.
Mikään näistä ei ole "oikea"; ne mittaavat eri asioita. Mutta jos ne antavat saman
kuvan, kuva on vankka. Jos ne eroavat, ero on itsessään tulos.
::: {.callout-note title="Mikä on pykälä?"}
Pykälä (§) on lain perusyksikkö — yksi numeroitu kohta, joka säätää yhdestä asiasta.
Esimerkiksi "5 §" voi käsitellä maasta poistamisen edellytyksiä ja "7 §"
muutoksenhakua. Laki rakentuu peräkkäisistä pykälistä, ja niiden lukumäärä ja
sisältö kertovat, mihin laki todella keskittyy. Tässä analyysissa jokainen pykälä on
yksi havainto.
:::
## Datan haku: laki pykälittäin finlex-paketilla
Haemme lain suoraan Finlexin avoimesta datasta omalla `finlex`-paketillani. Funktio
`flx_get_text()` palauttaa lain **valmiiksi pykäliin jaettuna** — yksi rivi per
pykälä, mukana pykälän otsikko ja koko teksti. Emme siis joudu itse pilkkomaan
tekstiä; Finlexin rakenteinen data (Akoma Ntoso -muoto) tekee sen puolestamme.
```{r setup}
#| cache: false
library(tidyverse)
library(here)
library(finlex)   # oma paketti: install.packages("finlex")
library(qs2)
library(ggdist)
library(scales)
library(patchwork)
select <- dplyr::select; filter <- dplyr::filter
set.seed(20270418)

pal <- c(punainen="#e63946", turkoosi="#2a9d8f", oranssi="#f4a261",
         laivasto="#1d3557", sininen="#457b9d")
theme_set(theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face="bold"), plot.subtitle = element_text(color="grey30"),
        panel.grid.minor = element_blank(), legend.position = "top"))

DATA <- here("data", "valineellistetty-maahantulo")
dir.create(DATA, recursive = TRUE, showWarnings = FALSE)

VUOSI <- 2024L; NUMERO <- 482L
```
```{r hae-laki}
#| cache: false
laki_path <- file.path(DATA, "laki_482_2024.qs")
if (!file.exists(laki_path)) {
  laki <- flx_get_text(year = VUOSI, number = NUMERO)   # alkuperäinen, pykälittäin
  qs2::qs_save(laki, laki_path)
}
laki <- qs2::qs_read(laki_path)

# Eheystarkastukset: haku onnistui ja pykäliä on järkevä määrä
stopifnot(
  "finlex-haku epäonnistui"        = all(laki$status == "ok") || any(laki$status == "ok"),
  "Pykäliä ei löytynyt"            = sum(!is.na(laki$text)) >= 5,
  "Odotetut sarakkeet puuttuvat"   = all(c("section_index","heading","text") %in% names(laki)))

laki <- laki |> filter(status == "ok", !is.na(text)) |> arrange(section_index)
glimpse(laki)
```
```{r metatiedot}
#| cache: false
meta_path <- file.path(DATA, "meta_482_2024.qs")
if (!file.exists(meta_path)) qs2::qs_save(flx_get_metadata(VUOSI, NUMERO), meta_path)
meta <- qs2::qs_read(meta_path)
meta |> select(title, date_issued, n_sections)
```
Laki on `r meta$title[1]`, annettu `r format(meta$date_issued[1], "%d.%m.%Y")`, ja se
sisältää `r nrow(laki)` pykälää, joissa on tekstiä. Nyt luokittelemme jokaisen
pykälän.
## Pykälien luokittelu — läpinäkyvästi
Käytämme samoja viittä teemaa, jotka tekoälytyökalu tunnisti, jotta mittarit ovat
vertailukelpoisia. Luokittelu tehdään **sääntöpohjaisesti**: jokaiselle teemalle on
joukko avainsanoja, ja pykälä osoitetaan siihen teemaan, jonka avainsanoja sen
otsikossa ja tekstissä esiintyy eniten.
::: {.callout-important title="Tämä on tulkinta — ja siksi se on näkyvissä"}
Avainsanakartta on **minun valintani**, ei lain eikä Finlexin. Esitän sen
kokonaisuudessaan koodissa, jotta kuka tahansa voi tarkistaa ja muuttaa sitä. En
piilota tulkintaa mallin sisään. Tämä on olennainen ero tekoälyteemoitukseen: siellä
luokittelun logiikka on näkymätön, tässä se on rivi riviltä luettavissa.
:::
```{r luokittele}
teema_avainsanat <- list(
  "Lain tarkoitus ja soveltamisala" =
    c("tarkoitus","sovelletaan","soveltamisala","määritelm","voimaantulo","voimassa"),
  "Hakemusten rajoittaminen" =
    c("rajoittaa","rajoittamis","rajoitus","valtioneuvost","päättää rajoit","kuukauden ajaksi"),
  "Maahanpääsyn estäminen ja maasta poistaminen" =
    c("maahanpääsy","estetään","poistetaan","maasta poistam","torju","tunkeutumis","viipymättä"),
  "Poikkeukset haavoittuville" =
    c("poiketen","poikkeus","haavoittuva","lapsen etu","vammais","otetaan vastaan","kidutuks","kuolemanrangaist"),
  "Uudelleenarviointi ja oikeusturva" =
    c("uudelleenarvioin","muutoksenhak","oikeusturva","ilmoitettava","kuulemis","hallintolai","kirjallisesti","täytäntöön"))

luokittele_pykala <- function(txt) {
  t <- str_to_lower(txt)
  pisteet <- map_int(teema_avainsanat, \(sanat) sum(str_count(t, str_to_lower(sanat))))
  if (max(pisteet) == 0) return("Muu (luokittelematon)")
  names(pisteet)[which.max(pisteet)]
}

laki_luok <- laki |>
  mutate(teema = map_chr(text, luokittele_pykala),
         sanat = str_count(text, "\\S+"))    # sanamäärä per pykälä

# Laatuvartija: liikaa luokittelematonta -> avainsanoja pitää laajentaa
muu_osuus <- mean(laki_luok$teema == "Muu (luokittelematon)")
stopifnot("Liikaa luokittelemattomia pykäliä — laajenna avainsanoja" = muu_osuus < 0.30)
message("Luokittelemattomia pykäliä: ", percent(muu_osuus, 0.1))

laki_luok |> select(section_index, heading, teema, sanat) |> print(n = Inf)
```
## Jakauma ensin: kolme mittaa rinnakkain
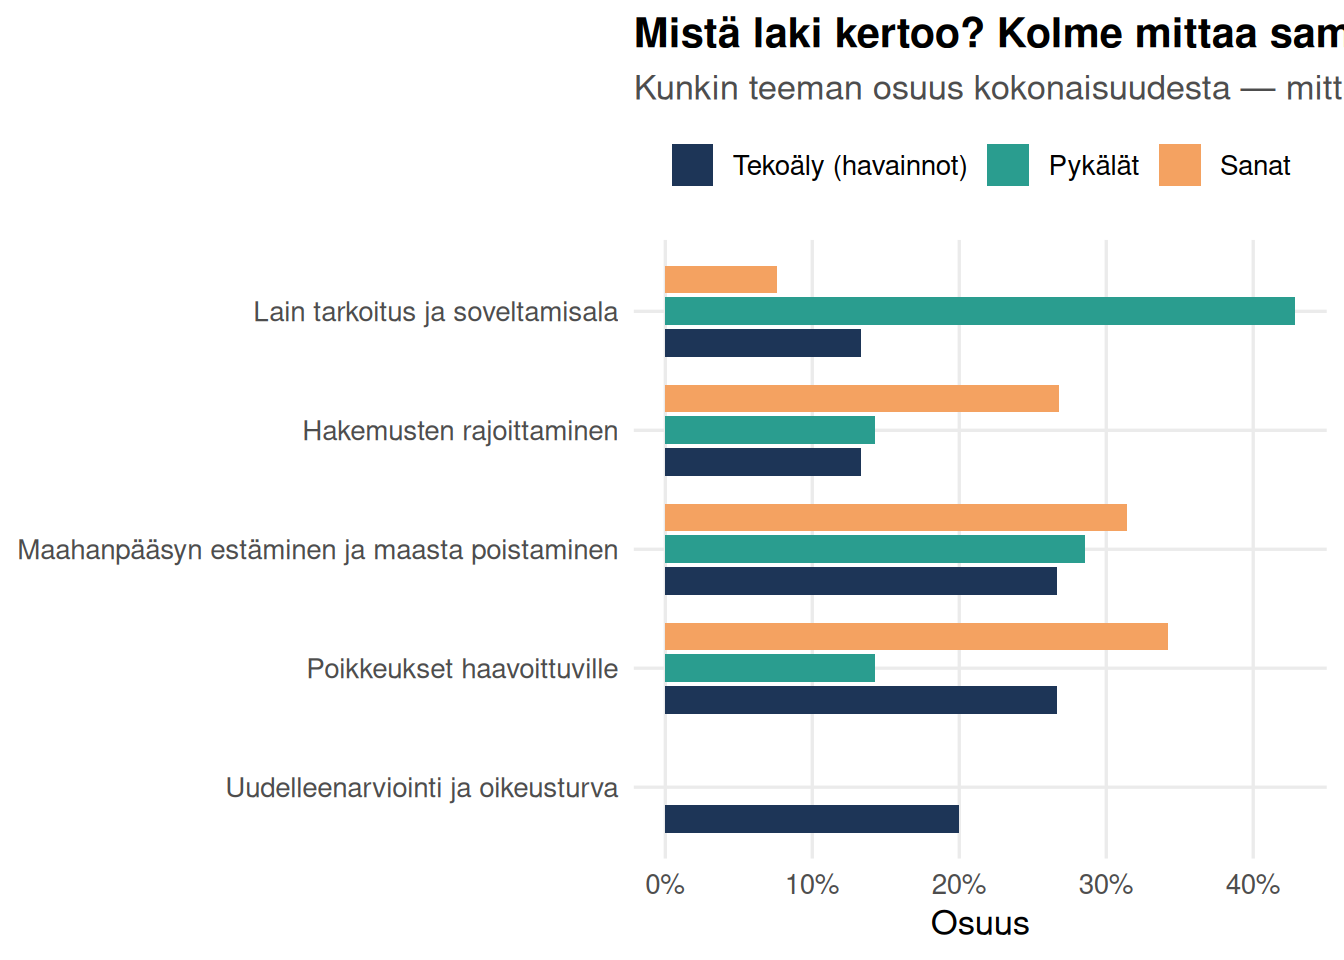
Nyt vertaamme kolmea mittaa samassa kuvassa: tekoälyn havainnot, pykälien osuus ja
sanojen osuus. Jokainen on **osuus**, eli kunkin teeman siivu kokonaisuudesta.
```{r kolme-mittaa}
teemat_jarjestys <- c("Lain tarkoitus ja soveltamisala","Hakemusten rajoittaminen",
  "Maahanpääsyn estäminen ja maasta poistaminen","Poikkeukset haavoittuville",
  "Uudelleenarviointi ja oikeusturva")

# 1) Skimlen havainnot (annettu aineisto)
skimle <- tribble(
  ~teema, ~havainnot,
  "Maahanpääsyn estäminen ja maasta poistaminen", 4,
  "Poikkeukset haavoittuville",                    4,
  "Uudelleenarviointi ja oikeusturva",             3,
  "Lain tarkoitus ja soveltamisala",               2,
  "Hakemusten rajoittaminen",                       2)

# 2) & 3) Pykälät ja sanat finlex-datasta
oma <- laki_luok |> filter(teema != "Muu (luokittelematon)") |>
  group_by(teema) |> summarise(pykalat = n(), sanat = sum(sanat), .groups = "drop")

vrt <- skimle |>
  full_join(oma, by = "teema") |>
  mutate(across(c(havainnot, pykalat, sanat), \(x) replace_na(x, 0))) |>
  transmute(teema,
            `Tekoäly (havainnot)` = havainnot / sum(havainnot),
            `Pykälät`             = pykalat   / sum(pykalat),
            `Sanat`               = sanat     / sum(sanat)) |>
  pivot_longer(-teema, names_to = "mittari", values_to = "osuus") |>
  mutate(teema = factor(teema, levels = rev(teemat_jarjestys)),
         mittari = factor(mittari, levels = c("Tekoäly (havainnot)","Pykälät","Sanat")))

ggplot(vrt, aes(x = osuus, y = teema, fill = mittari)) +
  geom_col(position = position_dodge(.8), width = .7) +
  scale_x_continuous(labels = label_percent()) +
  scale_fill_manual(values = unname(pal[c(4,2,3)])) +
  labs(title = "Mistä laki kertoo? Kolme mittaa samasta laista",
       subtitle = "Kunkin teeman osuus kokonaisuudesta — mittari vaikuttaa kuvaan",
       x = "Osuus", y = NULL, fill = NULL)
```
Tästä näkee heti sen, mitä yksi otsikko ei kertoisi: **turvatakkeiksi luettavat
teemat — haavoittuvien poikkeukset ja uudelleenarviointi/oikeusturva — muodostavat
huomattavan osan laista kaikilla kolmella mittarilla.** Laki, joka tunnetaan
"käännytyksestä", käyttää suuren osan tekstistään sen rajaamiseen, kenen kohdalla
käännytystä *ei* sovelleta ja miten päätöksestä voi valittaa.
## Turvatakeiden osuus — piste ei riitä, väli kertoo enemmän
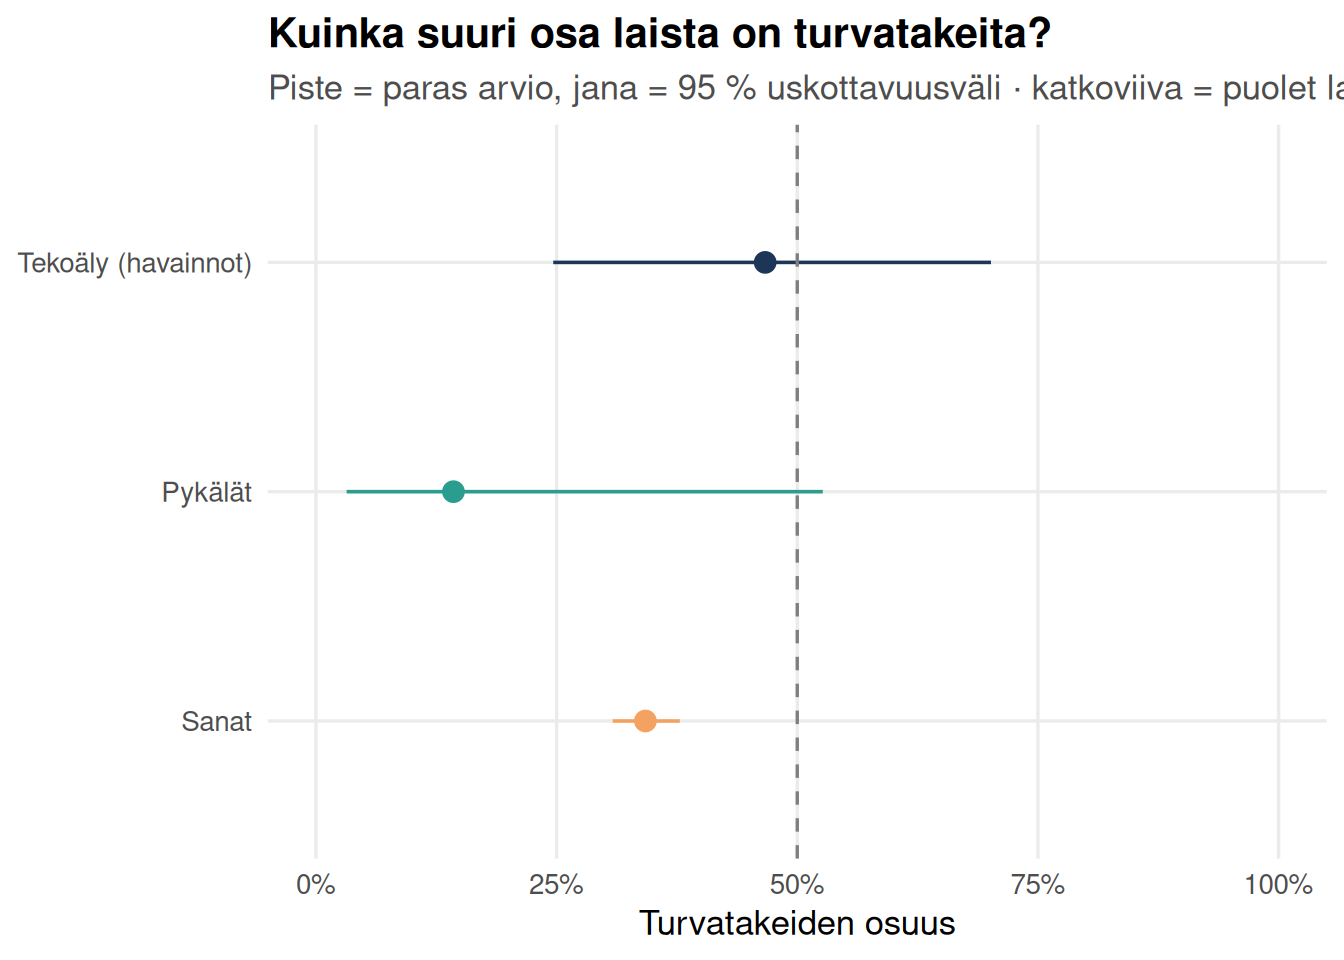
Tässä sloganini ydin. Sanotaan, että jaamme teemat karkeasti kahtia: **rajoittavat**
(tarkoitus, hakemusten rajoittaminen, maahanpääsyn estäminen) ja **turvatakeet**
(haavoittuvien poikkeukset, uudelleenarviointi). Kuinka suuri osa laista on
turvatakeita?
Vastaus ei ole yksi luku, koska havaintoja on vähän. Käytämme **bayeslaista
arviota** (Dirichlet–Beta), joka antaa pisteen sijaan **uskottavuusvälin**: alueen,
jonka sisällä todellinen osuus uskottavasti on.
::: {.callout-note title="Miksi uskottavuusväli, ei pelkkä prosentti?"}
Jos poimimme 15 havaintoa ja 7 niistä on turvatakeita, "47 %" on paras arvaus. Mutta
15 havaintoa on vähän — toisella lukukerralla luku voisi hyvin olla 40 % tai 55 %.
Uskottavuusväli mittaa tämän epävarmuuden ja näyttää sen rehellisesti. Kapea väli
tarkoittaisi varmuutta, leveä väli epävarmuutta. Pelkkä prosenttiluku teeskentelisi
varmuutta, jota meillä ei ole.
:::
```{r turvatakeet}
ryhma <- tibble(
  teema = teemat_jarjestys,
  ryhma = c("Rajoittava","Rajoittava","Rajoittava","Turvatakeet","Turvatakeet"))

# Sama laskenta kolmelle mittarille -> Beta-väli turvatakeiden osuudelle
osuus_vali <- function(k, n) {
  a <- 1 + k; b <- 1 + (n - k)   # Dirichlet(1,1)-priori
  tibble(piste = k/n, lo = qbeta(.025, a, b), hi = qbeta(.975, a, b))
}

mittarit <- list(
  "Tekoäly (havainnot)" = skimle |> left_join(ryhma, by="teema") |>
     summarise(k = sum(havainnot[ryhma=="Turvatakeet"]), n = sum(havainnot)),
  "Pykälät" = oma |> left_join(ryhma, by="teema") |>
     summarise(k = sum(pykalat[ryhma=="Turvatakeet"]), n = sum(pykalat)),
  "Sanat" = oma |> left_join(ryhma, by="teema") |>
     summarise(k = sum(sanat[ryhma=="Turvatakeet"]),   n = sum(sanat)))

turva <- imap_dfr(mittarit, \(d, nimi) osuus_vali(d$k, d$n) |> mutate(mittari = nimi)) |>
  mutate(mittari = factor(mittari, levels = c("Tekoäly (havainnot)","Pykälät","Sanat")))

ggplot(turva, aes(x = piste, y = fct_rev(mittari), color = mittari)) +
  geom_pointinterval(aes(xmin = lo, xmax = hi), linewidth = 1.2, point_size = 3) +
  geom_vline(xintercept = .5, linetype = "dashed", color = "grey50") +
  scale_x_continuous(labels = label_percent(), limits = c(0,1)) +
  scale_color_manual(values = unname(pal[c(4,2,3)]), guide = "none") +
  labs(title = "Kuinka suuri osa laista on turvatakeita?",
       subtitle = "Piste = paras arvio, jana = 95 % uskottavuusväli · katkoviiva = puolet laista",
       x = "Turvatakeiden osuus", y = NULL)
```
Katso janoja, älä pisteitä. Kaikilla kolmella mittarilla turvatakeiden osuus on
merkittävä, mutta **epävarmuus on suuri** — erityisesti tekoälyn havainnoilla, joilla
väli ulottuu reilusti puolen molemmin puolin. Emme siis voi sanoa "laki on täsmälleen
puoliksi turvatakeita". Voimme sanoa jotain vahvempaa ja rehellisempää: *turvatakeet
ovat iso, mitattava osa lakia — eivät sivuhuomautus.* Se riittää kumoamaan yhden
sanan antaman kuvan.
## Ovatko mittarit samaa mieltä? Tilastollinen testi
Tekoälyn havainnot ja lain pykälät ovat kaksi **riippumatonta** tapaa mitata sama
asia. Jos ne antavat tilastollisesti saman jakauman, tulos on vankka. Testaamme tätä
khii-neliö-yhteensopivuustestillä.
```{r testi}
vertailu_taulu <- skimle |> rename(Tekoäly = havainnot) |>
  full_join(oma |> select(teema, Pykälät = pykalat), by = "teema") |>
  mutate(across(c(Tekoäly, Pykälät), \(x) replace_na(x, 0))) |>
  filter(Tekoäly + Pykälät > 0)

# Yhteensopivuus: noudattavatko pykälät samaa jakaumaa kuin tekoälyn havainnot?
odotettu_p <- vertailu_taulu$Tekoäly / sum(vertailu_taulu$Tekoäly)
khi <- suppressWarnings(chisq.test(x = vertailu_taulu$Pykälät, p = odotettu_p, rescale.p = TRUE))
cramers_v <- sqrt(unname(khi$statistic) / sum(vertailu_taulu$Pykälät) /
                  (nrow(vertailu_taulu) - 1))
tibble(khi2 = round(unname(khi$statistic),2), df = unname(khi$parameter),
       p = round(khi$p.value,3), cramers_V = round(cramers_v,3))
```
::: {.callout-important title="Miten tätä p-arvoa luetaan"}
Suuri p-arvo (yli 0,05) tarkoittaa tässä hyvää uutista: emme löydä todisteita siitä,
että pykäläjakauma ja tekoälyn havaintojakauma eroaisivat. Toisin sanoen **kaksi
riippumatonta mittaria kertovat saman tarinan** — mikä lisää luottamusta siihen, että
teemajakauma on todellinen eikä yhden mittarin oikku. Pieni p-arvo taas kertoisi, että
mittarit ovat eri mieltä ja jompaakumpaa pitää tulkita varovasti. Efektikoko (Cramérin
V) kertoo eron suuruuden pelkän merkitsevyyden ohi.
:::
## Counterfactual: muuttiko myöhempi muutos tasapainoa?
Lakia 482/2024 muutettiin myöhemmin. `finlex`-paketin `flx_get_consolidated_text()`
antaa lain **konsolidoidun** eli tällä hetkellä voimassa olevan tekstin, johon
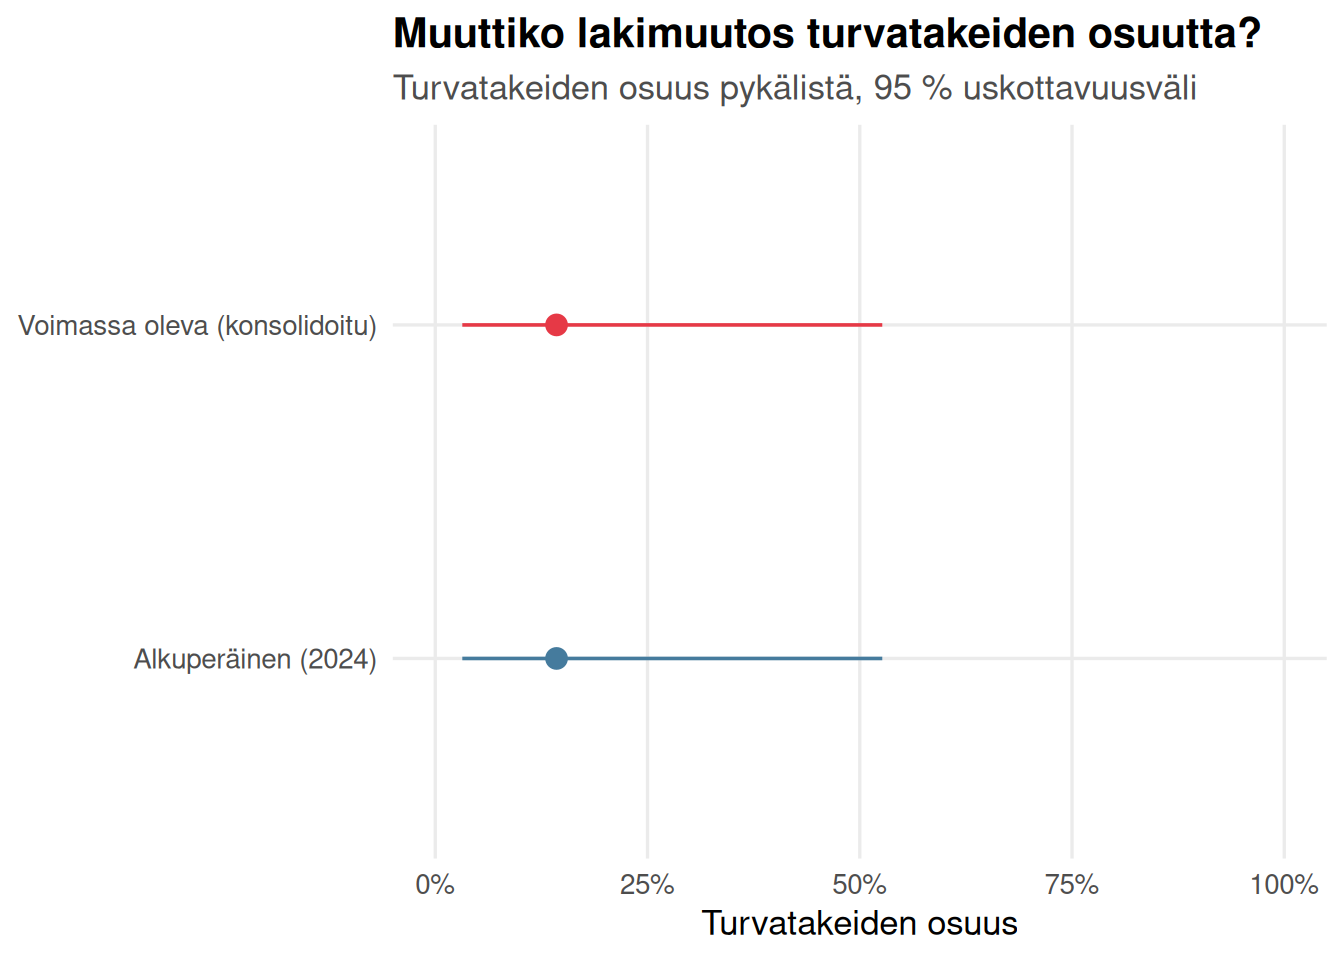
muutokset on sulautettu. Vertaamme alkuperäistä ja voimassa olevaa versiota: siirsikö
muutos lain painopistettä rajoittavampaan vai turvatakeiden suuntaan? Tämä on
konkreettinen counterfactual — "miltä laki näyttäisi ilman muutosta" vs. "miltä se
näyttää nyt".
```{r counterfactual}
#| cache: false
kons_path <- file.path(DATA, "laki_konsolidoitu.qs")
if (!file.exists(kons_path)) qs2::qs_save(flx_get_consolidated_text(VUOSI, NUMERO), kons_path)
kons <- qs2::qs_read(kons_path)

vertaa_versiot <- function(df, versio) {
  df |> filter(status == "ok", !is.na(text)) |>
    mutate(teema = map_chr(text, luokittele_pykala)) |>
    filter(teema != "Muu (luokittelematon)") |>
    left_join(ryhma, by = "teema") |>
    summarise(k = sum(ryhma == "Turvatakeet"), n = n()) |>
    mutate(versio = versio) |> rowwise() |>
    mutate(osuus_vali(k, n)) |> ungroup()
}

cf <- bind_rows(
  vertaa_versiot(laki, "Alkuperäinen (2024)"),
  if (any(kons$status == "ok")) vertaa_versiot(kons, "Voimassa oleva (konsolidoitu)")
)

if (nrow(cf) >= 2) {
  ggplot(cf, aes(x = piste, y = versio, color = versio)) +
    geom_pointinterval(aes(xmin = lo, xmax = hi), linewidth = 1.2, point_size = 3) +
    scale_x_continuous(labels = label_percent(), limits = c(0,1)) +
    scale_color_manual(values = unname(pal[c(5,1)]), guide = "none") +
    labs(title = "Muuttiko lakimuutos turvatakeiden osuutta?",
         subtitle = "Turvatakeiden osuus pykälistä, 95 % uskottavuusväli",
         x = "Turvatakeiden osuus", y = NULL)
} else {
  message("Konsolidoitua versiota ei saatavilla — counterfactual ohitetaan.")
}
```
::: {.callout-note title="Jos välit menevät päällekkäin"}
Jos alkuperäisen ja voimassa olevan version uskottavuusvälit menevät päällekkäin,
tulkinta on: muutos ei siirtänyt lain tasapainoa havaittavasti. Vasta selvästi
erilleen menevät välit kertoisivat todellisesta painopisteen siirtymästä. Tämä on
rehellinen tapa vertailla — ei "muuttui/ei muuttunut" vaan kuinka varmoja voimme olla.
:::
## Faktalaatikko: mitä on "välineellistetty maahantulo"?
::: {.callout-tip title="Tausta tutkimuskirjallisuudesta"}
Lain käsittelemä ilmiö — valtion tarkoituksellinen maahantulon käyttö painostuksen
välineenä — on tunnettu kansainvälisen politiikan tutkimuksessa. Käsitteen vakiintunut
lähde on Kelly M. Greenhillin teos *Weapons of Mass Migration: Forced Displacement,
Coercion, and Foreign Policy* (Cornell University Press, 2010), joka dokumentoi
kymmeniä tapauksia, joissa valtiot ovat käyttäneet väestöliikkeitä ulkopoliittisena
painostuskeinona.
**Evidenssin luonteesta rehellisesti:** tämä kirjallisuus on laadullista tapaus- ja
vertailututkimusta, ei kokeellista tai meta-analyyttista. Ilmiön luonteen vuoksi
satunnaistettuja asetelmia ei ole, joten emme voi esittää meta-analyysin kaltaista
yhteenvetoa vaikuttavuudesta. Se on syytä sanoa: taustan varmuus on eri luokkaa kuin
itse lakitekstin, jonka mittaamme suoraan.
:::
## Mitä tämä tarkoittaa päättäjälle
- **Yksi sana ei ole laki.** "Käännytyslaki" on otsikko, ei sisältö. Kun teksti
luetaan pykälä pykälältä, turvatakeet ovat iso osa lakia — ei sivuhuomautus.
- **Mittari muokkaa kuvaa.** Sama laki näyttää hieman erilaiselta riippuen siitä,
lasketaanko havaintoja, pykäliä vai sanoja. Rehellinen analyysi näyttää useamman
mittarin, ei valitse itselleen sopivinta.
- **Epävarmuus kuuluu tulokseen.** Vähäisestä datasta ei saa tarkkaa prosenttia, ja
sen teeskentely olisi harhaanjohtavaa. Uskottavuusväli kertoo, kuinka pitkälle
johtopäätöksen voi viedä.
- **Rakenteinen avoin data on tässä ratkaisu.** Koko analyysi nojaa Finlexin avoimeen
dataan, joka on koneluettavassa muodossa — kuka tahansa voi toistaa sen.
## Näin voit hyödyntää tätä käytännössä
Sama menetelmä toimii mille tahansa pitkälle asiakirjalle, joka julkisuudessa
typistyy yhteen leimaan: sopimus, säädös, lausunto, poliittinen ohjelma. Pilko se
rakenneosiin, luokittele ne läpinäkyvästi, ja mittaa jakauma epävarmuuksineen. Se
korvaa mielikuvan mitatulla rakenteella — ja paljastaa, milloin otsikko ja sisältö
ovat eri mieltä.
---
::: {.callout-tip title="Tehdäänkö teidän datallenne sama?"}
Autan organisaatioita korvaamaan yhden luvun tai yhden leiman mitatulla jakaumalla —
sopimuksissa, säädösvalvonnassa, riskiraporteissa tai missä tahansa, missä pitkä
dokumentti typistyy pisteeksi. Rakenteisesta avoimesta datasta, epävarmuus näkyvissä,
täysin toistettavasti. Otetaan yhteyttä: **kristianvepsalainen.com**.
:::
*Datalähde: Finlex, avoin data (CC BY 4.0), haettu `finlex`-R-paketilla. Teemoituksen
vertailuaineisto: Skimle-analyysityökalu. Luokittelu ja mahdolliset virheet ovat
omiani.*