---
title: "Rekisteririskimittari"
subtitle: "Rakennetaan avoimesta datasta luottoriskimalli — ja testataan se rehellisesti tulevaisuudella"
date: 2026-08-25
categories: [avoin data, bayes, luottoriski, validointi, YTJ]
execute:
  warning: false
  message: false
---

```{r setup}
#| include: false
library(tidyverse)
library(here)
library(ggdist)
select <- dplyr::select
filter <- dplyr::filter
source(here("R","ytj", "theme_kristian.R"))
source(here("R","ytj", "toimiala_sektori.R"))
source(here("R","ytj", "yhdista_apu.R"))
theme_set(theme_kristian())
```

Tämä sarja on kulkenut osa osalta läpi suomalaisen kaupparekisterin: perustiedot,
ilmoitusvirran, digitaaliset tilinpäätökset, yritysten elinkaaret, kuolintavat,
sääntelyn jäljen, muuttoliikkeen ja yritysjärjestelyt. Nyt on aika kysyä
kysymys, joka on ollut koko ajan taustalla:

**Voiko pelkästä avoimesta rekisteridatasta rakentaa luottoriskimittarin, joka
oikeasti toimii?**

Vastaus ei ole mielipide. Se on testattavissa — ja tämä osa on omistettu sille
testille. Rakennamme mittarin, ja sitten yritämme kaikin tavoin osoittaa, ettei
se toimi. Jos se selviää siitä, se on jotain arvoista.

Tämä on kohta, jossa data science eroaa datan esittelystä. Malli, jota ei ole
validoitu tulevaisuudella, on hypoteesi. Malli, joka on, on työkalu.

## Mistä datassa on kyse?

::: {.callout-note}
Aineistona PRH:n avoimet rekisteriaineistot (CC BY 4.0), rajattuna osakeyhtiöihin.
Malli ennustaa yrityksen **lakkaamista** (END-tyypin rekisterimerkintä) kahden
vuoden sisällä havaintohetkestä, käyttäen ainoastaan tietoa, joka oli saatavilla
**ennen** havaintohetkeä.

Rehellisyyden vuoksi: lakkaaminen ei ole sama asia kuin luottotappio. Suurin osa
lakkaamisista on hallittuja purkautumisia (ks. osa 5). Tämä mittari ennustaa
yrityksen katoamista, mikä on luottoriskin *osatekijä*, ei sen koko kuva.
:::

```{r lataa}
perustiedot <- qs2::qs_read(here("data", "ytj", "ytj_perustiedot.qs"))
pitka       <- qs2::qs_read(here("data", "ytj", "ilmoitukset_pitka.qs"))

stopifnot(
  all(c("business_id","company_form_code","registration_date","main_line_code",
        "location") %in% names(perustiedot)),
  all(c("business_id","nid","pvm","type_of_registration","koodi") %in% names(pitka)),
  all(c("HAL","TMI","KONALK","ESR") %in% unique(pitka$koodi))
)

oy <- perustiedot |>
  filter(company_form_code == "16") |>
  distinct(business_id, .keep_all = TRUE) |>
  transmute(
    business_id,
    synty    = as.Date(registration_date),
    sektori  = toimiala_sektori(main_line_code),
    kaupunki = if_else(toupper(location) %in%
                       c("HELSINKI","ESPOO","TAMPERE","VANTAA","OULU",
                         "TURKU","JYVÄSKYLÄ","KUOPIO","LAHTI"),
                       "Suuri kaupunki", "Muu Suomi")
  ) |>
  filter(!is.na(synty), !is.na(sektori))

lakkaamiset <- pitka |>
  filter(type_of_registration == "END") |>
  group_by(business_id) |>
  summarise(lakk_pvm = min(pvm), .groups = "drop")
```

## Asetelma: aitoa ennustamista, ei jälkiviisautta

Tämä on koko kirjoituksen tärkein kohta, ja se ansaitsee selityksen päättäjälle.

Riskimallin voi saada näyttämään loistavalta huijaamalla itseään. Yleisin tapa on
antaa mallin nähdä tapahtumia, jotka ovat *osa* ennustettavaa asiaa. Lakkaava
yritys tuottaa loppuvaiheessa runsaasti rekisterimerkintöjä — selvitystila,
selvitysmiehet, purkautuminen. Jos malli saa nähdä ne, se "ennustaa" lakkaamista
lakkaamisesta ja näyttää lähes erehtymättömältä. Se on kuin ennustaisi sadetta
siitä, että maa on jo märkä.

Vältämme tämän kahdella säännöllä:

**Kiinteä havaintohetki.** Kaikki yritykset — sekä myöhemmin lakanneet että
selvinneet — arvioidaan samana kalenteripäivänä. Piirteet lasketaan vain sitä
edeltävältä ikkunalta.

**Ajallinen validointi (out-of-time).** Malli opetetaan aiemmalla havaintohetkellä
ja testataan **myöhemmällä**, jota se ei ole koskaan nähnyt. Tämä on ankarampaa
kuin satunnainen jako, ja se vastaa sitä, miten mallia oikeasti käytettäisiin:
opetat menneellä, ennustat tulevaa.

```{r piirteet-funktio}
IKKUNA   <- 3   # vuotta taaksepäin: jalanjälki
HORISONTTI <- 2 # vuotta eteenpäin: ennustettava jakso

rakenna_kohortti <- function(hetki) {
  alku <- hetki - lubridate::days(round(IKKUNA * 365.25))

  jalanjalki <- pitka |>
    filter(pvm >= alku, pvm < hetki) |>          # VAIN ennen havaintohetkeä
    group_by(business_id) |>
    summarise(
      n_ilm       = n_distinct(nid),
      n_hallitus  = n_distinct(nid[koodi == "HAL"]),
      n_nimi      = n_distinct(nid[koodi %in% c("TMI","NIMP","NIMA")]),
      on_konalk   = any(koodi == "KONALK"),
      on_esr      = any(koodi == "ESR"),
      .groups = "drop"
    )

  oy |>
    left_join(lakkaamiset, by = "business_id") |>
    # elossa havaintohetkellä
    filter(synty < hetki, is.na(lakk_pvm) | lakk_pvm >= hetki) |>
    left_join(jalanjalki, by = "business_id") |>
    mutate(
      across(c(n_ilm, n_hallitus, n_nimi), \(x) coalesce(x, 0L)),
      across(c(on_konalk, on_esr), \(x) coalesce(x, FALSE)),
      ika = as.numeric(difftime(hetki, synty, units = "days")) / 365.25,
      lakkasi = !is.na(lakk_pvm) &
                lakk_pvm <= hetki + lubridate::days(round(HORISONTTI * 365.25)),
      sektori  = fct_lump_min(factor(sektori), min = 200, other_level = "Muut"),
      kaupunki = factor(kaupunki, levels = c("Muu Suomi","Suuri kaupunki"))
    ) |>
    filter(ika >= 0)
}

OPETUS_HETKI <- as.Date("2020-01-01")   # opetus: ennustaa 2020–2021
TESTI_HETKI  <- as.Date("2022-01-01")   # testi:  ennustaa 2022–2023 (mallille tuntematon)

opetus <- rakenna_kohortti(OPETUS_HETKI)
testi  <- rakenna_kohortti(TESTI_HETKI)

stopifnot(
  nrow(opetus) > 10000, nrow(testi) > 10000,
  n_distinct(opetus$lakkasi) == 2, n_distinct(testi$lakkasi) == 2,
  # VUOTOVAHTI: kukaan ei saa olla lakannut ennen omaa havaintohetkeään
  all(is.na(opetus$lakk_pvm) | opetus$lakk_pvm >= OPETUS_HETKI),
  all(is.na(testi$lakk_pvm)  | testi$lakk_pvm  >= TESTI_HETKI)
)

# Testijoukon tasot on pakotettava opetusjoukon mukaisiksi
testi <- testi |>
  mutate(sektori = factor(as.character(sektori), levels = levels(opetus$sektori))) |>
  filter(!is.na(sektori))
```

Opetuskohortissa on `r format(nrow(opetus), big.mark = " ")` yritystä
(lakkaamisosuus `r scales::percent(mean(opetus$lakkasi), accuracy = 0.1)`) ja
testikohortissa `r format(nrow(testi), big.mark = " ")`
(`r scales::percent(mean(testi$lakkasi), accuracy = 0.1)`).

## Malli

**Bayesilainen logistinen regressio.** Valinta on tietoinen: yksinkertaisempi malli
on tässä parempi kuin monimutkaisempi. Luottoriskissä mallin on oltava
**selitettävissä** — sekä valvojalle että asiakkaalle, jolle päätös perustellaan.
Musta laatikko, joka ennustaa marginaalisesti paremmin mutta jota ei voi selittää,
on useimmissa käyttötapauksissa arvoton. Bayesilaisuus tuo lisäksi sen, mitä
luottoriskissä eniten tarvitaan: **epävarmuuden numeerisena, ei sanallisena.**

```{r malli}
malli_path <- here("data", "ytj", "riskimittari.qs")

if (!file.exists(malli_path)) {
  set.seed(20260818)
  ops <- opetus |>
    mutate(y = as.integer(lakkasi))
  ops <- ops |> slice_sample(n = min(nrow(ops), 30000L))

  fit <- rstanarm::stan_glm(
    y ~ ika + n_ilm + n_hallitus + n_nimi + on_konalk + on_esr +
        sektori + kaupunki,
    data = ops, family = binomial(),
    prior = rstanarm::normal(0, 2.5),
    prior_intercept = rstanarm::normal(0, 5),
    chains = 4, iter = 2000, seed = 20260818, refresh = 0
  )
  qs2::qs_save(list(fit = fit, ops = ops), malli_path)
} else {
  .o <- qs2::qs_read(malli_path); fit <- .o$fit; ops <- .o$ops
}
```

## Testi: pärjääkö malli tulevaisuudessa?

Nyt malli pannaan töihin datalla, jota se ei ole nähnyt — kahden vuoden päässä
opetushetkestä. Käytän kahta mittaria, ja molemmat ovat välttämättömiä.

**Erottelukyky (AUC)** kertoo, kuinka hyvin malli asettaa lakkaavat yritykset
riskijärjestyksessä selviävien edelle. Arvo 0,5 tarkoittaa kolikonheittoa, 1,0
täydellistä erottelua.

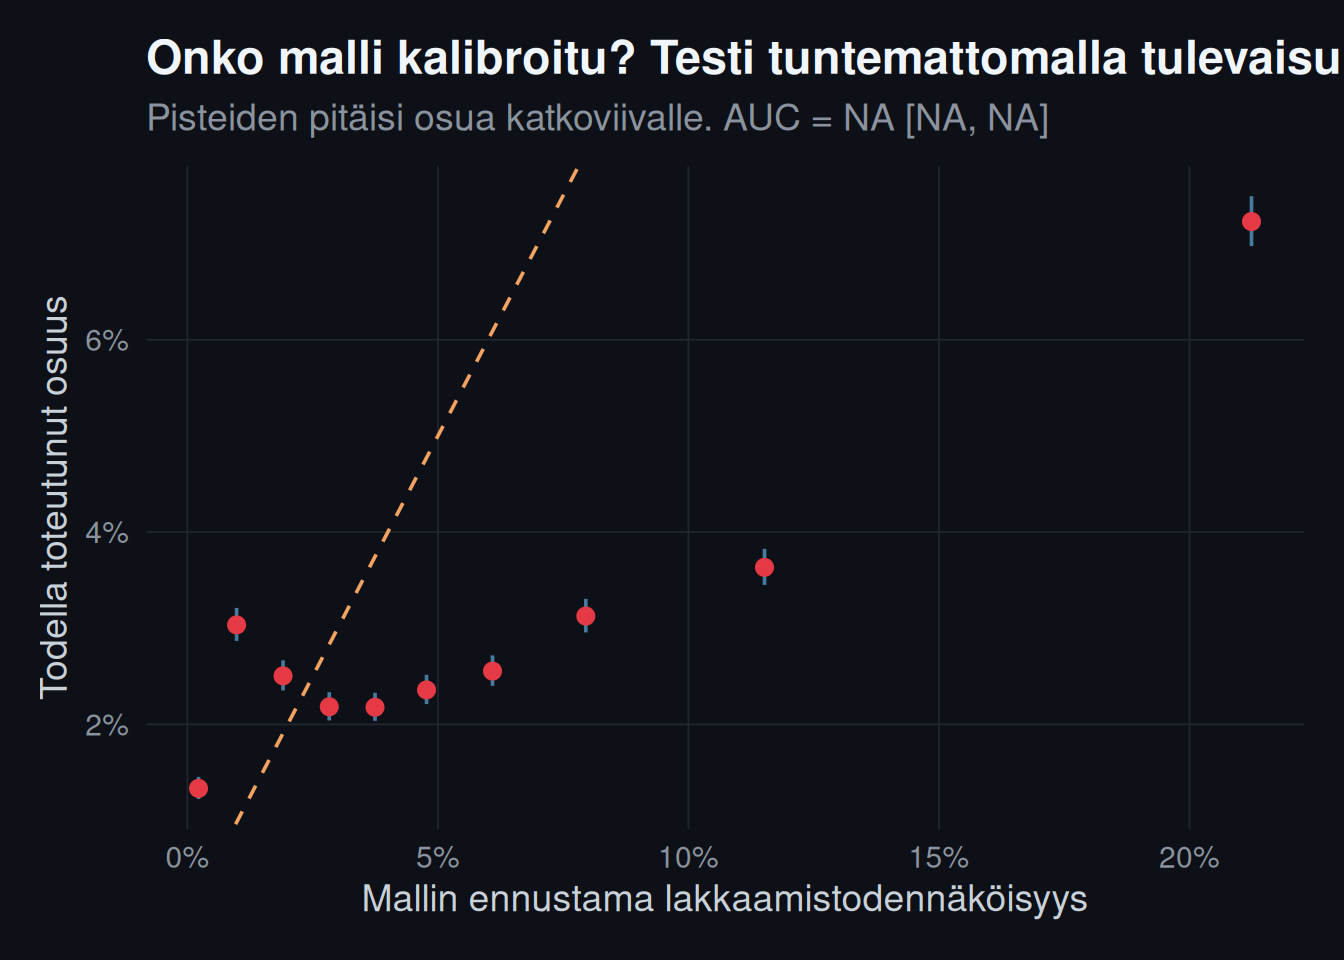
**Kalibraatio** kertoo, ovatko todennäköisyydet *totta*: kun malli sanoo "10 %",
lakkaako todella noin 10 %? Tämä on se, mitä useimmat mallit eivät kerro — ja se
on luottopäätöksessä tärkeämpi kuin AUC. Väärin kalibroitu malli antaa oikean
järjestyksen mutta väärän hinnan.

```{r validointi}
# Piste-ennusteeseen ei tarvita kaikkia 4000 posteriorivetoa: muutama sata antaa
# käytännössä saman keskiarvon murto-osassa ajasta ja muistista. Koko posteriorin
# laskeminen kymmenilletuhansille riveille on turha pullonkaula.
p_testi <- colMeans(rstanarm::posterior_epred(fit, newdata = testi, draws = 400))

# AUC ilman lisäriippuvuuksia: Mann–Whitney U -yhteys
auc_laske <- function(p, y) {
  r <- rank(p)
  n1 <- sum(y == 1); n0 <- sum(y == 0)
  stopifnot(n1 > 0, n0 > 0)
  # n1 * n0 pakotettava liukuluvuksi: isoilla ryhmillä kokonaislukukertolasku
  # ylivuotaa (> 2,1e9) ja palauttaa NA:n (sama bugi kuin rank-biserialissa).
  (sum(r[y == 1]) - n1 * (n1 + 1) / 2) / (as.numeric(n1) * as.numeric(n0))
}
auc <- auc_laske(p_testi, as.integer(testi$lakkasi))

# Bootstrap-epävarmuus AUC:lle
set.seed(1)
auc_boot <- replicate(200, {
  i <- sample(length(p_testi), replace = TRUE)
  y <- as.integer(testi$lakkasi)[i]
  if (length(unique(y)) < 2) return(NA_real_)
  auc_laske(p_testi[i], y)
})
auc_ci <- quantile(auc_boot, c(0.025, 0.975), na.rm = TRUE)

kalib <- tibble(p = p_testi, y = as.integer(testi$lakkasi)) |>
  mutate(korit = ntile(p, 10)) |>
  group_by(korit) |>
  summarise(ennustettu = mean(p), toteutunut = mean(y), n = n(), .groups = "drop") |>
  mutate(
    lo = qbeta(0.025, 1 + toteutunut * n, 1 + n - toteutunut * n),
    hi = qbeta(0.975, 1 + toteutunut * n, 1 + n - toteutunut * n)
  )

# VERTAILUKOHTA: populaation perustaso. Jokainen riskiluku on tulkittava tätä
# vasten — 11 % on korkea vain, jos keskiverto on 2,5 %.
perusaste <- mean(as.integer(testi$lakkasi))

ggplot(kalib, aes(ennustettu, toteutunut)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed",
              color = kvar_palette[["orange"]]) +
  geom_hline(yintercept = perusaste, linetype = "dotted",
             color = kvar_palette[["teal"]]) +
  annotate("text", x = max(kalib$ennustettu) * 0.6, y = perusaste,
           label = sprintf("Perustaso: %.1f %%", 100 * perusaste),
           vjust = -0.6, size = 3, color = kvar_palette[["teal"]]) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0,
                color = kvar_palette[["blue"]]) +
  geom_point(color = kvar_palette[["red"]], size = 2.5) +
  scale_x_continuous(labels = scales::percent) +
  scale_y_continuous(labels = scales::percent) +
  labs(title = "Onko malli kalibroitu? Testi tuntemattomalla tulevaisuudella",
       subtitle = sprintf("Katkoviiva = täydellinen kalibraatio. Pisteviiva = keskiverto (%.1f %%). AUC = %.3f [%.3f, %.3f]",
                          100 * perusaste, auc, auc_ci[[1]], auc_ci[[2]]),
       x = "Mallin ennustama lakkaamistodennäköisyys",
       y = "Todella toteutunut osuus")
```

## Mihin riskiä verrataan?

Yksittäinen riskiluku on merkityksetön ilman vertailukohtaa. "11 %:n
lakkaamistodennäköisyys" kuulostaa korkealta tai matalalta riippuen täysin siitä,
mikä on keskiverto — ja keskiverto tässä testijoukossa on
`r scales::percent(mean(as.integer(testi$lakkasi)), accuracy = 0.1)`. Malli ei
tuota absoluuttista tuomiota vaan **sijoittaa yrityksen suhteessa muihin**: sen
tehtävä on levittää yritykset perustason ympärille niin, että riskisimmät erottuvat.

Tästä seuraa vastaus tärkeään kysymykseen: **entä yritykset, joilla ei ole
jalanjälkeä** — ne, jotka eivät ole tehneet yhtään rekisterimerkintää
havaintoikkunassa? Ne eivät jää mallin ulkopuolelle. Malli antaa niille arvion,
joka nojaa pelkkään ikään, toimialaan ja sijaintiin — ja se arvio asettuu lähelle
perustasoa. Tämä on oikea käyttäytyminen: kun signaalia ei ole, malli ei keksi
riskiä eikä poista sitä, vaan palauttaa "keskiverto, kunnes toisin todistetaan".
Juuri siksi vertailu perustasoon on koko mallin tulkinnan ankkuri — ilman sitä
riskiluku on numero ilman mittakaavaa.

```{r vertailu-perustaso}
# Kuinka moni yritys nousee selvästi perustason yläpuolelle (esim. 2x)?
kohonnut <- mean(p_testi > 2 * perusaste)
tibble::tibble(
  Ryhmä = c("Koko testijoukko (perustaso)",
            "Malli nostaa ≥ 2× perustason yläpuolelle"),
  `Osuus yrityksistä` = c("100 %", scales::percent(kohonnut, accuracy = 0.1)),
  `Toteutunut lakkaamisosuus` = c(
    scales::percent(perusaste, accuracy = 0.1),
    scales::percent(mean(as.integer(testi$lakkasi)[p_testi > 2 * perusaste]), accuracy = 0.1)
  )
) |>
  knitr::kable(caption = "Riskiryhmän vertailu koko populaation perustasoon")
```

Taulukko on se, mitä riskipäällikkö kysyy: kun malli nostaa yrityksen selvästi
perustason yläpuolelle, toteutuuko riski todella keskimääräistä useammin?

::: {.callout-important}
## Näin tulosta luetaan rehellisesti
Jos pisteet osuvat katkoviivalle, mallin lupaamat todennäköisyydet pitävät
paikkansa: kun se sanoo 10 %, lakkaa noin 10 %. Jos pisteet ovat viivan
yläpuolella, malli **aliarvioi** riskiä — vaarallisin virhe luotonannossa.

AUC:n luottamusväli on laskettu bootstrapilla, koska yksittäinen AUC-luku ilman
väliä on juuri se pistearvo, jota vastaan tämä koko sarja argumentoi.
:::

## Kalibrointikorjaus: todennäköisyydet suoraksi

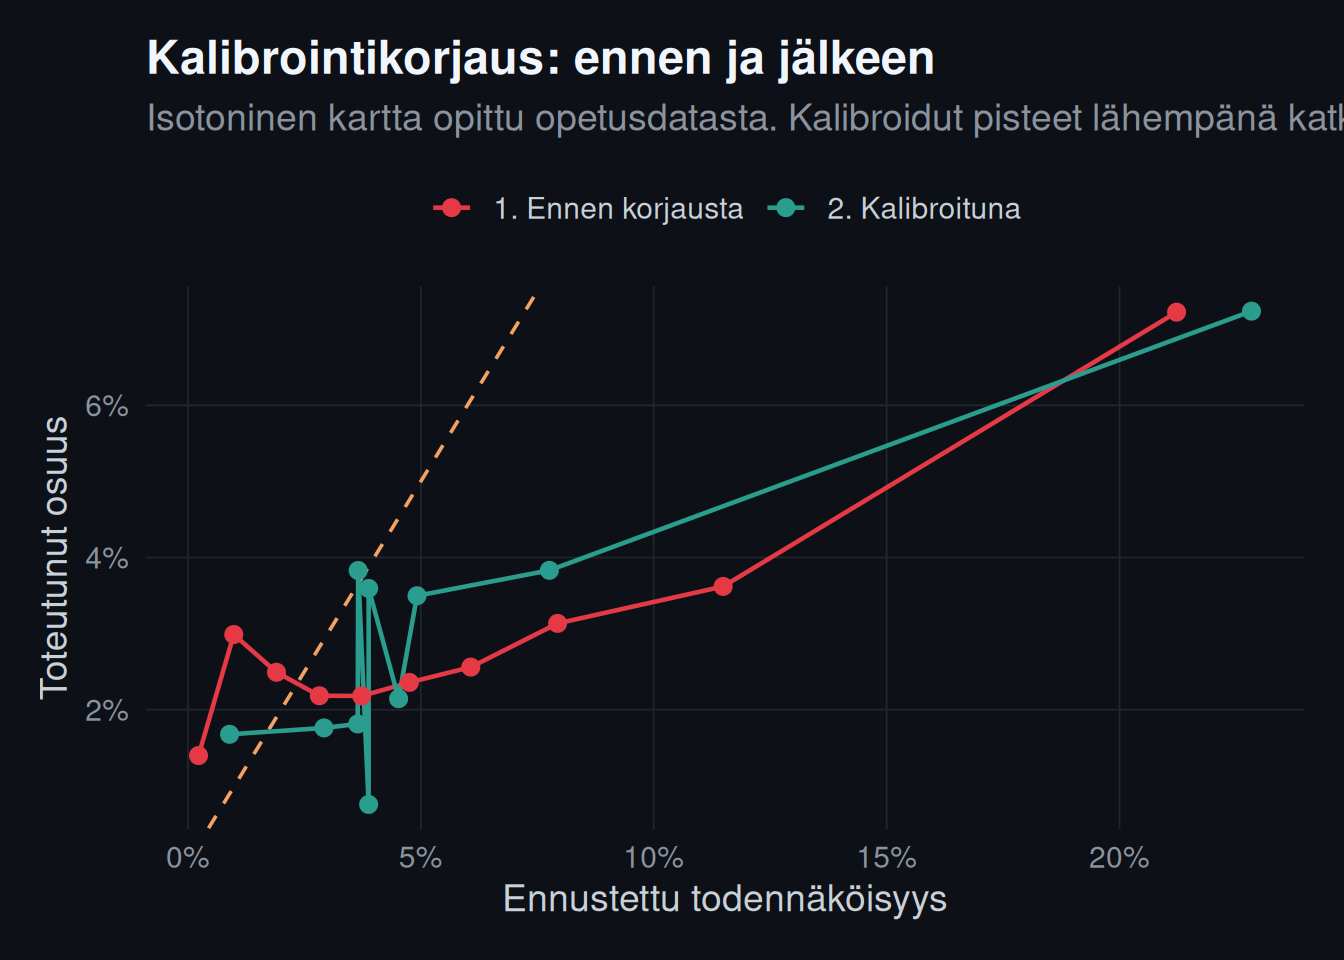
Kalibraatiokuvaaja paljasti, että malli **yliarvioi** riskiä korkeassa päässä:
kun se lupaa 11 %, toteutuu noin 3–4 %. Erottelu on kunnossa (riskisimmät ovat
oikeassa järjestyksessä), mutta todennäköisyystasot ovat vinossa. Luotonannossa
tämä on ongelma: väärä taso johtaa väärään hinnoitteluun.

Tämä on korjattavissa **jälkikalibroinnilla**. Käytän isotonista regressiota, joka
oppii monotonisen kartan mallin raakatodennäköisyydestä toteutuneeseen osuuteen.
Ratkaisevaa on, että kartta opitaan **opetusdatasta** — ei testistä. Testiin
sovitettu kalibrointi vuotaisi tulevaisuudesta ja rikkoisi koko ajallisen kokeen.

```{r kalibrointi}
# 1. Mallin ennusteet OPETUSDATALLE (ei testille -> ei vuotoa)
p_opetus <- colMeans(rstanarm::posterior_epred(fit, newdata = ops, draws = 400))
y_opetus <- ops$y

# 2. Isotoninen kalibrointikartta: raakatodennäköisyys -> korjattu
o   <- order(p_opetus)
iso <- isoreg(p_opetus[o], y_opetus[o])
kalibroi <- approxfun(p_opetus[o], iso$yf, rule = 2, ties = "ordered")

# 3. Sovella TESTIIN (jota kalibrointi ei ole nähnyt)
p_testi_kal <- pmin(pmax(kalibroi(p_testi), 0), 1)

# AUC ei muutu monotonisessa korjauksessa — järjestys säilyy
auc_kal <- auc_laske(p_testi_kal, as.integer(testi$lakkasi))

# Kalibraatio ennen ja jälkeen, samassa kuvassa
kalib_vertailu <- bind_rows(
  tibble(p = p_testi,     y = as.integer(testi$lakkasi), vaihe = "1. Ennen korjausta"),
  tibble(p = p_testi_kal, y = as.integer(testi$lakkasi), vaihe = "2. Kalibroituna")
) |>
  group_by(vaihe) |>
  mutate(korit = ntile(p, 10)) |>
  group_by(vaihe, korit) |>
  summarise(ennustettu = mean(p), toteutunut = mean(y), .groups = "drop")

ggplot(kalib_vertailu, aes(ennustettu, toteutunut, color = vaihe)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed",
              color = kvar_palette[["orange"]]) +
  geom_line(linewidth = 0.8) +
  geom_point(size = 2.5) +
  scale_color_manual(values = c(kvar_palette[["red"]], kvar_palette[["teal"]])) +
  scale_x_continuous(labels = scales::percent) +
  scale_y_continuous(labels = scales::percent) +
  labs(title = "Kalibrointikorjaus: ennen ja jälkeen",
       subtitle = sprintf("Isotoninen kartta opittu opetusdatasta. Kalibroidut pisteet lähempänä katkoviivaa. AUC ennallaan (%.3f).",
                          auc_kal),
       x = "Ennustettu todennäköisyys", y = "Toteutunut osuus", color = NULL)
```

::: {.callout-tip}
## Miksi erottelu ja kalibrointi ovat eri asioita
Korjaus ei muuta yritysten **järjestystä** — AUC pysyy täsmälleen samana, koska
isotoninen kartta on monotoninen. Se muuttaa vain **tasoja**: saman järjestyksen
saavat todennäköisyydet, jotka pitävät paikkansa. Tämä on olennainen ero.
Erottelukyky vastaa kysymykseen "kuka on riskisin?", kalibrointi kysymykseen
"kuinka riskisin?". Luottopäätös tarvitsee molemmat — järjestyksen seulontaan ja
tason hinnoitteluun.
:::

## Riskin jakauma: kenelle mittari antaa hälytyksen?

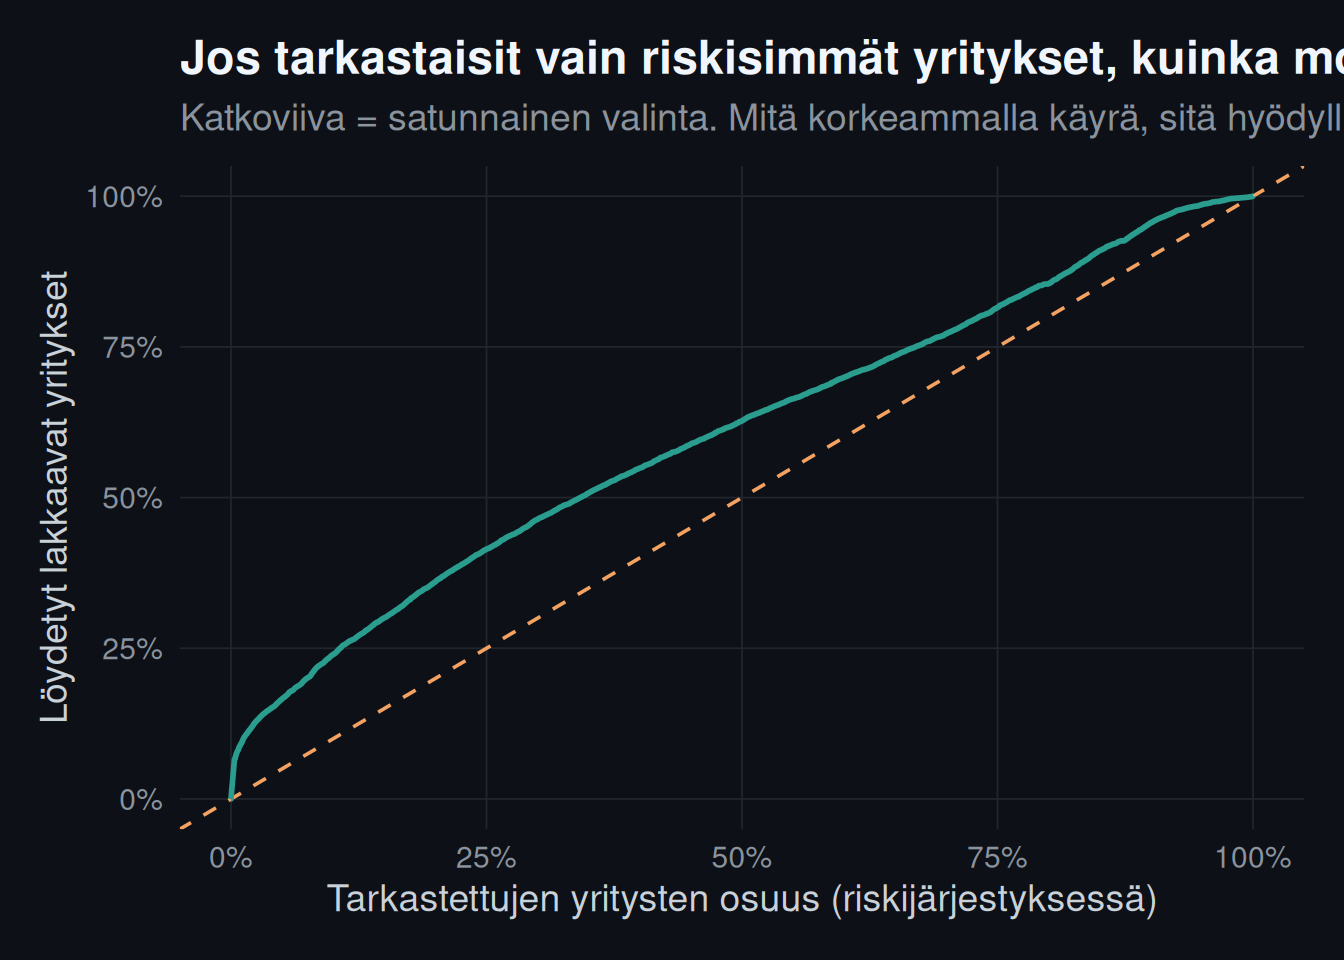
Lopuksi konkreettinen kysymys: miltä riskijakauma näyttää, ja mitä tapahtuu, jos
mittaria käyttäisi seulana?

```{r seula}
seula <- tibble(p = p_testi, y = as.integer(testi$lakkasi)) |>
  arrange(desc(p)) |>
  mutate(
    jarj = row_number(),
    osuus_yrityksista = jarj / n(),
    saatu_kiinni = cumsum(y) / sum(y)
  )

ggplot(seula, aes(osuus_yrityksista, saatu_kiinni)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed",
              color = kvar_palette[["orange"]]) +
  geom_line(color = kvar_palette[["teal"]], linewidth = 1) +
  scale_x_continuous(labels = scales::percent) +
  scale_y_continuous(labels = scales::percent) +
  labs(title = "Jos tarkastaisit vain riskisimmät yritykset, kuinka monta löytäisit?",
       subtitle = "Katkoviiva = satunnainen valinta. Mitä korkeammalla käyrä, sitä hyödyllisempi mittari.",
       x = "Tarkastettujen yritysten osuus (riskijärjestyksessä)",
       y = "Löydetyt lakkaavat yritykset")
```

Tämä kuvaaja on se, jonka riskipäällikkö haluaa nähdä. Se ei kysy "mikä on AUC"
vaan "jos resurssini riittää tarkastamaan 10 % salkusta, kuinka suuren osan
ongelmatapauksista löydän?"

## Miksi juuri tämä yritys? Syykoodit

Riskiluku yksin ei riitä päätökseen. Luotonantajan on kyettävä perustelemaan
sekä valvojalle että asiakkaalle, **miksi** yritys arvioitiin riskialttiiksi —
luottolainsäädäntö usein edellyttää tätä (ns. adverse action -perustelut).
Musta laatikko, joka antaa luvun mutta ei syytä, ei kelpaa.

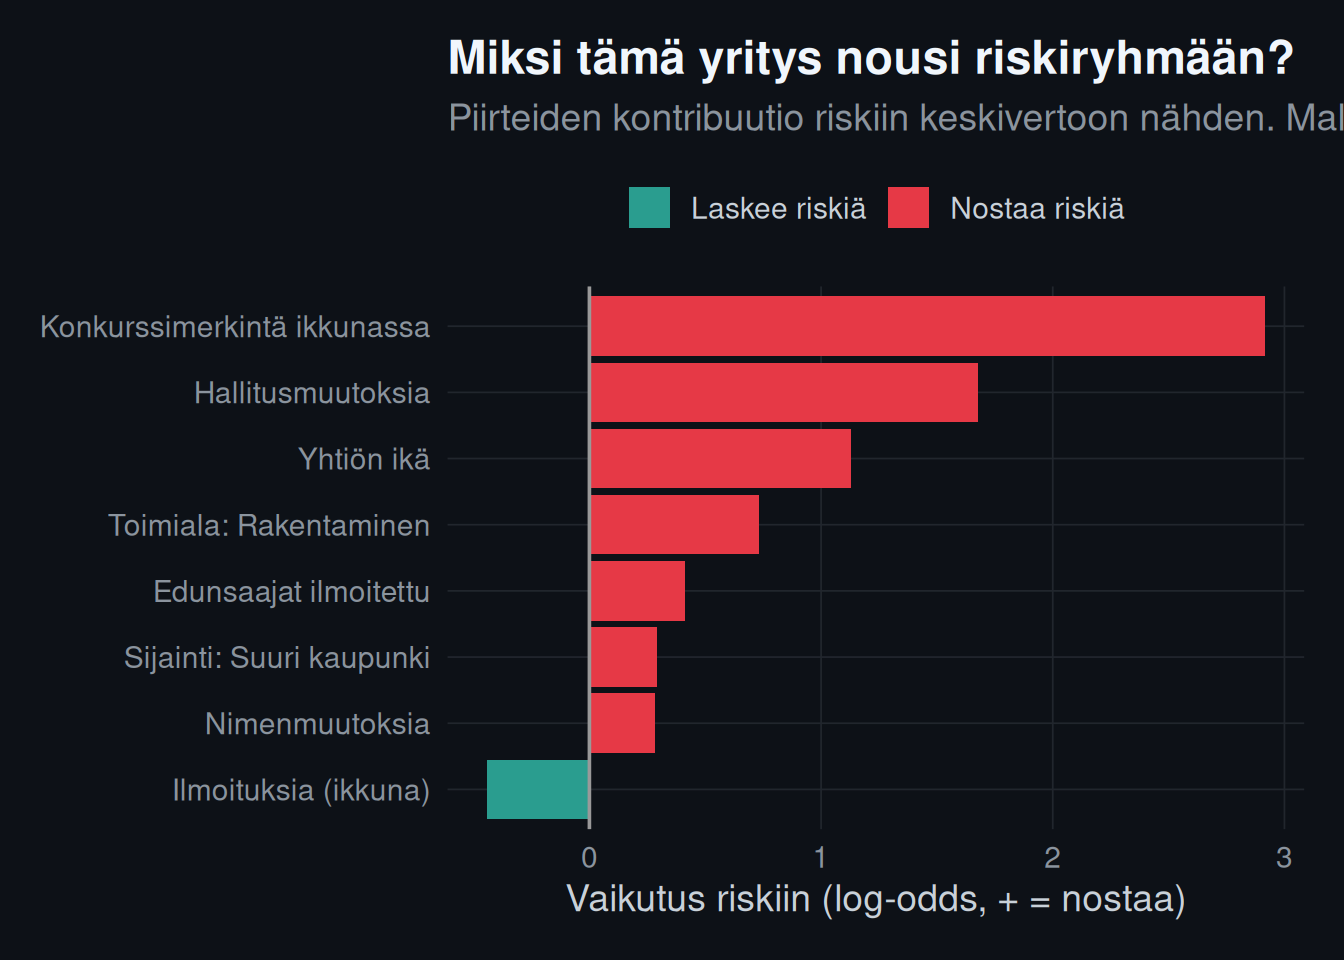
Logistinen malli mahdollistaa tämän suoraan. Yrityksen riski log-odds-asteikolla
on vakiotermi plus kunkin piirteen kerroin kerrottuna sen arvolla. Kun vähennämme
kustakin piirteestä populaation keskiarvon, saamme **syykoodit**: kuinka paljon
kukin piirre nostaa tai laskee *tämän* yrityksen riskiä keskivertoon nähden.

```{r syykoodit}
# Kertoimien posteriorin keskiarvot ja mallimatriisi
beta <- colMeans(as.matrix(fit))
mm   <- model.matrix(delete.response(terms(fit)), data = testi,
                     xlev = fit$xlevels)

# Kunkin piirteen keskimääräinen kontribuutio (vertailukohta = populaation keskiarvo)
keskiarvo_mm <- colMeans(mm)
kontribuutio <- function(rivi_mm) (rivi_mm - keskiarvo_mm) * beta

# Valitaan yksi selkeästi riskialtis yritys esimerkiksi
i <- which.max(p_testi)
osuudet <- kontribuutio(mm[i, ])
osuudet <- osuudet[names(osuudet) != "(Intercept)"]

syyt <- tibble::tibble(piirre = names(osuudet), vaikutus = as.numeric(osuudet)) |>
  filter(abs(vaikutus) > 1e-6) |>
  mutate(piirre = piirre |>
           str_replace("^sektori", "Toimiala: ") |>
           str_replace("^kaupunki", "Sijainti: ") |>
           str_replace("^ika", "Yhtiön ikä") |>
           str_replace("^n_ilm", "Ilmoituksia (ikkuna)") |>
           str_replace("^n_hallitus", "Hallitusmuutoksia") |>
           str_replace("^n_nimi", "Nimenmuutoksia") |>
           str_replace("^on_konalkTRUE", "Konkurssimerkintä ikkunassa") |>
           str_replace("^on_esrTRUE", "Edunsaajat ilmoitettu")) |>
  arrange(desc(abs(vaikutus))) |>
  slice_head(n = 8)

ggplot(syyt, aes(vaikutus, reorder(piirre, vaikutus), fill = vaikutus > 0)) +
  geom_col() +
  geom_vline(xintercept = 0, color = "grey60") +
  scale_fill_manual(values = c(`TRUE` = kvar_palette[["red"]],
                               `FALSE` = kvar_palette[["teal"]]),
                    labels = c(`TRUE` = "Nostaa riskiä", `FALSE` = "Laskee riskiä")) +
  labs(title = "Miksi tämä yritys nousi riskiryhmään?",
       subtitle = sprintf("Piirteiden kontribuutio riskiin keskivertoon nähden. Mallin ennuste: %.1f %% (perustaso %.1f %%).",
                          100 * p_testi[i], 100 * perusaste),
       x = "Vaikutus riskiin (log-odds, + = nostaa)", y = NULL, fill = NULL)
```

::: {.callout-tip}
## Miten syykoodeja luetaan — ja mitä ne eivät ole
Punaiset palkit ovat syitä, jotka nostavat *tämän* yrityksen riskiä keskivertoon
nähden; turkoosit laskevat sitä. Näin päätös voidaan perustella konkreettisesti:
"riski on koholla, koska ikkunassa on konkurssimerkintä ja toistuvia
hallitusmuutoksia, vaikka toimiala laskeekin riskiä."

Yksi rehellinen varaus: syykoodit kertovat, mikä *mallissa* nostaa riskiä, eivät
todellista syytä yrityksen tilaan. Ne ovat assosiaatioita, eivät diagnooseja.
Mutta juuri läpinäkyvyys — sen näyttäminen, mihin luku perustuu — erottaa
käyttökelpoisen riskimallin mustasta laatikosta.
:::

## Mitä tämä tarkoittaa päättäjälle?

Sarja päättyy sinne, mistä se alkoi: **avoin data ei ole leikkikalu.** Julkisesta
kaupparekisteristä — ilman maksullisia tietolähteitä, ilman sisäistä dataa,
ilman asiakastietoja — on rakennettavissa riskimittari, joka on validoitu
tulevaisuudella ja jonka epävarmuus on tiedossa.

Kolme asiaa, jotka erottavat käyttökelpoisen mallin näyttävästä:

Malli on testattu **ajallisesti**, ei satunnaisjaolla. Satunnaisjako olisi antanut
paremman tuloksen ja ollut merkityksetön.

Malli on **kalibroitu**, ei vain erotteleva. Luottopäätöksessä todennäköisyyden on
oltava totta, ei vain järjestyksen.

Malli on **selitettävissä ja suhteutettu**. Jokainen riskiluku tulkitaan
populaation perustasoa vasten — 11 % on korkea vain, koska keskiverto on 2,5 % —
ja jokainen yksittäinen arvio voidaan purkaa syykoodeiksi, jotka kertovat, mitkä
piirteet sen nostivat. Sekä vertailukohta että perustelu ovat useimmissa
rahoitusalan käyttötapauksissa ehdoton vaatimus, ei mukava lisä.

Ja lopuksi se, mistä koko sarja on kertonut: jokainen tämän mittarin tuottama luku
on jakauma, ei piste. Se on ainoa rehellinen tapa antaa numero, jonka varassa
tehdään päätöksiä toisten ihmisten rahasta.

---

*Tämä päättää YTJ-sarjan ensimmäisen kaaren. Rakennan organisaatioille
riskimalleja, jotka on validoitu rehellisesti ja jotka tuntevat oman
epävarmuutensa — vuokrattavana Head of Data -osaajana.
[kristianvepsalainen.com](https://www.kristianvepsalainen.com).*